
遇见数据集

Stopwolf/EQ-Bench-Serbian

收藏
Hugging Face2024-05-22 更新2024-04-19 收录
官方服务:

资源简介:

EQ-Bench-Serbian是一个用于评估语言模型情商的基准数据集。该数据集是基于英语EQ-Bench的翻译版本,主要用于塞尔维亚语,但也适用于波斯尼亚语和克罗地亚语。数据集通过OpenAI的GPT-3.5-turbo模型进行翻译,并经过人工清理和校正。该数据集旨在评估不同语言模型在处理塞尔维亚语时的情商表现。

EQ-Bench-Serbian is a benchmark dataset for evaluating the emotional intelligence of language models. This dataset is a translated adaptation based on the English EQ-Bench, primarily intended for Serbian while also being applicable to Bosnian and Croatian. It was translated using OpenAI's GPT-3.5-turbo model, followed by manual cleaning and correction. The dataset aims to assess the emotional intelligence performance of diverse language models when processing Serbian text.

提供机构:
Stopwolf
原始信息汇总

EQ-Bench-Serbian 🇷🇸

数据集概述

EQ-Bench-Serbian 是一个用于评估语言模型情感智能的基准数据集。该数据集主要针对塞尔维亚语,但也适用于波斯尼亚语和克罗地亚语。数据集通过 OpenAI 的 GPT-3.5-turbo 模型翻译,并进行了手动清理和校正。

数据集用途

该数据集用于评估语言模型在塞尔维亚语中的情感智能表现,可以用于比较不同模型在该语言上的性能。

数据集处理

数据集的评分方式是通过比例调整可解析答案的比例,以此来惩罚那些看似表现良好但实际上对塞尔维亚语掌握不佳的模型。

主要发现

  1. GPT4-turbo(0125-preview 版本)是目前评估模型中对塞尔维亚语表现最好的。
  2. 已有一些模型表现优于 GPT3.5-turbo(0125 版本)。
  3. YugoGPT-Chat-Align 出乎意料地得分很低。
  4. Perućac-7B-slerp(针对该基准测试的高分合并模型,WestLake-7B-v2 和 YugoGPT)确实得分较高,但其对塞尔维亚语的掌握程度存疑。
  5. 添加系统提示后,模型的表现预期会更好,但实际上表现更差。

后续工作

  • 添加其他 GPT 模型的得分,以比较不同模型的表现。
  • 添加其他封闭模型的得分,如 Gemini、Mistral-Large、Claude 等。
  • 添加可解析答案的百分比或某种知识度量标准,以区分不同模型(如原始 EQ Bench 中的 MAGI-Hard)。
搜集汇总
数据集介绍
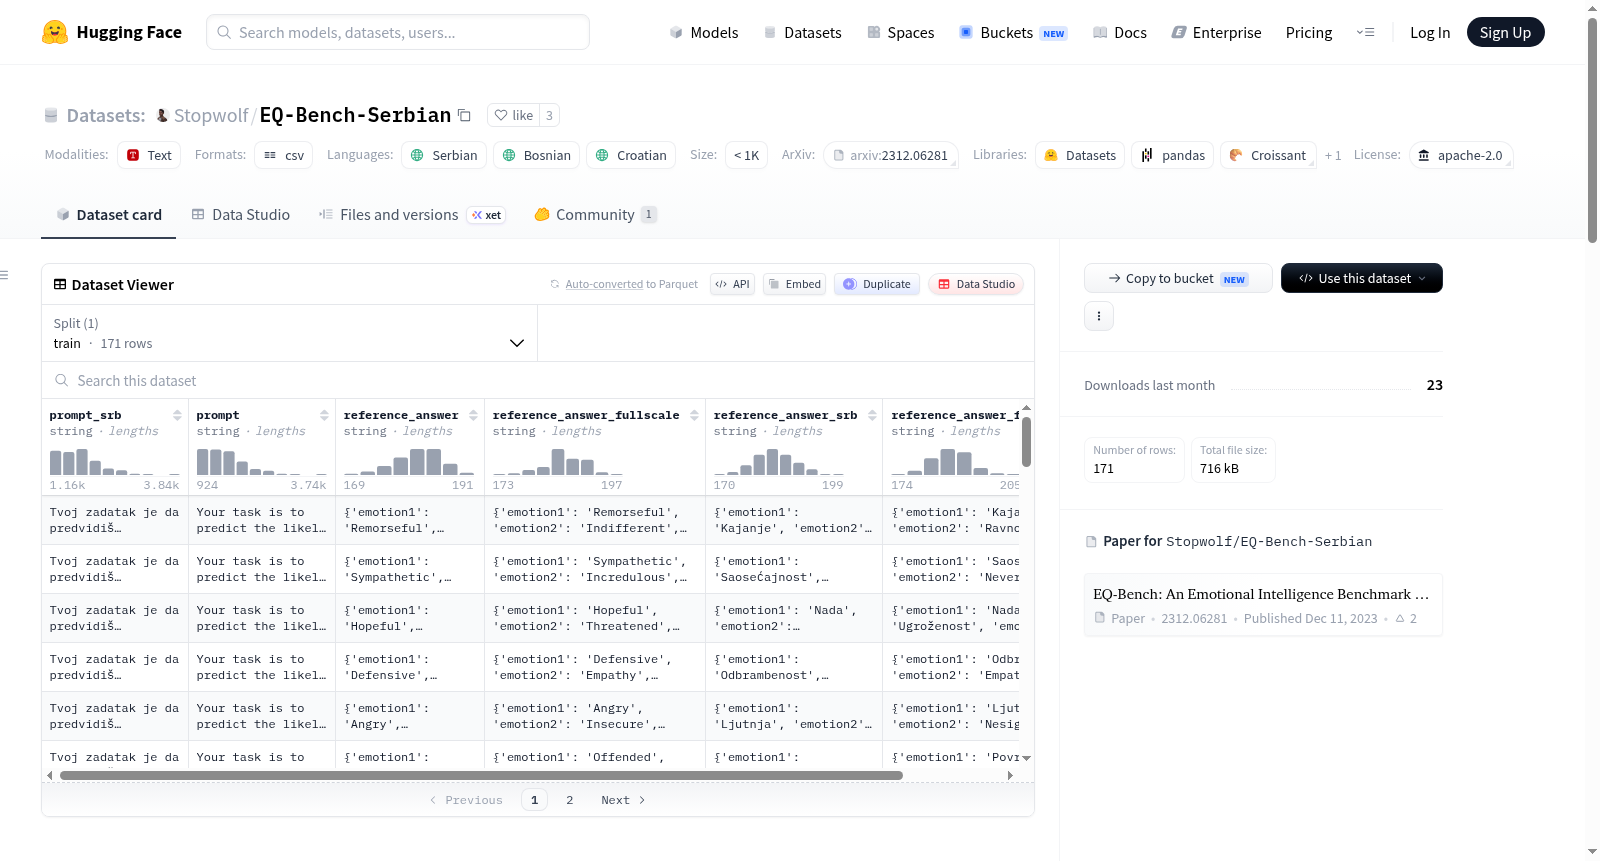
Stopwolf/EQ-Bench-Serbian 数据集图片
构建方式
EQ-Bench-Serbian数据集是基于英文EQ-Bench基准测试构建的,旨在评估语言模型在塞尔维亚语环境下的情感智能能力。该基准在英文场景中展现出与LMSYS Arena Elo评分的高度相关性(与MMLU相关系数达0.97,与Arena Elo相关系数为0.94)。鉴于为塞尔维亚语模型构建类似竞技场的不现实性,研究者转而采用翻译策略。原始英文数据通过OpenAI的GPT-3.5-turbo模型进行自动化翻译,随后经过人工精细清洗与修正,确保语义准确性与语言自然度。数据集主要面向塞尔维亚语,同时兼容波斯尼亚语和克罗地亚语的使用场景。
特点
该数据集的核心特点在于其独特的情感智能评估框架与语言适配机制。与原始EQ-Bench不同,本数据集采用首次通过得分与修订得分的比例缩放策略,而非简单取优,从而有效惩罚那些表面上表现优异但实际塞尔维亚语掌握不深的模型(即得分高但可解析答案比例低)。评估结果揭示了若干关键发现:GPT-4-turbo(0125预览版)在塞尔维亚语模型中表现最佳;部分开源模型已超越GPT-3.5-turbo;系统提示的加入并未如预期提升性能,反而导致得分下降,暗示模型对塞尔维亚语的初始聚焦可能干扰了其情感推理能力。
使用方法
使用该数据集时,研究者可直接加载HuggingFace上的Stopwolf/EQ-Bench-Serbian仓库,利用标准的情感智能评估流程对目标语言模型进行测试。数据集包含翻译后的问答对,需注意评估时采用缩放后的修订得分作为最终指标,而非简单比较首次通过与修订得分中的较高者。建议同时记录可解析答案比例,以辅助区分模型的语言理解能力与实际表现。对于塞尔维亚语、波斯尼亚语及克罗地亚语模型的评估,该数据集提供了统一的基准,但需确保模型具备基本的南斯拉夫语系理解能力。
背景与挑战
背景概述
EQ-Bench-Serbian 数据集由研究团队 Stopwolf 于2024年创建,旨在将评估语言模型情商能力的 EQ-Bench 基准拓展至塞尔维亚语(及波斯尼亚语、克罗地亚语)领域。由于原始 EQ-Bench 在英语中与 LMSYS Arena Elo 评分高度相关(与 MMLU 相关系数达0.97,与 Arena Elo 达0.94),而针对塞尔维亚语模型构建类似竞技场评估不切实际,该数据集应运而生。研究团队借助 GPT-3.5-turbo 完成翻译,并辅以人工清洗校正,为低资源语言的情感智能评估提供了关键工具。该数据集不仅填补了塞尔维亚语情感理解基准的空白,还通过其与主流英语基准的强关联性,为多语言语言模型的情商研究开辟了新路径,对推动小语种自然语言处理发展具有重要影响力。
当前挑战
该数据集面临多重挑战:首先,在领域问题层面,核心挑战是为塞尔维亚语等低资源语言构建可靠的情感智能评估基准,原始 EQ-Bench 的英语语境依赖需通过翻译与本地化适应,以确保文化情感表达的准确性。其次,构建过程中,翻译依赖 GPT-3.5-turbo 可能引入语义偏差,需大量人工校正以保证质量;同时,评估结果需处理模型对塞尔维亚语的“理解”与“掌握”差异——部分模型虽得分高但可解析答案比例低,揭示语言能力与情感判断间的复杂关系。此外,如何设计评分机制(如按可解析答案比例缩放分数)以公平惩罚伪精通模型,以及缺乏充足的高质量参考模型(如 GPT-4)进行对比,均构成显著挑战。
常用场景
经典使用场景
EQ-Bench-Serbian 数据集是情感智能评估领域的一项开创性资源,专为塞尔维亚语(及波斯尼亚语、克罗地亚语)设计。其最经典的使用场景在于衡量语言模型在非英语语境下的情绪理解与共情能力,通过翻译并人工修正自原版 EQ-Bench 的题目,构建了一套与人类偏好高度相关的评估体系。研究者利用该数据集对模型进行零样本测试,依据模型在“初答”与“修订”两轮中的可解析回答比例进行加权评分,从而精准捕捉模型对塞尔维亚语的掌握深度,而非仅依赖表面高分。这一范式为低资源语言的情感智能基准测试提供了可复现的范本,尤其适用于评估多语言模型的跨文化情感推理表现。
衍生相关工作
该数据集直接催生了一系列针对巴尔干语言的模型优化工作。例如,Perućac-7B-slerp 模型即是以在此基准上取得高分为目标,通过融合 WestLake-7B-v2 与 YugoGPT 的权重构建的专项合并模型。此外,Tito-7B、Zamfir-7B 和 Mustra-7B-Instruct 等模型均基于此数据集进行了评估与迭代,验证了情感智能基准对模型合并策略的指导作用。研究者还借鉴了原版 EQ-Bench 中的 MAGI-Hard 知识度量概念,计划引入可解析回答比例或知识指标以进一步区分模型的语言掌控力。这些工作共同推动了低资源语言模型评估从单纯的语言能力向情感与社会智能维度的拓展。
数据集最近研究
最新研究方向
EQ-Bench-Serbian 数据集的最新研究方向聚焦于多语言情境下大语言模型情感智能的评估与迁移。该基准通过将英文情感智能测试翻译并人工校对至塞尔维亚语、波斯尼亚语和克罗地亚语,开创性地解决了小语种模型评估的困境。其核心发现揭示了GPT-4 Turbo在巴尔干地区语言处理中的领先地位,同时验证了EQ-Bench与LMSYS Arena Elo评分的高度相关性(0.94),为缺乏竞技场评估的低资源语言提供了可靠替代方案。研究进一步探索了模型在情感理解与语言控制能力之间的权衡——通过可解析答案比例修正评分机制,有效区分了表面流畅与深层掌握语言的模型。这一方向不仅推动了多语言情感AI的发展,更为小语种NLP模型的标准化评估树立了新范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

