
DOS201X_highly_unbalanced
收藏官方服务:
资源简介:
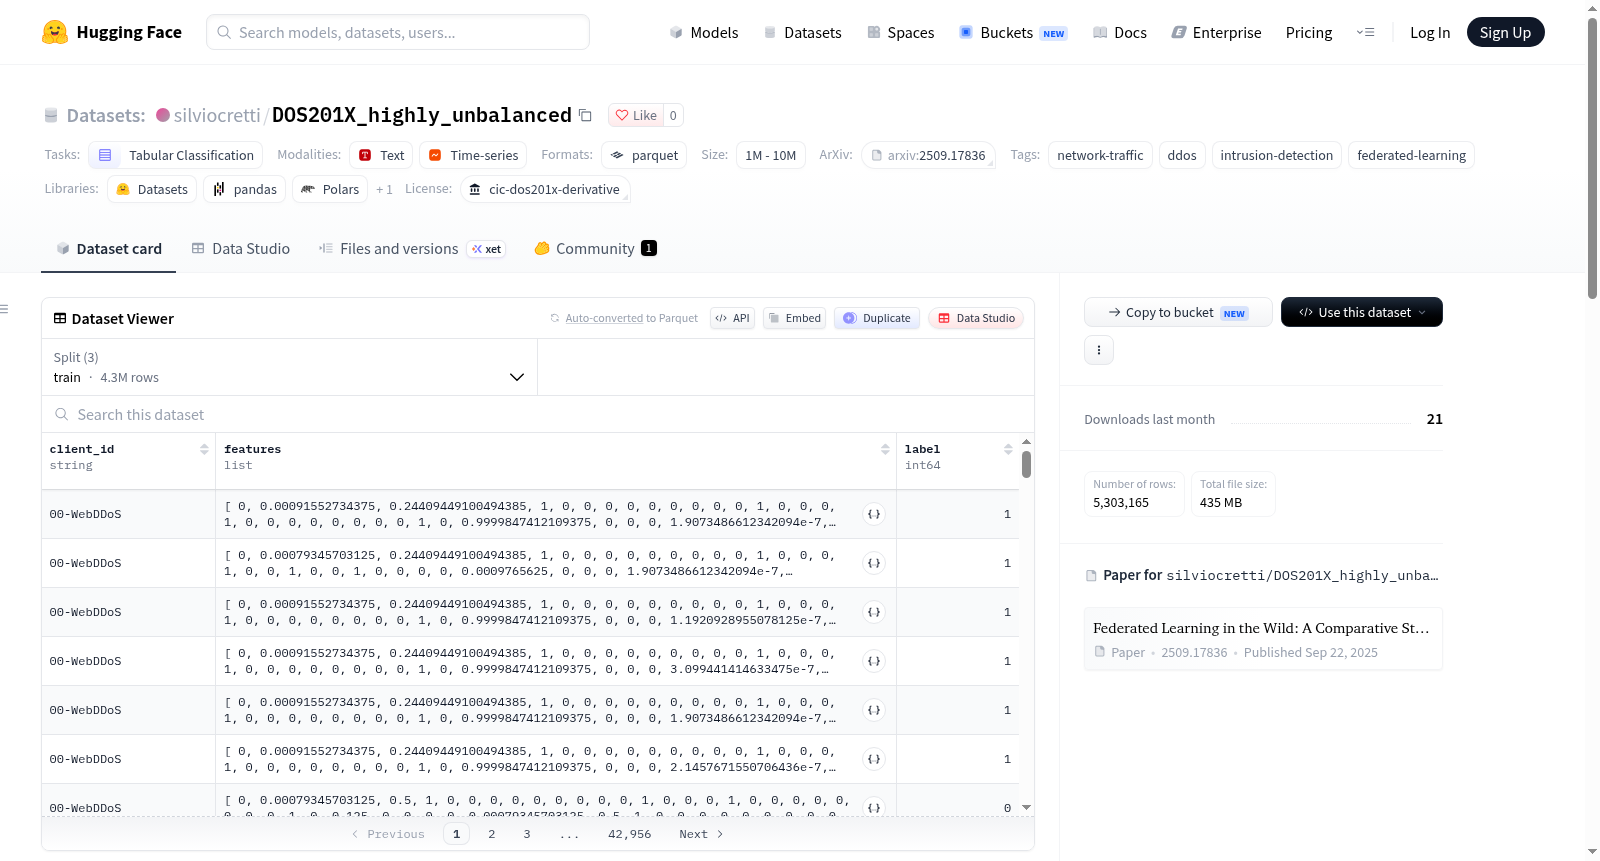
该数据集是为联邦学习(FL)环境下的DDoS攻击检测实验而专门准备的。它是基于加拿大网络安全研究所(CIC, University of New Brunswick)发布的CIC-DDoS2019、CIC-IDS2018和CIC-IDS2017数据集进行预处理和重新分区后得到的衍生版本。数据集被划分为15个客户端,每个客户端被分配一种攻击类型以及一部分良性流量,从而在客户端之间形成非独立同分布(non-IID)的网络流分布。这种划分方式旨在复现真实联邦学习场景,其中不同客户端仅能接触到不同的攻击类型,同时共享良性流量。数据集包含三个拆分:训练集(约80%)、验证集(约10%)和测试集(约10%),每个样本为一行,包含三列:client_id(字符串,表示样本所属的攻击类型/客户端分区,例如“11-NetBIOS”)、features(浮点数列表,展平的特征窗口,每个样本可重塑为10行×32列的原始布局)、label(整数,0表示良性,1表示恶意)。总体样本数量在100万到1000万之间。每个客户端内的样本经过平衡,使得良性样本与DDoS样本大致均衡;但由于每个客户端仅代表一种攻击类型,不同客户端/组之间的数据分布强烈非独立同分布。该数据集特别适用于联邦学习框架下的网络入侵检测、DDoS攻击检测以及非独立同分布数据场景的模型训练与评估。
创建时间:
2026-09-09
搜集汇总
数据集介绍
构建方式
该数据集立足于联邦学习框架下DDoS攻击检测的现实需求,以加拿大网络安全研究所发布的CIC-DDoS2019、CIC-IDS2018与CIC-IDS2017三大经典入侵检测语料库为源数据,经预处理与再划分衍生而成。构建过程中,网络流量以双向流为粒度被分配至15个客户端,每个客户端仅承载单一攻击类型的数据,同时混入一定比例的良性流量,从而在客户端层面形成非独立同分布的异构数据格局。原始HDF5格式数据经格式转换后统一存储为Parquet,并按约80%、10%、10%的比例划分训练集、验证集与测试集,最终形成规模介于百万至千万量级、高度不平衡的联邦学习基准数据集。
特点
该数据集最为显著的特质在于其高度不平衡与非独立同分布的双重属性:各客户端所持攻击类型彼此相异,仅良性流量为全局共享,致使客户端之间的标签分布呈现天然异质性。数据以扁平化特征窗口形式存储,每条样本涵盖10行32列的网络流特征,可通过重塑还原原始结构。标签采用二值编码,良性为0、恶意为1,简洁明晰。数据集预先按客户端分区,共涵盖15个客户端的三个数据划分,并附有网络流量解析工具的配套支持,为复现真实联邦场景中的异构挑战提供了便利条件。
使用方法
使用该数据集开展联邦学习实验时,研究者可依据client_id字段将数据分发至对应的模拟客户端,各客户端在本地独立训练模型后,经由联邦聚合机制交换参数更新而不共享原始流量数据。训练、验证与测试三个划分可直接载入,特征列需按(10,32)的维度重塑以恢复原始布局,标签列则用于二分类监督。由于各客户端数据分布差异显著,该方法适用于评估联邦算法在非独立同分布与类别不平衡条件下的鲁棒性与收敛性能,亦可作为入侵检测模型跨域泛化能力的检验基准。
背景与挑战
背景概述
分布式拒绝服务攻击(DDoS)检测是网络安全领域的核心议题,其数据基础长期依赖集中式采集与训练范式。加拿大纽布伦斯威克大学网络安全研究所(CIC)于2017至2019年间相继发布CIC-IDS2017、CIC-IDS2018与CIC-DDoS2019系列数据集,为入侵检测研究提供了大规模标注流量。DOS201X_highly_unbalanced数据集正是在此基础上衍生的联邦学习专用版本,将三类原始数据按攻击类型重新划分至15个客户端,形成高度非独立同分布的流量分区,以模拟真实联邦场景中各异构节点仅持有单一攻击类型与共享良性流量的数据格局,为联邦学习在网络安全中的应用提供了标准化实验基准。
当前挑战
该数据集所应对的领域问题在于:传统集中式DDoS检测模型依赖全局数据聚合,与现实中流量数据天然分散、且各节点攻击类型迥异的联邦场景相悖,如何在非独立同分布与类别不均衡并存的条件下实现高效协作检测成为关键难题。构建过程中的挑战则体现为:需将源自多个CIC数据集的异构HDF5流量记录统一解析、按攻击类型与客户端身份重新分区、确保各客户端内良性样本与单一攻击样本的均衡比例,同时维持跨客户端分布的强非独立同分布特性,并完成从HDF5到Parquet的格式转换与训练、验证、测试三划分的严格一致性,以保障联邦学习实验的可复现性。
常用场景
经典使用场景
在联邦学习驱动的网络入侵检测研究中,该数据集最经典的用途是模拟跨客户端的非独立同分布场景,以评估分布式DDoS攻击检测模型的鲁棒性。每个客户端仅持有单一攻击类型与部分良性流量,构成强烈的非独立同分布划分,恰好复现了现实网络中不同边缘节点遭遇异构攻击的态势。研究者可借此开展联邦训练与聚合策略的对比实验,检验模型在数据孤岛与类别偏斜下的泛化能力。
解决学术问题
该数据集有效回应了联邦学习场景下DDoS检测中数据异质性与类别不平衡并存的学术难题。传统集中式训练难以刻画多源异构攻击流量的分布差异,而该数据集通过预划分的十五个客户端,使研究者能够系统探究非独立同分布数据对全局模型收敛性与检测精度的影响。其意义在于为联邦入侵检测提供了可复现的基准,推动了隐私保护与攻击识别之间的平衡研究,并对不平衡学习与域适应方法在安全领域的应用具有启示价值。
衍生相关工作
围绕该数据集衍生的经典工作主要集中于联邦学习与网络安全的交叉领域。代表性研究如Doriguzzi-Corin等人发表的《Federated Learning in the Wild: A Comparative Study for Cybersecurity under Non-IID and Unbalanced Settings》,利用该数据集系统比较了多种联邦聚合算法在非独立同分布与不平衡条件下的检测性能。此外,该数据集亦被用于探索个性化联邦学习、客户端漂移校正及混合式入侵检测架构,逐步形成了以CIC系列数据为根基、面向联邦场景的衍生研究谱系。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


