asdwb/cara_latency_prediction
收藏资源简介:
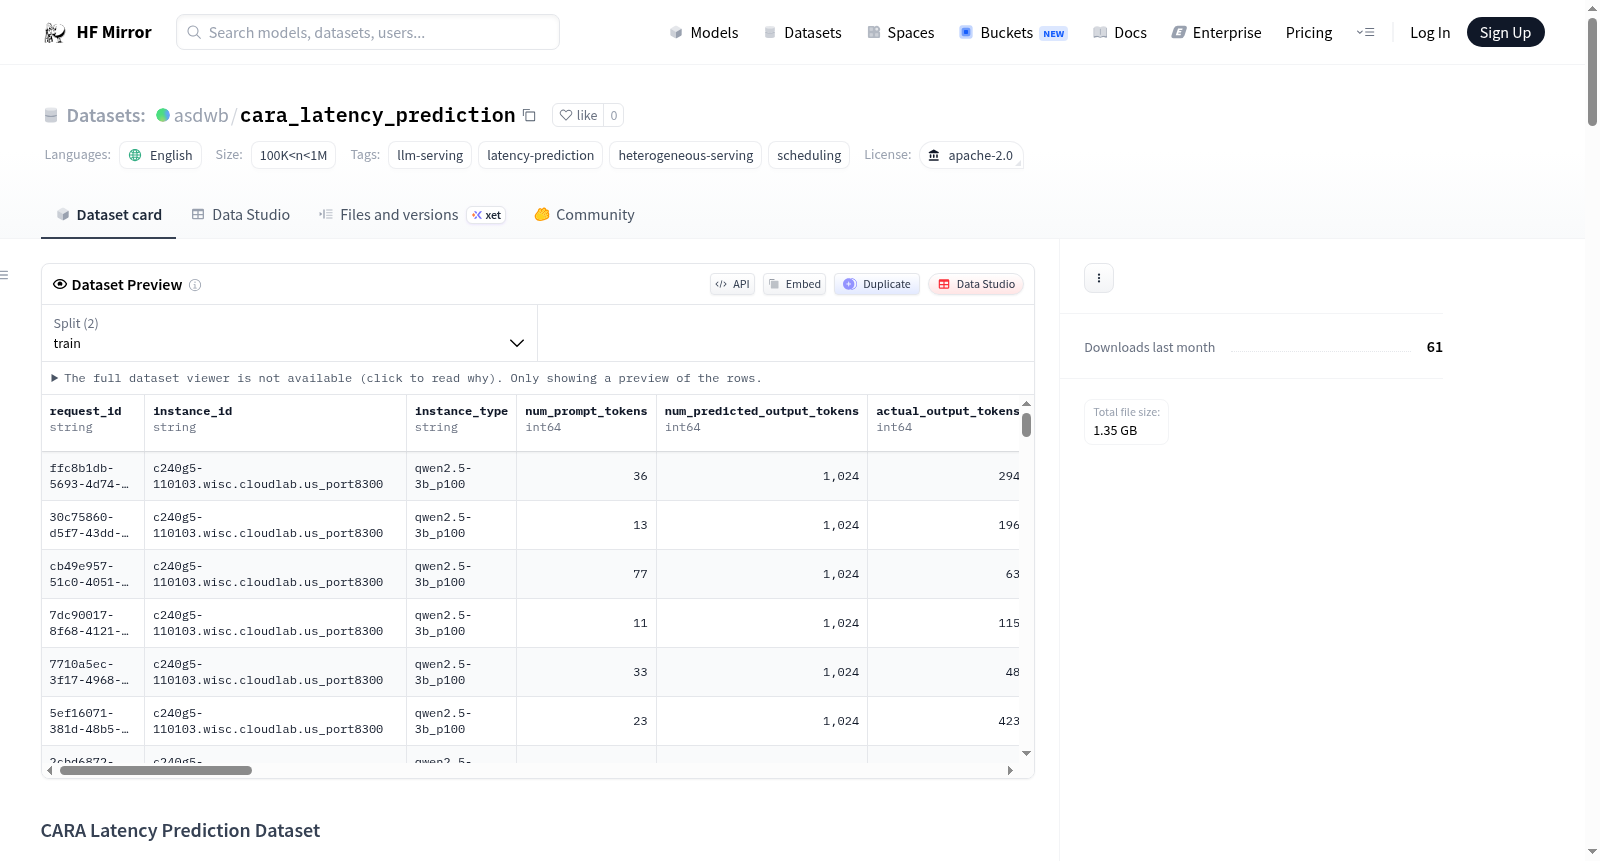
--- license: apache-2.0 language: - en tags: - llm-serving - latency-prediction - heterogeneous-serving - scheduling size_categories: - 100K<n<1M --- # CARA Latency Prediction Dataset A large-scale dataset for training latency predictors in heterogeneous LLM serving systems. Contains 404,258 request-level records from 18 model instances across 4 GPU types, collected under varying QPS levels (8-24). Data from sweep 2 (March 18-19, 2026) with no concurrency cap. ## Dataset Description Each record captures the **instance state at scheduling time** and the **actual end-to-end latency** after request completion. This enables training learned latency predictors that map observable system state to request latency — analogous to learned index structures in databases. ### Key Statistics | Split | Records | Prompts Source | QPS Range | Notes | |-------|---------|---------------|-----------|-------| | Train | 359,258 | cara_model_estimator train split | 8-24 | 671 records dropped (unresolvable queue entries) | | Test | 45,000 | cara_model_estimator test split | 8-24 | 0 dropped | ### Cluster Configuration 18 instances across 4 GPU types serving 4 Qwen2.5 model sizes: | Model | GPU | Instances | Tensor Parallel | vLLM Version | |-------|-----|-----------|----------------|--------------| | Qwen2.5-72B | A100 80GB x2 | 2 | 2 | cara_v_11 | | Qwen2.5-14B | V100 32GB x4 | 3 | 4 | cara_v_11 | | Qwen2.5-7B | A30 24GB | 5 | 1 | cara_v_11 | | Qwen2.5-3B | A30 24GB | 3 | 1 | cara_v_11 | | Qwen2.5-3B | P100 16GB | 5 | 1 | cara_v_11_p100 | ## Files **Updated April 2026**: Data replaced with clean sweep 2 collection (no concurrency cap). Queue detail files enriched with per-request `actual_output_tokens` via cross-referencing (99.96% match rate). | File | Records | Description | |------|---------|-------------| | `train.jsonl` | 359,258 | Training data, flat schema (schedule_state fields at top level) | | `test.jsonl` | 45,000 | Test data, flat schema | | `train_queue_details.jsonl` | 359,258 | Training data with per-request `running_requests[]` and `waiting_requests[]` + enriched `actual_output_tokens` | | `test_queue_details.jsonl` | 45,000 | Test data with per-request lists + enriched `actual_output_tokens` | ### Flat vs Queue Details - **Flat files** (`train.jsonl`, `test.jsonl`): Schedule state fields flattened to top level. Suitable for XGBoost and tabular models. - **Queue detail files**: Full nested `schedule_state` with per-request running/waiting lists. Each queue entry includes `actual_output_tokens` (enriched post-collection). Suitable for LSTM sequence models. ## Schema ### Flat records (`train.jsonl`, `test.jsonl`) **Identifiers:** - `request_id` (str): Unique request identifier (UUID) - `instance_id` (str): CloudLab hostname + port (e.g., `c240g5-110103.wisc.cloudlab.us_port8300`) - `instance_type` (str): Model + GPU type (e.g., `qwen2.5-3b_p100`) **Request features:** - `num_prompt_tokens` (int): Input prompt length in tokens - `num_predicted_output_tokens` (int): Max tokens parameter (1024 for all requests in this dataset) - `actual_output_tokens` (int): Actual generated output tokens (recovered via `round((e2e-ttft)/tpot)+1`) **Schedule state (from vLLM `/instance_stats` at scheduling time):** - `num_running` (int): Currently running requests on this instance - `num_waiting` (int): Queued requests (typically 0 — vLLM continuous batching absorbs load) - `num_active_decode_seqs` (int): Actively decoding sequences - `decode_ctx_p50/p95/max` (float): Decode context length percentiles (0 for some instances) - `pending_prefill_tokens` (int): Total pending prefill tokens (often 0) - `pending_decode_tokens` (int): Total pending decode tokens (0 for some instances) - `kv_cache_utilization` (float): KV cache usage fraction [0, 1] - `kv_free_blocks` (int): Available KV cache blocks - `token_budget_per_iter` (int): Scheduler token budget per iteration - `prefill_chunk_size` (int): Chunked prefill size - `max_num_seqs` (int): Max concurrent sequences allowed - `num_preempted` (int): Cumulative preemption count - `ema_decode_tok_per_s` (float): EMA decode throughput (tokens/sec) - `ema_prefill_tok_per_s` (float): EMA prefill throughput (tokens/sec) - `ema_decode_iter_ms` (float): EMA per-iteration decode latency (ms) - `kv_evictions_per_s` (float): KV cache eviction rate **Derived (flat files only):** - `running_requests_count` (int): Count from per-request list - `waiting_requests_count` (int): Count from per-request list **Overhead:** - `probe_latency_ms` (float): Time to fetch instance state from vLLM - `prediction_latency_ms` (float): Latency predictor inference time **Timestamps:** - `prediction_timestamp` (float): Unix time when scheduling decision was made - `completion_timestamp` (float): Unix time when request completed **Target labels:** - `actual_e2e_latency` (float): End-to-end latency in seconds (client-measured) - `actual_ttft` (float): Time to first token in seconds - `actual_tpot` (float): Mean time per output token in seconds (mean inter-token latency) ### Queue details (`train_queue_details.jsonl`, `test_queue_details.jsonl`) Full nested structure with `schedule_state` containing all aggregate fields plus per-request lists: - `schedule_state.running_requests[]` — per running request: - `request_id` (str): vLLM internal ID (`chatcmpl-` prefixed UUID) - `num_prompt_tokens` (int): Request's prompt length - `num_computed_tokens` (int): Tokens already processed (prefill progress) - `total_num_tokens` (int): Total allocated tokens at snapshot - `num_output_tokens` (int): Output tokens generated so far (0 during prefill) - `actual_output_tokens` (int): **Final output length** (enriched post-collection via cross-referencing request_ids, 99.96% match rate) - `schedule_state.waiting_requests[]` — same schema as running_requests ## Collection Method 1. Real prompts sampled from the [cara_model_estimator](https://huggingface.co/datasets/asdwb/cara_model_estimator) dataset 2. Sent through a coordinator with random scheduling to 18 heterogeneous instances 3. Sidecar on each instance captures (state, latency) pairs 4. Collected at 10 QPS levels (9-36) covering idle to saturated conditions 5. Train/test split aligned with cara_model_estimator splits (no prompt overlap) ## Intended Use - Training latency predictors for LLM serving schedulers (XGBoost, LSTM, neural networks) - Benchmarking simulation-based vs learned latency prediction - Studying heterogeneous LLM serving behavior across GPU types - Evaluating scheduling policies under different load conditions ### Enriched Queue Entry Fields (queue_details files) Each entry in `running_requests[]` and `waiting_requests[]` includes: | Field | Description | |-------|-------------| | `num_prompt_tokens` | Request's prompt length | | `num_computed_tokens` | Tokens already processed (prefill progress) | | `total_num_tokens` | Total sequence length at snapshot | | `num_output_tokens` | Output tokens generated so far | | `actual_output_tokens` | **Final output length** (enriched via cross-referencing request_ids) | ### Offline Evaluation Results (verified April 2026) | Model | E2E MAE | E2E MAPE | Spearman rho | |-------|---------|----------|-------------| | XGBoost (oracle output) | 0.289s | 3.7% | 0.999 | | Roofline (analytical) | 0.531s | 10.7% | 0.987 | | XGBoost TTFT | 0.015s | 16.2% | 0.946 | | XGBoost TPOT | 0.002s | 42.0% | 0.978 | ## Citation If you use this dataset, please cite: ```bibtex @dataset{cara_latency_2026, title={CARA Latency Prediction Dataset}, author={Wei Da}, year={2026}, url={https://huggingface.co/datasets/asdwb/cara_latency_prediction} } ``` ## Related - [cara_model_estimator](https://huggingface.co/datasets/asdwb/cara_model_estimator) — Multi-model quality and length estimation dataset - CARA: Context-Aware Resource Allocation for heterogeneous LLM serving
license: Apache-2.0许可证 language: - 英语 tags: - 大语言模型服务(LLM-serving) - 延迟预测(Latency-prediction) - 异构服务(Heterogeneous-serving) - 调度(Scheduling) size_categories: - 100K < n < 1M # CARA延迟预测数据集 本数据集为面向异构大语言模型(LLM)服务系统的延迟预测器训练提供大规模支撑,共包含404258条请求级记录,数据采集自4种GPU类型上的18个模型实例,采集时QPS(每秒查询率)范围为8至24。本次数据集来自2026年3月18日至19日的第二轮采集(Sweep 2),未设置并发上限。 ## 数据集描述 每条记录均记录了调度时刻的实例状态,以及请求完成后的实际端到端延迟(end-to-end latency)。借此可训练可观测系统状态到请求延迟的映射学习型延迟预测器,其设计思路与数据库中的学习型索引结构类似。 ### 关键统计 | 数据集划分 | 记录条数 | 提示源 | QPS范围 | 备注 | |-------|---------|---------------|-----------|-------| | 训练集 | 359,258 | cara_model_estimator 训练划分 | 8-24 | 丢弃671条无法解析的队列条目 | | 测试集 | 45,000 | cara_model_estimator 测试划分 | 8-24 | 无丢弃记录 | ### 集群配置 18个实例分布在4种GPU类型上,部署了4种尺寸的Qwen2.5模型: | 模型 | GPU配置 | 实例数量 | 张量并行度(Tensor Parallel) | vLLM版本 | |-------|-----|-----------|----------------|--------------| | Qwen2.5-72B | A100 80GB x2 | 2 | 2 | cara_v_11 | | Qwen2.5-14B | V100 32GB x4 | 3 | 4 | cara_v_11 | | Qwen2.5-7B | A30 24GB | 5 | 1 | cara_v_11 | | Qwen2.5-3B | A30 24GB | 3 | 1 | cara_v_11 | | Qwen2.5-3B | P100 16GB | 5 | 1 | cara_v_11_p100 | ## 文件 **2026年4月更新**:本次数据集已替换为干净的第二轮采集数据(未设置并发上限)。队列详情文件已通过交叉引用补充了每条请求的`actual_output_tokens`(实际输出Token数)字段,匹配率达99.96%。 | 文件 | 记录条数 | 描述 | |------|---------|-------------| | `train.jsonl` | 359,258 | 训练数据,采用扁平化结构(调度状态字段位于顶层),适用于XGBoost与表格模型 | | `test.jsonl` | 45,000 | 测试数据,采用扁平化结构 | | `train_queue_details.jsonl` | 359,258 | 训练数据,包含每条请求的`running_requests[]`与`waiting_requests[]`列表,以及补充的`actual_output_tokens`字段 | | `test_queue_details.jsonl` | 45,000 | 测试数据,包含每条请求的列表与补充的`actual_output_tokens`字段 | ### 扁平化结构与队列详情的区别 - **扁平化文件**(`train.jsonl`、`test.jsonl`):调度状态字段扁平化至顶层,适用于XGBoost与表格模型。 - **队列详情文件**:包含完整的嵌套`schedule_state`结构,以及每条请求的运行/等待队列列表,每个队列条目均包含`actual_output_tokens`(采集后补充的字段),适用于LSTM序列模型。 ## Schema ### 扁平化记录(`train.jsonl`、`test.jsonl`) #### 标识符字段: - `request_id`(字符串):唯一请求标识符(UUID) - `instance_id`(字符串):CloudLab主机名加端口(例如`c240g5-110103.wisc.cloudlab.us_port8300`) - `instance_type`(字符串):模型与GPU类型组合(例如`qwen2.5-3b_p100`) #### 请求特征字段: - `num_prompt_tokens`(整数):输入提示的Token长度 - `num_predicted_output_tokens`(整数):最大生成Token数(本数据集所有请求均为1024) - `actual_output_tokens`(整数):实际生成的输出Token数(通过公式`round((e2e-ttft)/tpot)+1`计算恢复) #### 调度状态(来自vLLM的`/instance_stats`接口,采集于调度时刻): - `num_running`(整数):当前实例上正在运行的请求数 - `num_waiting`(整数):排队请求数(通常为0,vLLM连续批处理机制可实现负载均衡) - `num_active_decode_seqs`(整数):正在主动解码的序列数 - `decode_ctx_p50/p95/max`(浮点数):解码上下文长度的分位数(部分实例为0) - `pending_prefill_tokens`(整数):待处理的预填充Token总数(通常为0) - `pending_decode_tokens`(整数):待处理的解码Token总数(部分实例为0) - `kv_cache_utilization`(浮点数):KV缓存使用率,取值范围[0, 1] - `kv_free_blocks`(整数):可用的KV缓存块数 - `token_budget_per_iter`(整数):调度器每次迭代的Token预算 - `prefill_chunk_size`(整数):分块预填充的大小 - `max_num_seqs`(整数):允许的最大并发序列数 - `num_preempted`(整数):累计的请求抢占次数 - `ema_decode_tok_per_s`(浮点数):指数移动平均(EMA)解码吞吐量(Token/秒) - `ema_prefill_tok_per_s`(浮点数):指数移动平均(EMA)预填充吞吐量(Token/秒) - `ema_decode_iter_ms`(浮点数):指数移动平均(EMA)每轮迭代解码延迟(毫秒) - `kv_evictions_per_s`(浮点数):KV缓存驱逐速率 #### 仅扁平化文件包含的派生字段: - `running_requests_count`(整数):从请求列表中统计的运行请求数 - `waiting_requests_count`(整数):从请求列表中统计的等待请求数 #### 开销字段: - `probe_latency_ms`(浮点数):从vLLM获取实例状态的耗时(毫秒) - `prediction_latency_ms`(浮点数):延迟预测器的推理耗时(毫秒) #### 时间戳字段: - `prediction_timestamp`(浮点数):做出调度决策时的Unix时间 - `completion_timestamp`(浮点数):请求完成时的Unix时间 #### 目标标签: - `actual_e2e_latency`(浮点数):端到端延迟(秒,客户端测量值) - `actual_ttft`(浮点数):首令牌生成时间(Time to First Token, TTFT)(秒) - `actual_tpot`(浮点数):平均每输出令牌耗时(Time Per Output Token, TPOT)(秒,平均令牌间延迟) ### 队列详情记录(`train_queue_details.jsonl`、`test_queue_details.jsonl`) 完整的嵌套结构,`schedule_state`包含所有聚合字段,以及每条请求的列表: - `schedule_state.running_requests[]` — 每条运行中的请求,包含以下字段: - `request_id`(字符串):vLLM内部ID(以`chatcmpl-`为前缀的UUID) - `num_prompt_tokens`(整数):请求的提示长度 - `num_computed_tokens`(整数):已处理的Token数(预填充进度) - `total_num_tokens`(整数):快照时刻分配的总序列长度 - `num_output_tokens`(整数):当前已生成的输出Token数(预填充阶段为0) - `actual_output_tokens`(整数):最终输出长度(采集后通过交叉引用请求ID补充的字段,匹配率99.96%) - `schedule_state.waiting_requests[]` — 字段结构与`running_requests[]`完全一致 ## 采集方法 1. 真实提示样本取自[cara_model_estimator](https://huggingface.co/datasets/asdwb/cara_model_estimator)数据集 2. 通过协调器将请求随机调度至18个异构实例 3. 每个实例的侧车程序采集(实例状态,延迟)对 4. 以10个QPS层级(9-36)采集数据,覆盖从空闲到饱和的全部工况 5. 训练/测试划分与cara_model_estimator的划分对齐,无提示重叠 ## 预期用途 - 训练大语言模型服务调度器的延迟预测器(可使用XGBoost、LSTM、神经网络等模型) - 开展基于仿真与基于学习的延迟预测方法的基准对比测试 - 研究异构大语言模型服务在不同GPU类型下的运行行为 - 在不同负载条件下评估调度策略的性能 ### 补充的队列条目字段(队列详情文件) `running_requests[]`与`waiting_requests[]`中的每个条目均包含以下字段: | 字段 | 描述 | |-------|-------------| | `num_prompt_tokens` | 请求的提示长度 | | `num_computed_tokens` | 已处理的Token数(预填充进度) | | `total_num_tokens` | 快照时刻分配的总序列长度 | | `num_output_tokens` | 当前已生成的输出Token数 | | `actual_output_tokens` | 最终输出长度(采集后通过交叉引用请求ID补充的字段) | ### 离线评估结果(2026年4月验证) | 模型 | 端到端平均绝对误差(E2E MAE) | 端到端平均绝对百分比误差(E2E MAPE) | 斯皮尔曼秩相关系数(Spearman rho) | |-------|---------|----------|-------------| | XGBoost(神谕输出) | 0.289s | 3.7% | 0.999 | | 屋顶线(Roofline)分析模型 | 0.531s | 10.7% | 0.987 | | XGBoost(TTFT预测) | 0.015s | 16.2% | 0.946 | | XGBoost(TPOT预测) | 0.002s | 42.0% | 0.978 | ## 引用 若使用本数据集,请引用以下BibTeX条目: bibtex @dataset{cara_latency_2026, title={CARA Latency Prediction Dataset}, author={Wei Da}, year={2026}, url={https://huggingface.co/datasets/asdwb/cara_latency_prediction} } ## 相关资源 - [cara_model_estimator](https://huggingface.co/datasets/asdwb/cara_model_estimator) — 多模型质量与长度估计数据集 - CARA:面向异构大语言模型服务的上下文感知资源分配(Context-Aware Resource Allocation)