
louisbrulenaudet/code-sante-publique
收藏官方服务:
资源简介:
该数据集名为Code de la santé publique,专注于通过微调预训练语言模型来创建高效且准确的法律实践模型。数据集包含法国公共卫生法典的法律文本,通过指令微调生成法律条文的文本内容。数据集的结构为JSON格式,每个条目包含指令、输入、输出、生效日期、过期日期和文章编号等信息。
该数据集名为Code de la santé publique,专注于通过微调预训练语言模型来创建高效且准确的法律实践模型。数据集包含法国公共卫生法典的法律文本,通过指令微调生成法律条文的文本内容。数据集的结构为JSON格式,每个条目包含指令、输入、输出、生效日期、过期日期和文章编号等信息。
提供机构:
louisbrulenaudet原始信息汇总
数据集概述
基本信息
- 许可证: Apache 2.0
- 语言: 法语
- 多语言性: 单语种
- 标签: 微调, 法律, 法国法律, 法国公共卫生法, 公共卫生法典
- 数据来源: 原始数据
- 数据集名称: 公共卫生法典
- 任务类别: 文本生成, 表格问答, 摘要, 文本检索, 问答, 文本分类
- 数据规模: 1K<n<10K
数据集生成
-
字段:
instruction: 字符串,与元素相关的指令。input: 字符串,元素的输入细节。output: 字符串,元素的输出信息。start: 字符串,文章生效日期。expiration: 字符串,文章失效日期。num: 字符串,文章的ID。
-
生成指令:
- 数据集生成使用了以下指令列表: python instructions = [ "Compose lintégralité de larticle sous forme écrite.", "Écris la totalité du contenu de larticle.", # ... 其他指令 ]
搜集汇总
数据集介绍
构建方式
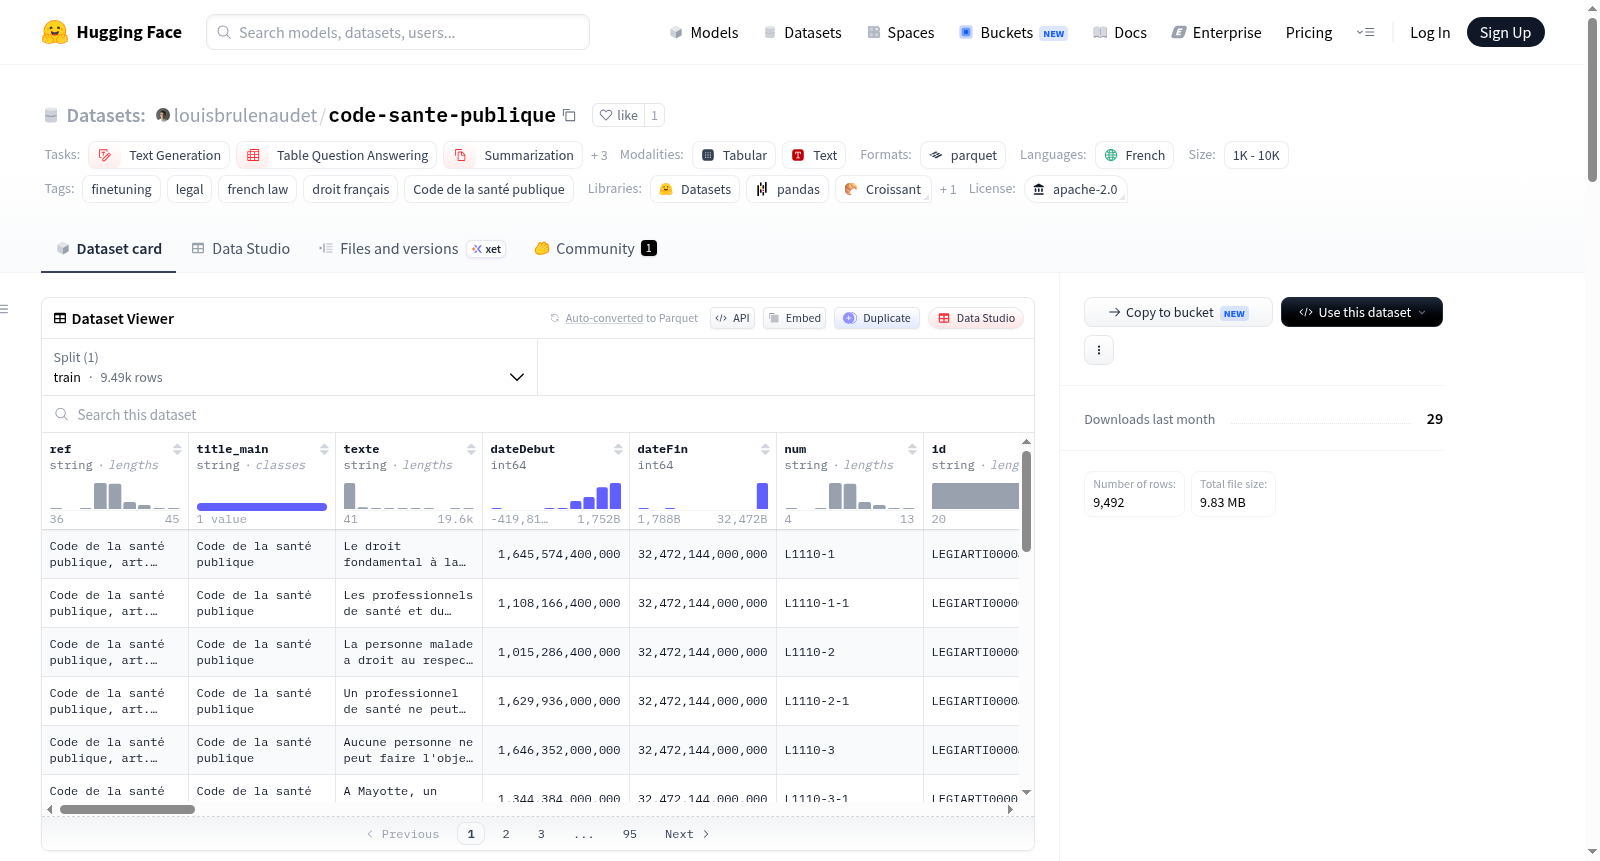
该数据集名为Code de la santé publique(公共卫生法典),由Louis Brulenaudet创建,旨在为研究人员、专业人士和法律学生提供对法国全部法律文本的简化且及时更新的访问。数据集基于原始数据构建,每日刷新,涵盖了法国公共卫生法典的全部法律条文。每条记录均以字典形式组织,包含丰富的元数据字段,如文章编号、生效与终止日期、法律状态、版本信息、层级关系(如父章节ID与标题)、HTML格式内容、官方公报编号及历史修订记录等。数据来源为LEGI(法国官方法律数据库),确保了法律文本的权威性和时效性。
特点
该数据集具有多维度、高结构化的特点。每条法律条文均包含超过20个元数据字段,覆盖基本信息(如参考编号、文本内容)、版本控制(如前版标识、技术注入ID)、层级关系(如父章节链标题)、扩展信息(如扩展起止日期)及附加内容(如备注、历史记录)。数据以非指令(non-instruct)格式存储,适用于多种自然语言处理任务,包括文本生成、表格问答、摘要、检索、问答及分类。此外,数据集规模适中(1000至10000条),便于高效处理,且采用Apache-2.0开源许可,支持社区使用与二次开发。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,例如使用`load_dataset("louisbrulenaudet/code-sante-publique")`命令。为简化多法典数据的整合,推荐使用RAGoon工具包:通过`pip3 install ragoon`安装后,调用`ragoon.load_datasets`函数可批量加载包括本数据集在内的多个LegalKit系列数据集,并利用`datasets.concatenate_datasets`合并处理。每条数据以字典形式返回,用户可根据`ref`、`texte`、`dateDebut`等键访问具体字段,灵活适配法律文本分析、模型微调或知识检索等下游任务。
背景与挑战
背景概述
在法国法律体系数字化进程中,公共健康法典作为规范医疗卫生领域的基础性法规,其条文检索与理解对法律从业者、研究人员及公众至关重要。由Louis Brulenaudet主导创建的louisbrulenaudet/code-sante-publique数据集,于2025年7月11日发布,依托LegalKit平台每日更新,旨在为社区与欧洲项目提供开源、结构化的法语法律文本数据。该数据集聚焦于法国公共健康法典的非指令版本,通过精细化标注文章元数据(如生效日期、法律状态、层级关系等),解决了传统法律文本分散、格式不统一的核心问题,为文本生成、问答、摘要等自然语言处理任务奠定了高质量数据基础,推动了法律人工智能在法语区域的落地应用。
当前挑战
该数据集面临多重挑战:首先,在领域问题层面,公共健康法典条文频繁修订,不同版本间的法律效力与时间跨度差异显著,如何确保数据集的实时更新与历史版本追溯的准确性,是维持其法律权威性的关键。其次,构建过程中,从法国官方法律库(LEGI)爬取原始文本时,需处理复杂的HTML结构与多层级嵌套引用关系,例如文章间的交叉索引(renvoi)和附属条款(nota),这对解析算法的鲁棒性提出极高要求。此外,数据集中包含的字段如‘conditionDiffere’(延期条件)和‘infosRestructurationBranche’(分支重组信息)具有领域特异性,需设计专门的提取与验证流程,避免信息丢失或语义歧义,从而保证下游模型训练数据的可靠性。
常用场景
经典使用场景
该数据集汇聚了法国《公共卫生法典》的全部法律条文,为自然语言处理领域提供了高度结构化的法语法律文本资源。其经典使用场景集中于文本生成与摘要任务,研究者可借助此数据集微调语言模型,使其能够依据法律条款自动生成符合法国法律逻辑的文本摘要或法律意见,从而提升模型在专业法律语境下的语义理解与生成能力。
解决学术问题
在学术研究中,该数据集有效解决了法语法律文本数字化程度不足、语料稀缺且版本更新滞后等关键问题。它为法律信息检索、问答系统及文本分类等研究方向提供了标准化、每日更新的数据基础,使研究者能够探索法律条文间的语义关联、时间演化规律及条款层级结构,推动了计算法学与自然语言处理交叉领域的实证研究进展。
衍生相关工作
基于该数据集,衍生出多项经典工作,包括利用RAGoon工具实现多法典数据集的联合加载与融合分析,以及构建面向法国法律体系的检索增强生成(RAG)系统。这些工作进一步开发了针对法律文本的语义索引与段落级检索技术,为跨法典的法规交叉引用和知识图谱构建奠定了方法论基础,促进了开源法律语言模型的生态发展。
以上内容由遇见数据集搜集并总结生成


