
prophet-mosque-library-compressed
收藏官方服务:
资源简介:
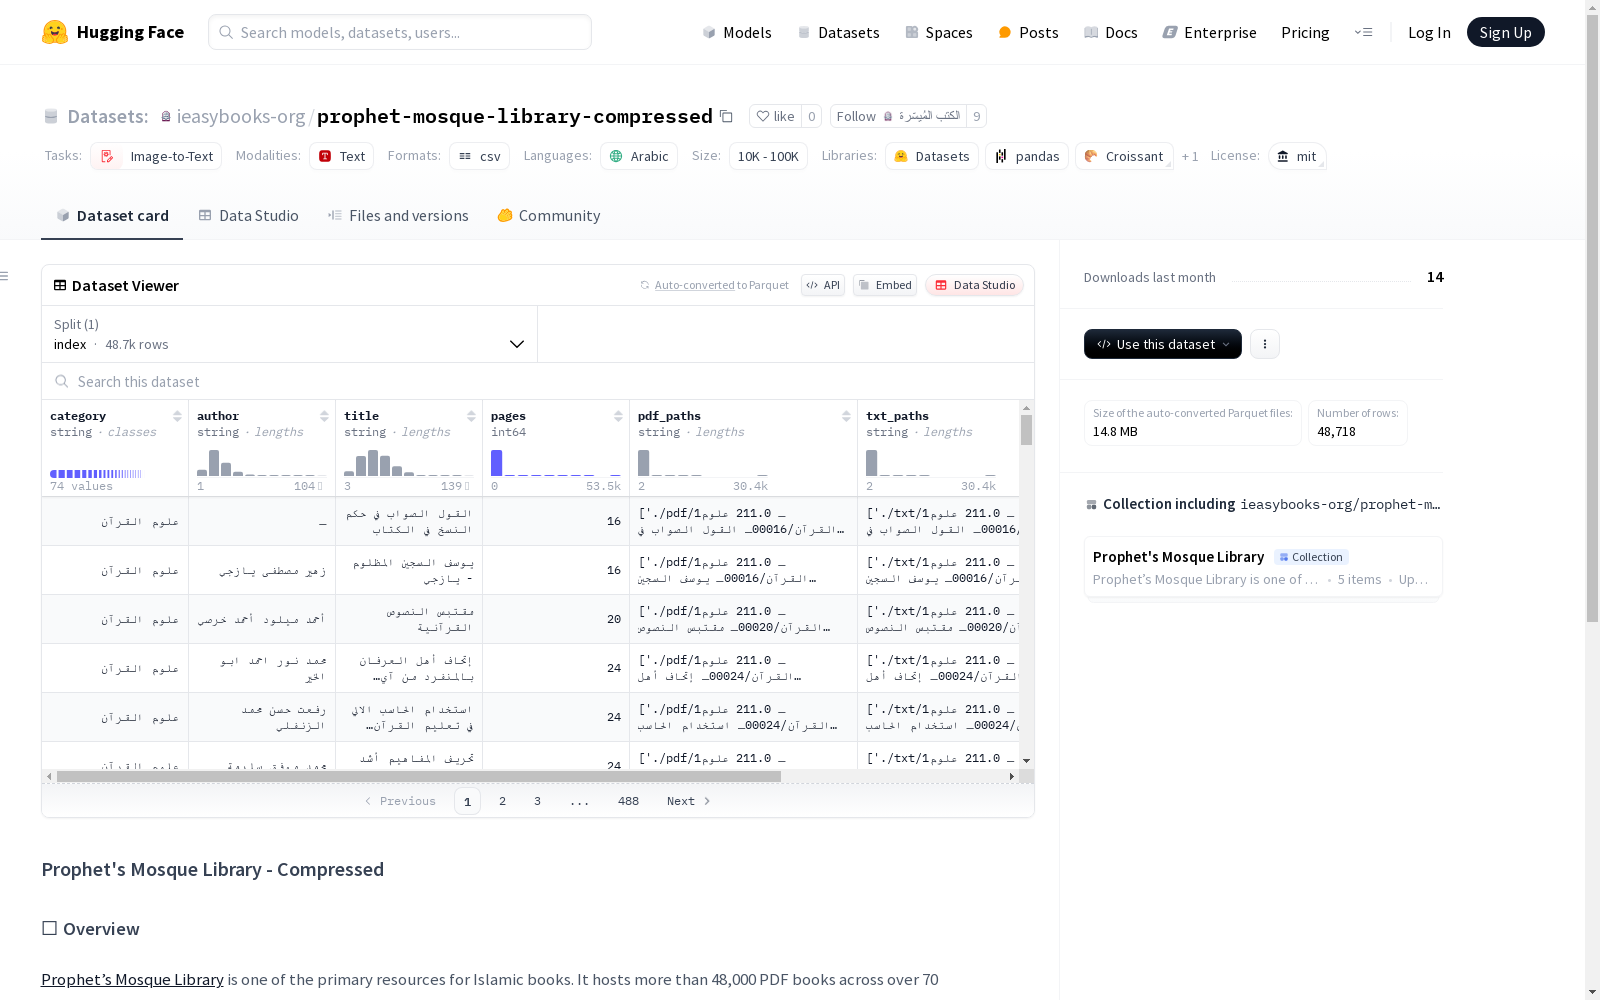
Prophet's Mosque Library - Compressed数据集是经过压缩处理的一个伊斯兰书籍资源库,包含了超过48,000本PDF格式的书籍,这些书籍被处理转换成了TXT和DOCX两种格式,并分为70多个分类。该数据集是为了方便用户下载而进行了压缩。
The Prophet's Mosque Library - Compressed dataset is a compressed Islamic book resource library. It contains over 48,000 books in PDF format, which have been converted to both TXT and DOCX formats, and is divided into more than 70 categories. This dataset has been compressed to facilitate user downloads.
创建时间:
2025-05-05
原始信息汇总
Prophets Mosque Library - Compressed 数据集概述
📜 基本信息
- 许可证: MIT
- 任务类别: 图像到文本 (image-to-text)
- 语言: 阿拉伯语 (ar)
- 数据集名称: Prophets Mosque Library - Compressed
- 规模分类: 10K < n < 100K
📂 数据集内容
- 原始来源: Prophet’s Mosque Library 是伊斯兰书籍的主要资源之一,包含超过48,000本PDF书籍,涵盖70多个类别。
- 处理内容: 使用Google Document AI API处理原始PDF文件,提取内容为TXT和DOCX格式。
- 压缩内容:
pdf.zip: 包含原始PDF文件的压缩包txt.zip: 包含提取的TXT文件的压缩包docx.zip: 包含提取的DOCX文件的压缩包
- 其他文件: 其余数据集PDF文件存在于 ieasybooks-org/prophet-mosque-library-compressed-cont
🔗 相关链接
搜集汇总
数据集介绍
构建方式
该数据集源自先知清真寺图书馆的丰富藏书资源,该图书馆作为伊斯兰文献的重要典藏机构,收录了超过48,000册PDF格式的书籍,涵盖70余个学科门类。研究者运用Google Document AI技术对原始PDF文件进行智能化处理,通过光学字符识别和文本解析技术,将文献内容精准提取为结构化的TXT和DOCX格式。为优化数据存储效率,所有文件经过压缩处理后形成标准化数据包,显著降低了下载和传输的硬件需求。
使用方法
研究者可通过解压提供的ZIP压缩包获取三种格式的文献资源,PDF文件适用于传统阅读场景,TXT文本可直接导入自然语言处理工具进行词频统计或主题建模,DOCX格式则方便学者进行注释和编辑。为深入理解数据组织结构,建议用户参考原始数据集的详细文档。该数据集特别适合用于伊斯兰文献数字化研究、阿拉伯语自然语言处理模型训练以及跨宗教文化比较分析等学术场景。
背景与挑战
背景概述
先知清真寺图书馆数据集(Prophet's Mosque Library - Compressed)源于伊斯兰文化研究领域对数字化古籍资源的迫切需求。该数据集由ieasybooks机构于近年整理发布,核心内容源自沙特阿拉伯先知清真寺图书馆馆藏的48,000余册阿拉伯语PDF书籍,涵盖70多个伊斯兰学科分类。作为伊斯兰文献数字化的代表性成果,该数据集通过Google Document AI技术实现了PDF文本的结构化提取,并衍生出TXT和DOCX两种标准化格式,为伊斯兰教义研究、阿拉伯语自然语言处理等跨学科领域提供了珍贵的语料资源。
当前挑战
该数据集面临双重技术挑战:在领域问题层面,阿拉伯语复杂的右向书写系统和丰富的词形变化对文本识别与机器翻译模型构成显著障碍,古籍中存在的特殊书法变体更增加了字符识别的误差率;在构建过程中,原始PDF文件的非标准化排版(如多栏文本、插图嵌入)导致文档解析困难,而48,000册书籍的批量处理需要解决分布式计算资源分配与输出格式一致性控制等工程难题。压缩版本的存储方案虽提升下载便利性,但需权衡文件完整性校验与存储效率之间的平衡。
常用场景
经典使用场景
在伊斯兰文献数字化研究领域,Prophet's Mosque Library - Compressed数据集为学者提供了高效获取经典文本的途径。该数据集通过将4.8万册阿拉伯语伊斯兰书籍转化为结构化文本,支持大规模文本挖掘与分析,特别适用于古兰经注释比较、圣训学研究和伊斯兰法学文献分析等场景。压缩后的文件格式显著降低了海量文本数据的传输与存储门槛。
解决学术问题
该数据集有效解决了伊斯兰文献研究中的三大瓶颈:原始PDF难以机器处理、阿拉伯语OCR精度不足、跨格式文本统一分析困难。通过Google Document AI实现的标准化转换,使研究者能专注于语义分析而非数据清洗,为计量文献学、知识图谱构建提供了高质量语料,尤其促进了阿拉伯古籍数字化保护与跨文化宗教研究。
实际应用
实际应用中,该数据集支撑了伊斯兰教育平台的智能检索系统开发,宗教机构利用其构建了典籍交叉引用工具。压缩版本特别适合网络条件受限地区的研究者,文档工程师可基于标准化的TXT/DOCX格式快速开发多语言翻译管道,数字人文项目则借此开展伊斯兰科学史的知识演化研究。
数据集最近研究
最新研究方向
在伊斯兰文献数字化领域,prophet-mosque-library-compressed数据集正推动多模态文本处理技术的创新应用。研究者们聚焦于阿拉伯语古籍的智能识别与跨格式转换,结合OCR技术和深度学习模型提升复杂版式文献的解析准确率。近期突破体现在利用Transformer架构对宗教典籍进行语义标注和知识图谱构建,为伊斯兰文明研究提供了结构化数据基础。该资源亦成为数字人文领域的热点,支持多语言机器翻译、跨文化比较等前沿课题,其压缩版本显著降低了学术机构获取珍贵文献的门槛。
以上内容由遇见数据集搜集并总结生成


