BRepGround
收藏资源简介:
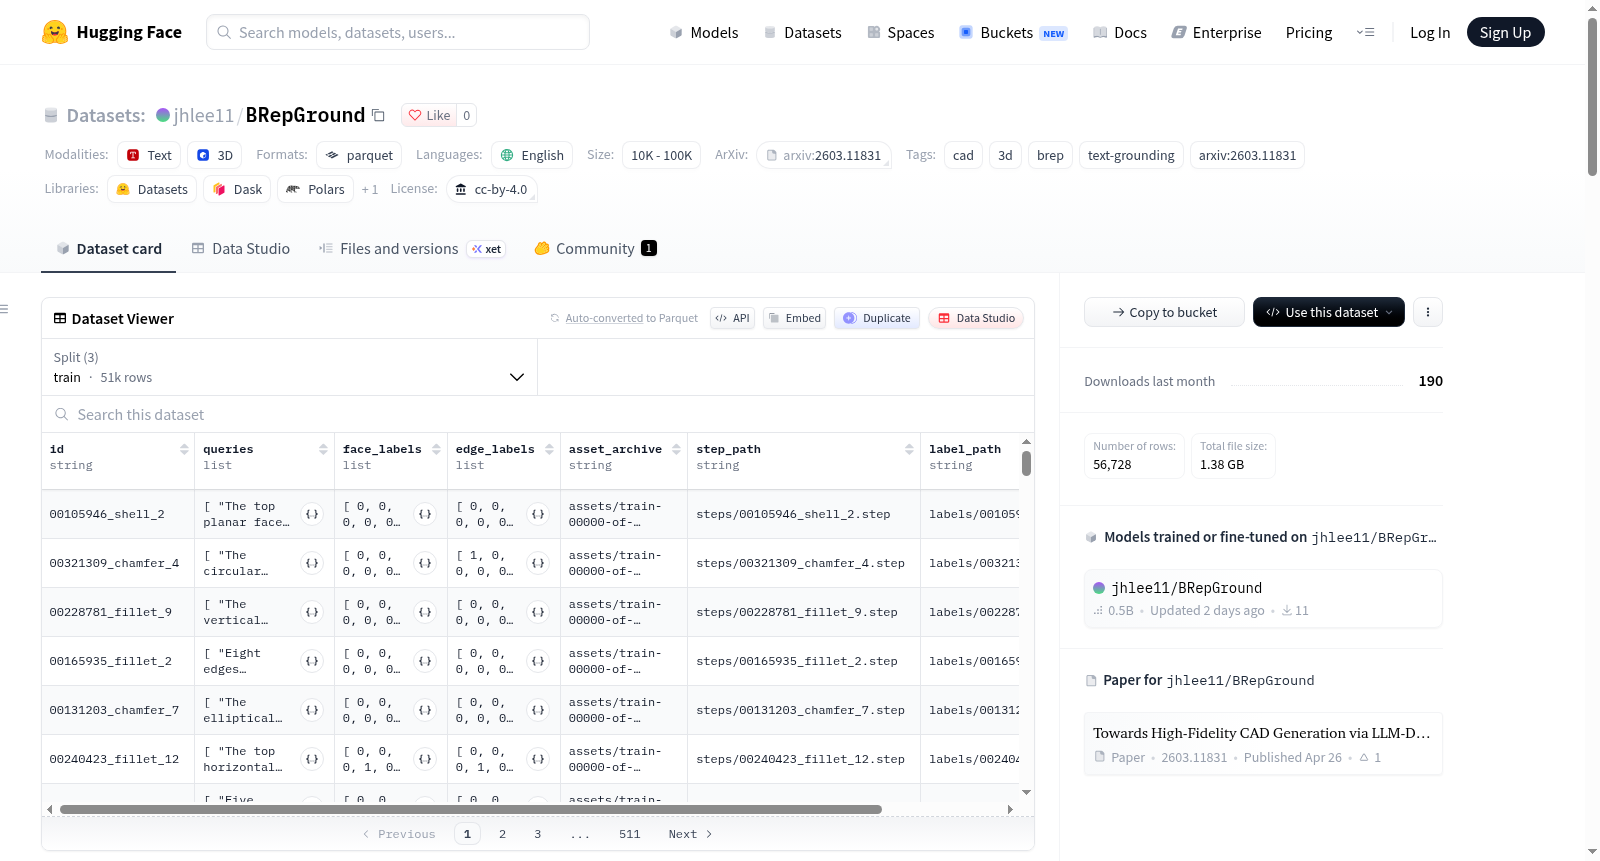
BRepGround是一个用于基于文本的B-Rep(边界表示)基本体定位的数据集,旨在支持高保真CAD生成任务,源自论文“Towards High-Fidelity CAD Generation via LLM-Driven Program Generation and Text-Based B-Rep Primitive Grounding”(ICML 2026)。数据集包含CAD状态(STEP实体)、对应的文本查询以及面和边的二值标签。每个样本存储一个CAD状态及其共享标签的文本查询。数据集划分为训练集(51,034个CAD状态,153,159个文本查询)、验证集(2,837个状态,8,511个查询)和测试集(2,857个状态,8,575个查询)。数据以Parquet格式存储,主要字段包括:id(CAD状态ID)、queries(文本查询列表)、face_labels(按OCC遍历顺序的每个面二值标签)、edge_labels(按OCC遍历顺序的每个边二值标签)、asset_archive(包含STEP和标签JSON的ZIP分片)、step_path和label_path(分片内文件路径)。标签中1表示目标基本体,0表示未选择,重复的定向出现按OCC的IsSame身份比较只计一次。数据集采用CC BY 4.0许可,使用pythonocc-core 7.8.1.1 / OCCT 7.8.1索引,适用于文本驱动的CAD基本体定位模型的训练与评估。
BRepGround is a dataset for text-based B-Rep (Boundary Representation) primitive grounding, designed to support high-fidelity CAD generation tasks, derived from the paper Towards High-Fidelity CAD Generation via LLM-Driven Program Generation and Text-Based B-Rep Primitive Grounding (ICML 2026). The dataset contains CAD states (STEP entities), corresponding text queries, and binary labels for faces and edges. Each sample stores a CAD state along with its shared-label text queries. The dataset is split into training (51,034 CAD states, 153,159 text queries), validation (2,837 states, 8,511 queries), and test (2,857 states, 8,575 queries) sets. Data is stored in Parquet format with main fields: id (CAD state ID), queries (list of text queries), face_labels (binary labels per face in OCC traversal order), edge_labels (binary labels per edge in OCC traversal order), asset_archive (ZIP archive containing STEP and label JSON files), step_path and label_path (file paths within the archive). Labels: 1 indicates target primitive, 0 indicates not selected; repeated oriented occurrences are counted only once by OCCs IsSame identity comparison. The dataset is licensed under CC BY 4.0, indexed using pythonocc-core 7.8.1.1 / OCCT 7.8.1, and is suitable for training and evaluating text-driven CAD primitive grounding models.
BRepGround 数据集概述
基本信息
- 数据集名称:BRepGround
- 许可证:CC BY 4.0
- 语言:英语 (en)
- 数据规模:10K < n < 100K
- 标签:cad、3d、brep、text-grounding、arxiv:2603.11831
- 相关论文:Towards High-Fidelity CAD Generation via LLM-Driven Program Generation and Text-Based B-Rep Primitive Grounding (ICML 2026)
数据集内容
面向基于文本的 B-Rep 基元定位(Text-based B-Rep primitive grounding)数据。每个样本由以下部分组成:
- 一个 STEP 实体(STEP solid)
- 一个文本查询(text query)
- 其面(faces)和边(edges)上的二值标签
一个 Parquet 行存储一个 CAD 状态,该行中的查询共享相同的标签。每个标签直接对应一个 STEP 基元。
数据划分
| 划分 | CAD 状态数 | 文本查询数 |
|---|---|---|
| train | 51,034 | 153,159 |
| validation | 2,837 | 8,511 |
| test | 2,857 | 8,575 |
数据说明
- STEP 为该状态 ID 对应操作前的实体。例如,
00133967_chamfer_6属于父模型00133967。 - 状态 ID 在各划分之间互不相交。
- 父模型存在重叠:train/validation 共享 2,039 个,train/test 共享 2,032 个,validation/test 共享 272 个。
splits.json使用train、val、test;而 Hugging Face Datasets 使用validation表示验证划分。
数据列说明
| 列名 | 含义 |
|---|---|
id |
CAD 状态 ID |
queries |
与该行标签共享的文本查询 |
face_labels |
每个 STEP 面对应一个二值标签,按 OCC 遍历顺序 |
edge_labels |
每个 STEP 边对应一个二值标签,按 OCC 遍历顺序 |
asset_archive |
包含 STEP 和标签 JSON 的 ZIP 分片 |
step_path、label_path |
ZIP 分片内的文件路径 |
1表示目标基元;0表示未选中的基元。- 面索引与边索引均从零开始。
- 同一基元的重复定向出现按一次计数,采用 OCC 的
IsSame身份比较。
加载方式
bash pip install datasets
python from datasets import load_dataset
dataset = load_dataset("jhlee11/BRepGround") row = dataset["test"][0] query = row["queries"][0] face_labels = row["face_labels"] edge_labels = row["edge_labels"]
使用 streaming=True 可在不下载整个划分的情况下进行迭代。
下载 STEP 与标签文件
bash hf download jhlee11/BRepGround export_data.py --repo-type dataset --local-dir downloads/brepground python downloads/brepground/export_data.py --split all --output datasets/grounding
- 使用
--split test指定单个划分,--id <state-id>指定单个状态,或--source /path/to/BRepGround指定本地仓库。 - 每个 ZIP 分片最多包含 2,000 个状态。
- 仅加载 Parquet 只会读取标签和路径;导出脚本还会下载 STEP 文件。
导出目录结构:
text datasets/grounding/ steps/<state-id>.step labels/<state-id>.json
每个标签 JSON 包含 query、face_labels 和 edge_labels;query 包含与 Parquet 行中 queries 相同的字符串。
读取带标签的几何
- 标签索引使用 pythonocc-core 7.8.1.1 / OCCT 7.8.1。
- 需按照代码仓库的环境设置说明创建共享的
futurecad环境。在代码仓库根目录导出 STEP 与标签文件后运行:
bash conda activate futurecad
python from grounding_brep.step_labels import read_step_labels
sample = read_step_labels( "datasets/grounding/steps/00133967_chamfer_6.step", "datasets/grounding/labels/00133967_chamfer_6.json", ) selected_faces = [f for f, flag in zip(sample["faces"], sample["labels"]["face_labels"]) if flag] selected_edges = [e for e, flag in zip(sample["edges"], sample["labels"]["edge_labels"]) if flag]
- 读取器使用
read_step_file(..., as_compound=True)加载 STEP,并使用TopologyExplorer(shape, ignore_orientation=True).faces()与.edges()。 - 标签直接遵循这两个遍历序列。在归一化、重新导出或以其他方式修改形状之前,先读取标签。
- 完整索引约定参见 LABELS.md。
文件结构
text data/<split>-.parquet assets/<split>-.zip splits.json export_data.py read_labels.py requirements.txt LABELS.md README.md LICENSE.md
引用
bibtex @misc{li2026highfidelitycadgenerationllmdriven, title={Towards High-Fidelity CAD Generation via LLM-Driven Program Generation and Text-Based B-Rep Primitive Grounding}, author={Jiahao Li and Qingwang Zhang and Qiuyu Chen and Guozhan Qiu and Yunzhong Lou and Xiangdong Zhou}, year={2026}, eprint={2603.11831}, archivePrefix={arXiv}, primaryClass={cs.CV}, url={https://arxiv.org/abs/2603.11831} }
相关链接
- 论文:https://arxiv.org/abs/2603.11831
- 代码:https://github.com/JohanStackk/FutureCAD
- FutureCAD histories:https://huggingface.co/datasets/jhlee11/FutureCAD
- 环境设置:https://github.com/JohanStackk/FutureCAD/blob/main/docs/environment.md
- 许可证:https://creativecommons.org/licenses/by/4.0/