
遇见数据集

QCRI/MMCQA-SemEval27

收藏
Hugging Face2026-06-16 更新2026-06-21 收录
官方服务:

资源简介:

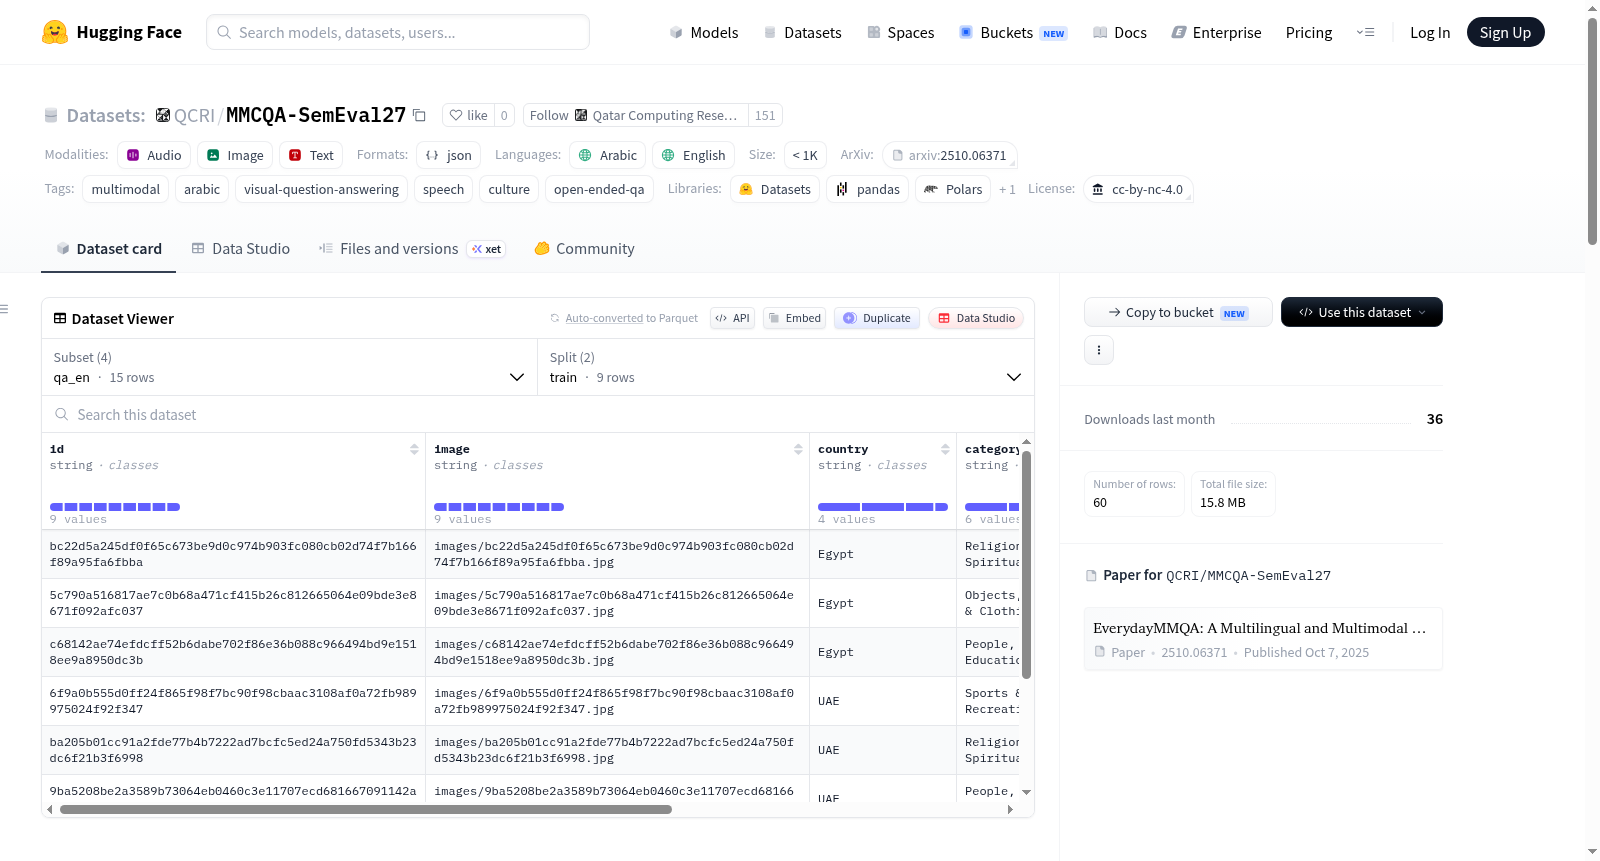
MMCultureQA-SemEval27是一个用于SemEval 2027共享任务的多模态数据集,专注于基于文化的视觉问答,支持英语和阿拉伯语。系统接收一张图像和一个关于图像的问题(问题以音频或文本形式提供),并生成一个简短的开放式答案。问题常涉及食物、地点、习俗和物体,因此正确答案通常依赖于本地文化知识而非图像表面可见内容。数据集包含两个任务:Task 1(Spoken Visual QA)问题以口语音频片段形式给出;Task 2(Textual Visual QA)问题以文本形式给出。每个任务按语言变体分为不同轨道,目前包括英语和现代标准阿拉伯语,计划扩展至埃及阿拉伯语、黎凡特阿拉伯语等。数据文件包括图像、音频和JSONL文件,其中JSONL文件包含ID、图像路径、国家、类别、子类别、问题(或音频路径)和答案等字段。该版本为小样本发布,完整训练和开发集将后续发布。

MMCultureQA-SemEval27 is a multimodal dataset for the SemEval 2027 Shared Task, focusing on culture-based visual question answering. It supports both English and Arabic. The system takes an image and a question about the image (the question is provided in either audio or text format) and generates a short open-ended answer. Questions often relate to food, locations, customs, and objects, so correct answers typically rely on local cultural knowledge rather than visually apparent content in the image. The dataset includes two tasks: Task 1 (Spoken Visual QA), where questions are provided as spoken audio clips; Task 2 (Textual Visual QA), where questions are provided in text format. Each task is divided into distinct tracks based on language variants, currently covering English and Modern Standard Arabic, with plans to expand to Egyptian Arabic, Levantine Arabic, and other variants. The dataset files include images, audio files, and JSONL files. The JSONL files contain fields such as ID, image path, country, category, subcategory, question (or audio path), and answer. This release is a few-shot version, and the full training and development sets will be released subsequently.
提供机构:
QCRI
搜集汇总
数据集介绍
QCRI/MMCQA-SemEval27 数据集图片
构建方式
MMCQA-SemEval27 数据集源自 SemEval 2027 共享任务,旨在构建一个面向文化与多模态的视觉问答资源。其构建基于 OASIS 数据集,通过精心采集来自不同文化背景的图像与相关问题,涵盖食物、地点、习俗与物品等主题。数据以图像、音频和文本三元组形式组织,图像以 JPEG 格式存储,音频以 WAV 格式按语言分目录存放。数据集包含两大任务:文本视觉问答(qa)与口语视觉问答(sqa),每个任务均提供英语和现代标准阿拉伯语两种语言轨道。数据文件采用 JSONL 格式,分为训练集(train)和开发集(dev),通过相对路径引用多媒体文件,避免重复存储,确保结构紧凑且易于扩展。
特点
该数据集的核心特色在于其深植于文化语境的视觉问答设计,强调回答依赖本地知识而非图像表面信息。每个样本包含图像、问题、答案、国家、类别与子类别字段,其中类别与子类别细粒度地标注了文化主题,如饮食、节日或手工艺。口语任务中的音频片段模拟真实语音交互场景,增强多模态挑战。测试集隐藏了答案和文化标签,迫使系统仅凭图像与问题推断,考验模型的文化理解与推理能力。数据集覆盖英语与阿拉伯语两大语种,并计划纳入埃及阿拉伯语等方言变体,展现对跨语言与跨文化多样性的深刻关注。
使用方法
使用该数据集时,用户可通过 Hugging Face Datasets 库按配置名加载相应轨道,例如 'qa_en' 或 'sqa_msa'。加载后,数据以标准字典格式呈现,包含图像路径、问题和答案字段。图像和音频文件需从本地路径读取;口语任务中,需解码 WAV 音频为波形或特征向量。模型应基于图像与问题生成开放式的文本答案,测试阶段需忽略国家、类别等元信息。评估时需参考官方任务网站提供的评分指标,确保与共享任务一致性。推荐将数据按比例切分为训练、验证与测试子集,以适配不同模型的训练与调优流程。
背景与挑战
背景概述
在跨文化与多模态人工智能的交汇领域,视觉问答(Visual Question Answering, VQA)系统正逐渐从通用图像理解迈向对地域性文化知识的深度整合。MMCultureQA-SemEval27数据集由2027年国际语义评测研讨会(SemEval)组织发布,依托于2025年提出的OASIS多语言多模态数据集构建,核心研究团队包括Firoj Alam等学者,旨在解决英语与阿拉伯语中文化根植的开放域视觉问答问题。该数据集涵盖图像、文本与语音三种模态,问题聚焦食物、场所、习俗与物品等需依赖地方知识而非视觉表象的领域,为跨文化人工智能研究提供了首个兼具语音与文本输入的多语言基准。其影响力体现在推动模型从表面视觉特征向深层文化语义推理的演进,尤其服务于阿拉伯语变体(如现代标准阿拉伯语及即将扩展的埃及方言等)的低资源场景。
当前挑战
MMCultureQA-SemEval27所应对的领域核心挑战在于,现有VQA模型普遍缺乏对地域文化常识的感知能力,导致其倾向于从图像中抽取显性特征(如颜色、形状)作答,而忽略隐含的文化习俗(如特定节日的象征物或饮食禁忌),这与人类依赖本土知识的回答模式相悖。构建过程中,数据集面临的挑战包括多模态数据的跨语言对齐(如英语问题与阿拉伯语音频的语义等价性)、文化主题的分类边界模糊性(如某一节日服饰可能跨越多个亚文化圈),以及测试集对country、category等元信息的刻意隐匿,迫使模型必须在无外部上下文提示的情况下,仅凭图像与问题推理出符合特定文化背景的答案,这对训练数据的代表性提出了极高要求。
常用场景
经典使用场景
MMCQA-SemEval27数据集专为跨文化视觉问答任务而设计,其经典使用场景聚焦于结合图像与多模态输入(文本或语音)进行开放域文化知识推理。研究者可借助该数据集评估模型在阿拉伯语与英语双语言环境下,对蕴含地方习俗、饮食传统、地标建筑及日常物件等文化细微差异的理解能力。通过图像中难以直接观测的隐性文化线索,模型需生成准确且具有文化认知深度的回答,从而检验其在视觉语义理解与地域常识融合方面的综合表现。
衍生相关工作
围绕MMCQA-SemEval27,学界已衍生出多项奠基性工作。其数据构建基于OASIS多语言多模态数据集,为后续研究提供了基准框架。SemEval 2027共享任务的设立直接催生了针对口语与文本双通道的跨文化视觉问答方法创新,包括多模态预训练模型在文化感知任务上的微调策略、音频与视觉特征对齐的融合架构,以及基于文化类别标签的零样本推理技术。这些工作进一步拓展了视觉问答在跨语言文化迁移学习中的应用深度。
数据集最近研究
最新研究方向
MMCQA-SemEval27数据集聚焦于跨文化视觉问答的前沿探索,尤其在英语与阿拉伯语双语环境下,通过图像与开放式问题的结合,推动模型对文化语境的理解能力。该数据集强调区域知识(如饮食、风俗、场所)对答案的制约,而非单纯依赖视觉内容,反映了当前多模态研究中文化适应性的核心挑战。关联SemEval 2027共享任务,其口语与文本双通道设计(包括现代标准阿拉伯语及未来方言扩展)为构建文化鲁棒的问答系统提供了基准,对促进低资源语言与跨文化AI系统的发展具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

