
遇见数据集

JA_Emilia_Yodas_ScribeEvents

收藏
Hugging Face2026-03-28 更新2026-03-29 收录
官方服务:

资源简介:

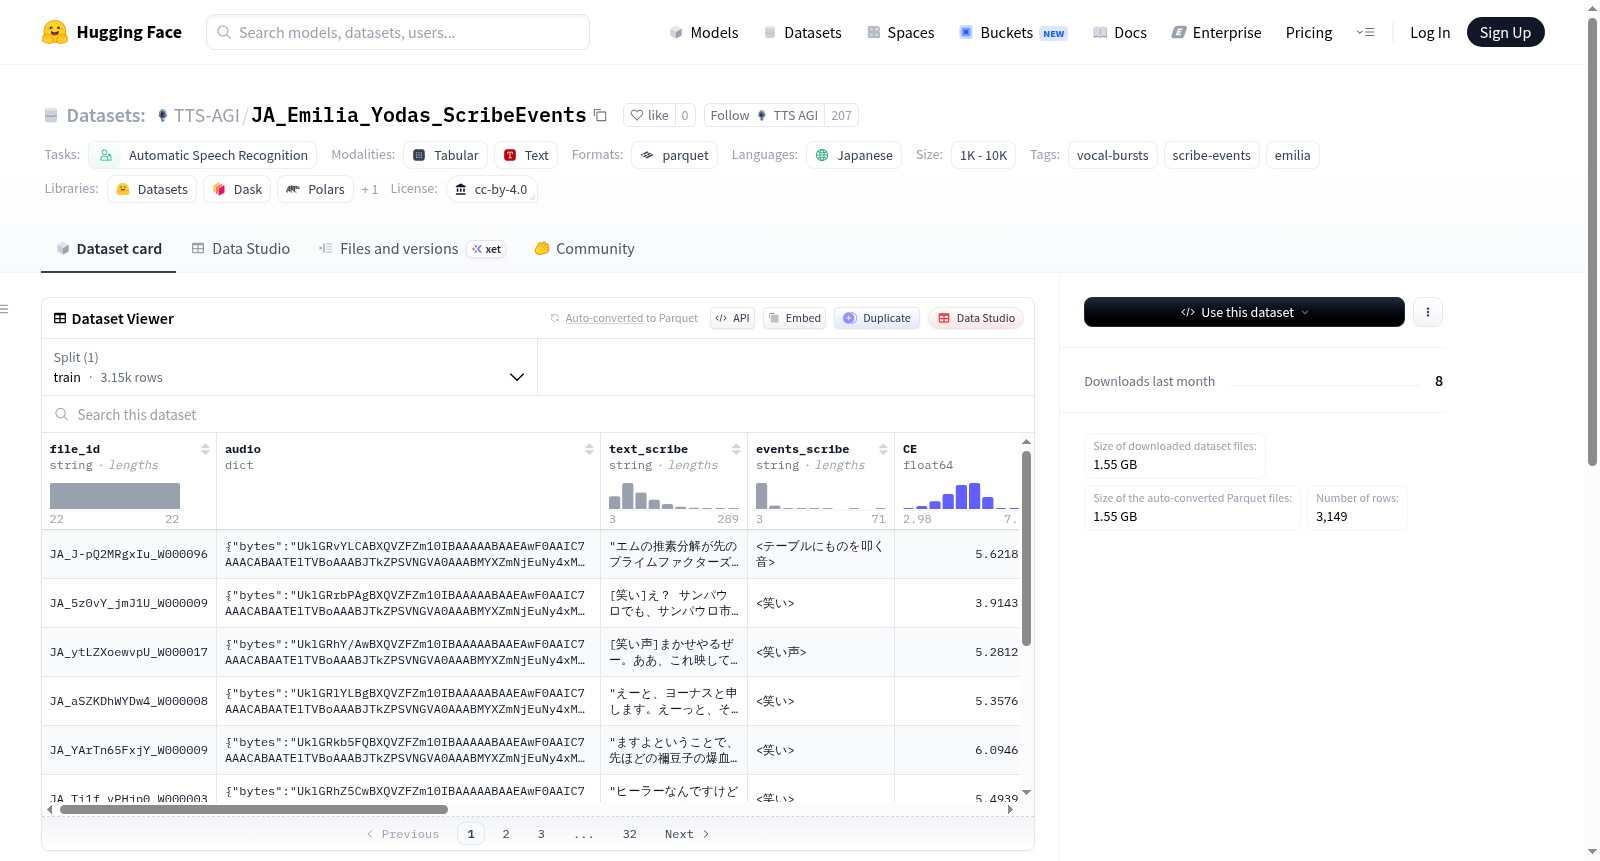
JA Emilia Yodas - Scribe Events (Filtered) 是一个日语语音数据集,是从 MrDragonFox/JA_Emilia_Yodas_266h 数据集中过滤得到的子集,仅包含 ElevenLabs Scribe v1 音频事件的样本。数据集主要应用于自动语音识别任务,特别关注声音爆发(如笑声、叹息等)、背景音(如背景噪音、音乐等)和其他事件(如暂停、无法识别的声音等)的标注。数据集经过过滤,保留了 4433 行数据,并对事件标注格式进行了统一处理(将 `(event)` 替换为 `[event]`)。数据集的许可证为 CC BY 4.0,适用于语音识别和音频事件检测等任务。

JA Emilia Yodas - Scribe Events (Filtered) is a Japanese speech dataset. It is a filtered subset sourced from the MrDragonFox/JA_Emilia_Yodas_266h dataset, and only includes samples corresponding to ElevenLabs Scribe v1 audio events. This dataset is primarily utilized for automatic speech recognition tasks, with particular emphasis on annotations for sound bursts (e.g., laughter, sighs), background sounds (e.g., ambient noise, music), and other events such as pauses and unrecognizable sounds. Following filtering, the dataset retains 4433 rows of data, and the event annotation format has been uniformly standardized by replacing `(event)` with `[event]`. The dataset is licensed under CC BY 4.0, and is applicable to tasks including speech recognition and audio event detection.

创建时间:
2026-03-26
原始信息汇总

JA Emilia Yodas - Scribe Events (Filtered) 数据集概述

基本信息

  • 数据集名称:JA Emilia Yodas - Scribe Events (Filtered)
  • 许可证:CC BY 4.0
  • 语言:日语 (ja)
  • 任务类别:自动语音识别
  • 标签:vocal-bursts, scribe-events, emilia

数据集描述

该数据集是 MrDragonFox/JA_Emilia_Yodas_266h 的一个过滤子集,仅包含具有 ElevenLabs Scribe v1 音频事件 的样本。

与源数据集的差异

  1. 过滤:仅保留 events_scribe 字段非空的行(共保留 4433 行)。
  2. 括号格式统一:将 text_scribe 中的 (event) 替换为 [event]

事件类型

  • 发声事件<laughs>, <sighs>, <clears throat> 等。
  • 背景事件<background noise>, <music> 等。
  • 其他事件<pause>, <unintelligible>, <bleep> 等。

数据来源

派生自 MrDragonFox/JA_Emilia_Yodas_266h(CC BY 4.0 许可证)。
搜集汇总
数据集介绍
JA_Emilia_Yodas_ScribeEvents 数据集图片
构建方式
在语音识别与音频事件标注领域,JA_Emilia_Yodas_ScribeEvents数据集通过精心筛选与标准化处理构建而成。该数据集源自JA_Emilia_Yodas_266h原始语料库,运用ElevenLabs Scribe v1音频事件检测技术,仅保留包含非空事件标注的样本,共计4433条有效数据。同时,对文本中的事件标记格式进行了统一化处理,将圆括号格式转换为方括号,确保了标注结构的一致性,为后续分析提供了清晰的基础。
使用方法
在语音识别研究中,JA_Emilia_Yodas_ScribeEvents数据集适用于训练与评估能够识别音频事件的端到端模型。研究者可加载该数据集,利用其标注信息构建多任务学习框架,同步优化语音转文本与事件检测性能。数据集支持直接通过HuggingFace库调用,便于集成至现有工作流中,进行数据预处理、模型微调或跨语言声学事件分析,从而推动更自然、上下文感知的语音技术发展。
背景与挑战
背景概述
在自动语音识别(ASR)领域,传统模型主要关注于纯文本转录,忽略了语音中丰富的副语言信息,如笑声、叹息等非词汇声音事件。JA_Emilia_Yodas_ScribeEvents数据集应运而生,由MrDragonFox基于其原始日语语音数据集JA_Emilia_Yodas_266h构建,专注于整合ElevenLabs Scribe v1音频事件标注。该数据集创建于2024年,旨在推动语音识别系统对多模态声音事件的理解与处理,通过标注4433条包含声音事件的样本,为研究语音中的情感表达、环境背景及非语言交流提供了结构化资源,对提升人机交互的自然性与鲁棒性具有重要影响。
当前挑战
该数据集致力于解决自动语音识别中副语言信息建模的挑战,传统ASR系统常将非词汇声音视为噪声而忽略,导致转录结果缺乏语境完整性与情感维度。具体挑战包括如何准确识别并分类多样化的声音事件(如笑声、背景音乐等),以及将这些事件无缝整合到文本转录中,以增强语音理解的深度。在构建过程中,数据筛选与标注统一面临技术难题,例如从原始266小时数据中提取有效事件样本,并统一事件括号格式(如将`(event)`转换为`[event]`),这要求精细的数据处理流程与标注一致性保障,以确保数据质量与模型训练的可靠性。
常用场景
经典使用场景
在语音识别与音频事件标注领域,JA_Emilia_Yodas_ScribeEvents数据集为研究者提供了丰富的日语语音样本,特别聚焦于非语言性声音事件的标注。该数据集通过筛选包含ElevenLabs Scribe v1音频事件的样本,构建了一个专门用于训练和评估语音事件检测模型的资源。其经典使用场景在于支持自动语音识别系统在处理真实对话时,能够准确识别并标注诸如笑声、叹息、清嗓等声音爆发事件,以及背景噪音、音乐等环境音效,从而提升语音转文本的完整性与自然度。
解决学术问题
该数据集主要解决了语音处理研究中非语言音频事件识别与标注的学术难题。传统语音识别系统往往忽视对话中的副语言元素,导致转写文本缺乏情感与语境信息。JA_Emilia_Yodas_ScribeEvents通过系统标注多种声音事件,为模型训练提供了结构化数据,助力研究者开发能够区分语音内容与声音事件的算法。这不仅推动了多模态语音分析的发展,还促进了人机交互中情感计算与语境理解的研究,具有重要的学术意义。
实际应用
在实际应用中,JA_Emilia_Yodas_ScribeEvents数据集可广泛应用于智能助理、语音转录服务及内容审核系统。例如,在客服对话分析中,系统能通过识别笑声或叹息来评估用户情绪;在媒体内容生成中,自动标注背景音乐或噪音有助于音频后期处理。此外,该数据集支持开发更精准的语音界面,使设备能理解人类对话中的非语言线索,提升用户体验与交互自然性,为日语语音技术商业化落地提供数据基础。
数据集最近研究
最新研究方向
在日语语音识别领域,JA_Emilia_Yodas_ScribeEvents数据集聚焦于非语言事件标注的前沿探索。该数据集通过筛选包含ElevenLabs Scribe v1音频事件的样本,为研究者提供了丰富的副语言信息标注,如笑声、叹息等发声爆发事件,以及背景噪声、音乐等环境事件。当前研究热点集中于利用此类细粒度事件标注提升语音识别系统在真实场景中的鲁棒性与表现力,特别是在多模态交互和情感计算应用中,这些标注有助于更精准地捕捉说话者的情感状态和语境信息。这一方向推动了语音处理技术向更自然、更人性化的人机交互方向发展,对智能助理、虚拟角色生成等领域具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

