
vibhorag101/phr_suicide_prediction_dataset_clean_light
收藏数据链接:
官方服务:
资源简介:
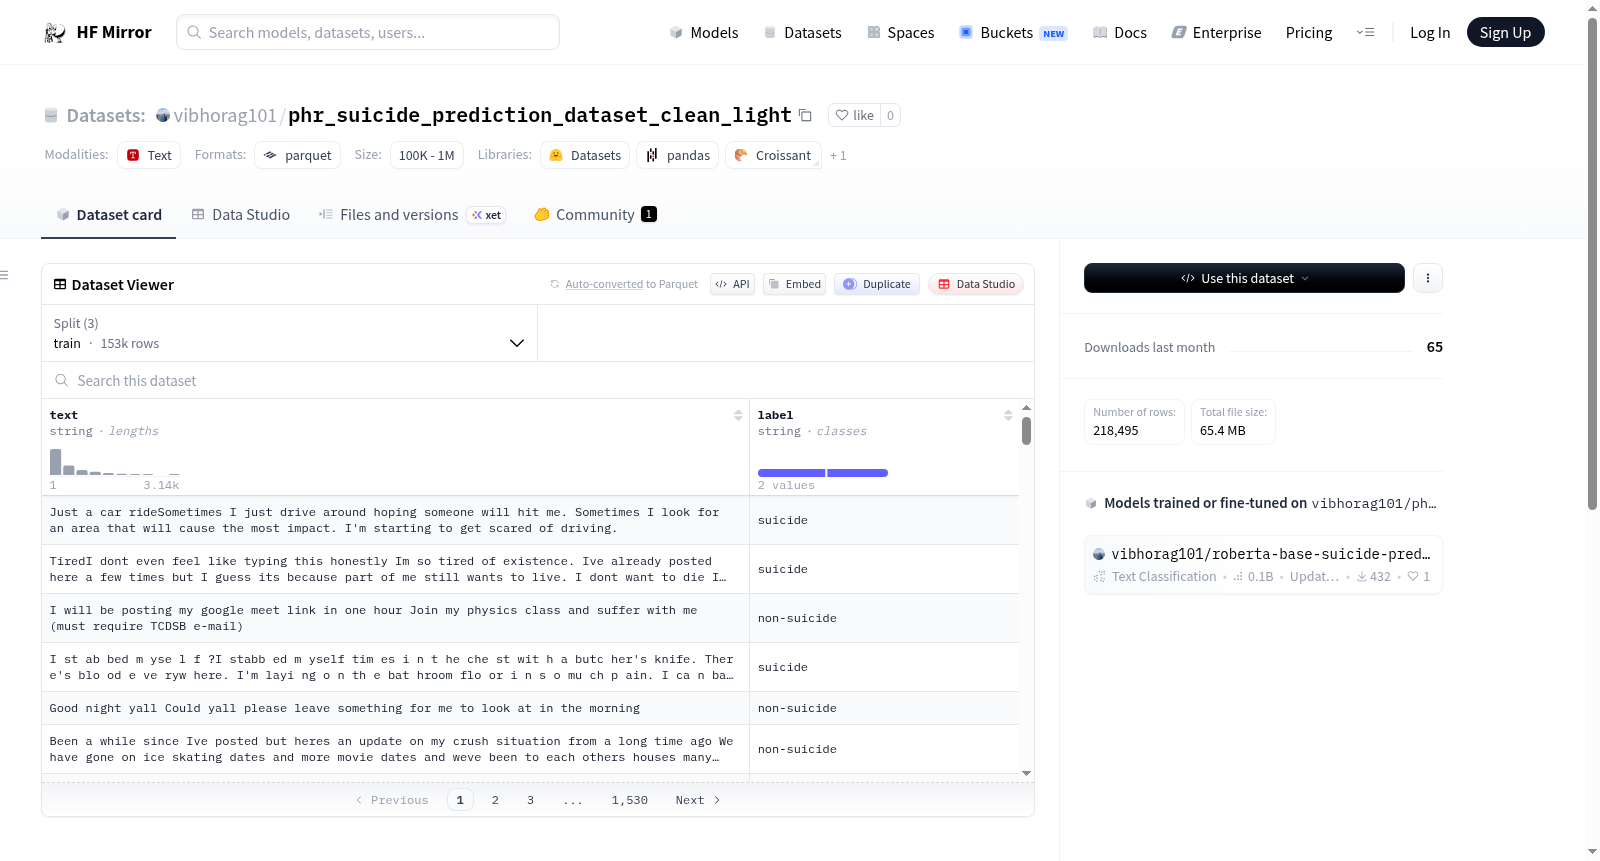
该数据集来源于Reddit,包含用于自杀预测的文本和二元标签。数据集经过最小化清理,包括移除数字、URL、表情符号、重音字符、多余的空格以及超过BERT最大令牌限制的行。清理后的数据集可在指定链接找到。评估集约有33k样本,训练集约有153k样本,采用70:15:15(训练:测试:验证)的分割比例。
该数据集来源于Reddit,包含用于自杀预测的文本和二元标签。数据集经过最小化清理,包括移除数字、URL、表情符号、重音字符、多余的空格以及超过BERT最大令牌限制的行。清理后的数据集可在指定链接找到。评估集约有33k样本,训练集约有153k样本,采用70:15:15(训练:测试:验证)的分割比例。
提供机构:
vibhorag101原始信息汇总
数据集概述
数据集信息
- 特征:
text: 类型为stringlabel: 类型为string
- 分割:
train: 字节数为 105750984.56504539,样本数为 152946test: 字节数为 22660826.48866134,样本数为 32774val: 字节数为 22661517.91560003,样本数为 32775
- 下载大小: 65442094 字节
- 数据集大小: 151073328.96930677 字节
配置
- 默认配置:
train: 文件路径为data/train-*test: 文件路径为data/test-*val: 文件路径为data/val-*
数据集描述
- 数据集包含文本和二元标签(自杀或非自杀)。
- 数据集进行了最小程度的清洗:
- 移除数字
- 移除URL、表情符号和重音字符
- 移除多余的空白字符和单个空格后的多余空格
- 移除连续重复超过3次的字符
- 移除超过BERT最大令牌限制(512个令牌)的行
- 数据集的训练、测试和验证集比例为 70:15:15。
搜集汇总
数据集介绍
构建方式
在心理健康与自杀预防研究领域,精准识别高风险文本内容对于早期干预至关重要。该数据集源自Reddit社交平台,原始语料经过精心筛选与清洗,以适配BERT等预训练语言模型的输入要求。构建过程中,首先移除了数字、URL、表情符号及重音字符,并剔除了连续重复三次以上的字符序列,同时清理了多余空白。为契合BERT最大512令牌的限制,删除了超出该长度的文本行。最终数据集以70:15:15的比例划分为训练集、测试集和验证集,分别包含约15.3万、3.3万和3.3万个样本。
使用方法
此数据集专为自杀风险预测任务设计,可直接用于训练和评估基于Transformer架构的文本分类模型。使用时,用户可通过HuggingFace的datasets库加载default配置,自动获取train、test和val三个分片。每个样本包含'text'字段(字符串类型)和'label'字段(字符串类型),分别代表输入文本和类别标签。建议在模型微调前对文本进行必要的分词和编码,并注意利用验证集进行超参数调优,以提升模型在真实场景中的泛化能力。
背景与挑战
背景概述
在精神卫生领域,自杀预防是一项迫在眉睫的全球性挑战。社交媒体平台如Reddit已成为识别自杀风险信号的重要数据来源,通过自然语言处理技术挖掘用户文本中的潜在心理危机,为早期干预提供了可能。该数据集由研究者vibhorag101于近年构建,源自Kaggle上的自杀监测数据集,核心研究问题在于利用BERT等预训练语言模型对社交媒体文本进行二分类,区分自杀倾向与非自杀倾向内容。数据划分采用70:15:15的比例,训练集包含约15.3万样本,测试集与验证集各约3.3万样本,为模型训练与评估提供了充足且均衡的语料基础。该数据集在心理健康领域具有显著影响力,推动了基于深度学习的自杀风险自动检测研究,为临床辅助决策与大规模社会筛查提供了数据支撑。
当前挑战
该数据集面临的挑战首先在于领域问题的复杂性:自杀风险检测本质上是一个高度敏感且带有伦理考量的任务,文本中隐晦的情感表达、文化差异及隐喻性语言使得分类边界模糊,模型易受虚假相关或语境歧义干扰,导致误判风险升高。构建过程中的挑战则体现在数据清洗策略上:为保留BERT所需的上下文敏感信息,仅进行了最小化清洗(如移除数字、URL、表情符号及超长序列),但这一策略可能引入噪声,例如冗余符号或拼写错误影响模型鲁棒性;同时,移除超过512个BERT令牌的样本虽符合模型约束,却可能丢弃包含关键语义的长文本,造成信息损失。此外,数据来源单一(仅限Reddit平台)限制了跨域泛化能力,而二分类标注本身难以捕捉自杀风险的渐变程度与紧急层级,为实际应用中的风险分级带来困难。
常用场景
经典使用场景
在精神健康与自然语言处理的交叉领域中,该数据集凭借其源自Reddit论坛的真实文本语料,成为构建自杀风险预测模型的经典基准。研究者利用其二元标签(自杀倾向与非自杀倾向)训练BERT等预训练语言模型,通过捕捉文本中隐含的绝望、孤独或自我伤害意图等语义线索,实现对高危个体的早期识别。数据集的精心预处理——包括去除URL、表情符号及超长序列——确保了模型在上下文敏感性上的鲁棒性,使其成为验证深度学习算法在心理危机干预中效能的标准化测试平台。
解决学术问题
该数据集直面自杀意念自动检测这一严峻的公共卫生学术挑战,解决了传统临床评估依赖主观问卷、难以大规模筛查的痛点。通过提供超过15万条标注文本,它使研究者能够量化语言模式与自杀风险之间的统计关联,从而推动从经验性诊断向数据驱动型预警的范式转变。其公开可用性降低了情感计算领域的入门门槛,促进了可重复研究,并为跨文化自杀语言学特征的比较分析提供了可靠数据源。
实际应用
在实际应用中,该数据集赋能了社交媒体监控系统的开发,能够实时筛选出包含自杀信号的帖子,并向平台管理员或心理援助机构发出预警。例如,基于该数据训练的模型可集成至Reddit或Twitter的审核流程,辅助识别需要紧急干预的用户。此外,它还被用于开发面向心理咨询师的可视化工具,通过高亮文本中的风险关键词,提升临床评估的效率与准确性,从而在社区心理健康服务中发挥预防性作用。
数据集最近研究
最新研究方向
基于Reddit社交文本的自杀风险预测是计算精神病学与自然语言处理交叉领域的前沿热点。该数据集vibhorag101/phr_suicide_prediction_dataset_clean_light聚焦于利用BERT等预训练语言模型对用户生成内容进行二分类(自杀/非自杀)判别,其清洗策略刻意保留上下文敏感信息以适配Transformer架构的语义理解需求。当前研究趋势已从简单词频统计转向融合心理语言学特征的深度模型,例如引入情感时序动态、自杀意图隐喻识别及跨平台泛化能力评估。该数据集的大规模样本(训练集约15.3万条)与严谨划分(70:15:15)为构建鲁棒的自杀预警系统提供了基准,尤其在减少误报率与提升早期干预时效性方面具有关键意义。此类研究不仅推动社交媒体心理健康筛查的自动化进程,更在伦理框架下为公共卫生政策制定提供数据驱动的决策支持。
以上内容由遇见数据集搜集并总结生成


