
SatsukiVie/EvidenceFirst-Audio
收藏官方服务:
资源简介:
此文件夹包含公开的EvA字幕、问答和音频数据。音频片段来源于AudioSet强标签数据集,并以音频字节形式存储在parquet分片中。
This folder contains publicly available EvA subtitles, question-answering data, and audio data. The audio clips are sourced from the AudioSet Strong Labels Dataset, and are stored as audio byte data in Parquet shards.
提供机构:
SatsukiVie搜集汇总
数据集介绍
构建方式
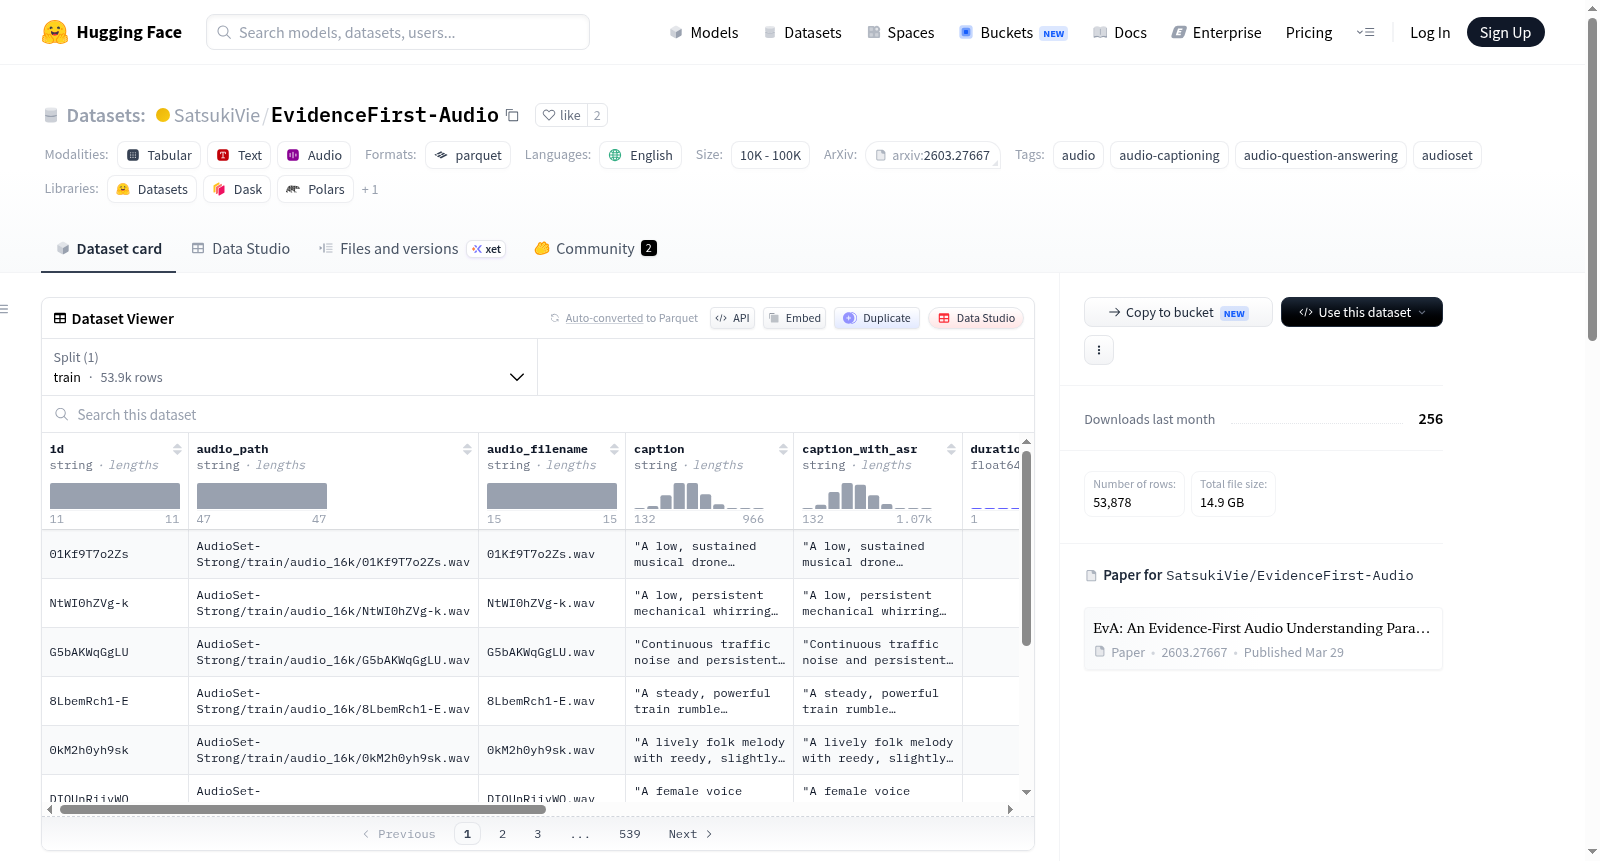
EvidenceFirst-Audio数据集依托于AudioSet Strong Labels中的音频片段构建而成,以parquet分片形式存储音频字节数据。该数据集主要包含两类元数据:一是描述性标注文件captions.jsonl,记录音频路径、原始描述文本及经自动语音识别增强的描述文本;二是指令问答文件qa.jsonl,采用与描述文件一致的相对音频路径。音频数据分存于18个parquet分片中,每行涵盖音频标识符、路径、时长、采样率、帧数、格式及音频字节等完整字段,总计提供53,878条描述标注和418,435条问答样本。
特点
该数据集最显著的特点在于引入了证据优先的音频理解范式,通过双重描述机制——原始描述与ASR增强描述,强化音频内容与语言表达的对齐。最小音频时长严格限定为1.0秒,确保数据粒度的一致性。规模上,问答样本数量接近描述标注的八倍,为训练大型音频语言模型提供了丰富的监督信号。数据格式高度结构化,音频字节内嵌于parquet分片,便于高效读取与分布式处理,同时保持与AudioSet Strong Labels路径的兼容性。
使用方法
使用该数据集时,可直接加载parquet音频分片并解析每行的音频字节字段,配合captions.jsonl进行音频描述任务,或利用qa.jsonl开展音频问答微调。建议按音频路径与描述文件中的id字段进行关联,结合caption_with_asr字段使用ASR增强描述以提升模型对含语音音频的理解。对于大规模实验,可将18个parquet分片并行加载,依据duration_sec字段过滤短音频样本。此外,可参照相关论文中的训练策略,将证据优先范式融入模型架构设计。
背景与挑战
背景概述
EvidenceFirst-Audio(EvA)数据集由Xinyuan Xie、Shunian Chen等研究人员于2026年提出,旨在服务于大型音频语言模型(LALMs)的证据优先音频理解范式。该数据集源于AudioSet Strong Labels,核心研究问题在于构建一个带有明确证据线索的音频描述与问答资源,以推动模型从被动感知向主动推理转变。EvA包含约5.4万条音频描述和41.8万条问答对,覆盖广泛的声音事件,为提升LALMs在多模态理解中的可解释性与鲁棒性提供了关键基准,在智能语音交互、视频内容理解等领域具有重要影响力。
当前挑战
EvA所解决的领域挑战在于传统音频理解任务缺乏对决策证据的显式建模,模型常依据统计关联而非真实声学线索进行判断,导致推理不可靠。在构建过程中,挑战包括如何从AudioSet强标签中高效提取并对齐高质量音频片段,以及如何设计既忠实于原始音频又融合ASR增强的标注策略,避免噪声引入。此外,海量问答对的自动生成需确保问题与证据的因果一致性,同时平衡数据多样性,这对标注流程和算法提出了严格要求。
常用场景
经典使用场景
EvidenceFirst-Audio数据集在音频理解领域开辟了崭新的范式。该数据集以证据优先(Evidence-First)为核心理念,专门服务于大规模音频语言模型(LALMs)的精细调优与评估。其经典使用场景涵盖音频字幕生成与音频问答两大任务,研究者可基于超过五万条高质量音频字幕及逾四十万条问答对,训练模型精准描述复杂声学场景,并依据音频中的具体声学证据进行推理与回答。
解决学术问题
该数据集解决了当前音频-语言模型普遍存在的“黑箱推理”问题,即模型虽能生成正确回答,却无法提供可验证的声学依据。通过引入蕴含明确证据链的标注范式,EvidenceFirst-Audio促使模型在视觉或文本模态之外,真正学会利用音频信号中的时间频率特征、事件因果序列等声学线索进行可解释推理,推动了音频机器学习领域向透明可信方向迈进,为构建高可靠性听觉智能奠定了理论基础。
衍生相关工作
该数据集的诞生催生了系列前沿研究方向,包括基于证据链的音频推理工作、音频-文本交叉模态的可解释性建模,以及弱监督条件下的声学场景细粒度识别。其对应的学术论文《EvA: An Evidence-First Audio Understanding Paradigm for LALMs》系统阐述了这一范式的理论架构与可行性验证,为后续的多模态对话系统、具身智能体听觉模块等衍生工作提供了关键数据支撑与实验基准。
以上内容由遇见数据集搜集并总结生成


