
proxectonos/es-gl_bensculturais_parallel
收藏官方服务:
资源简介:
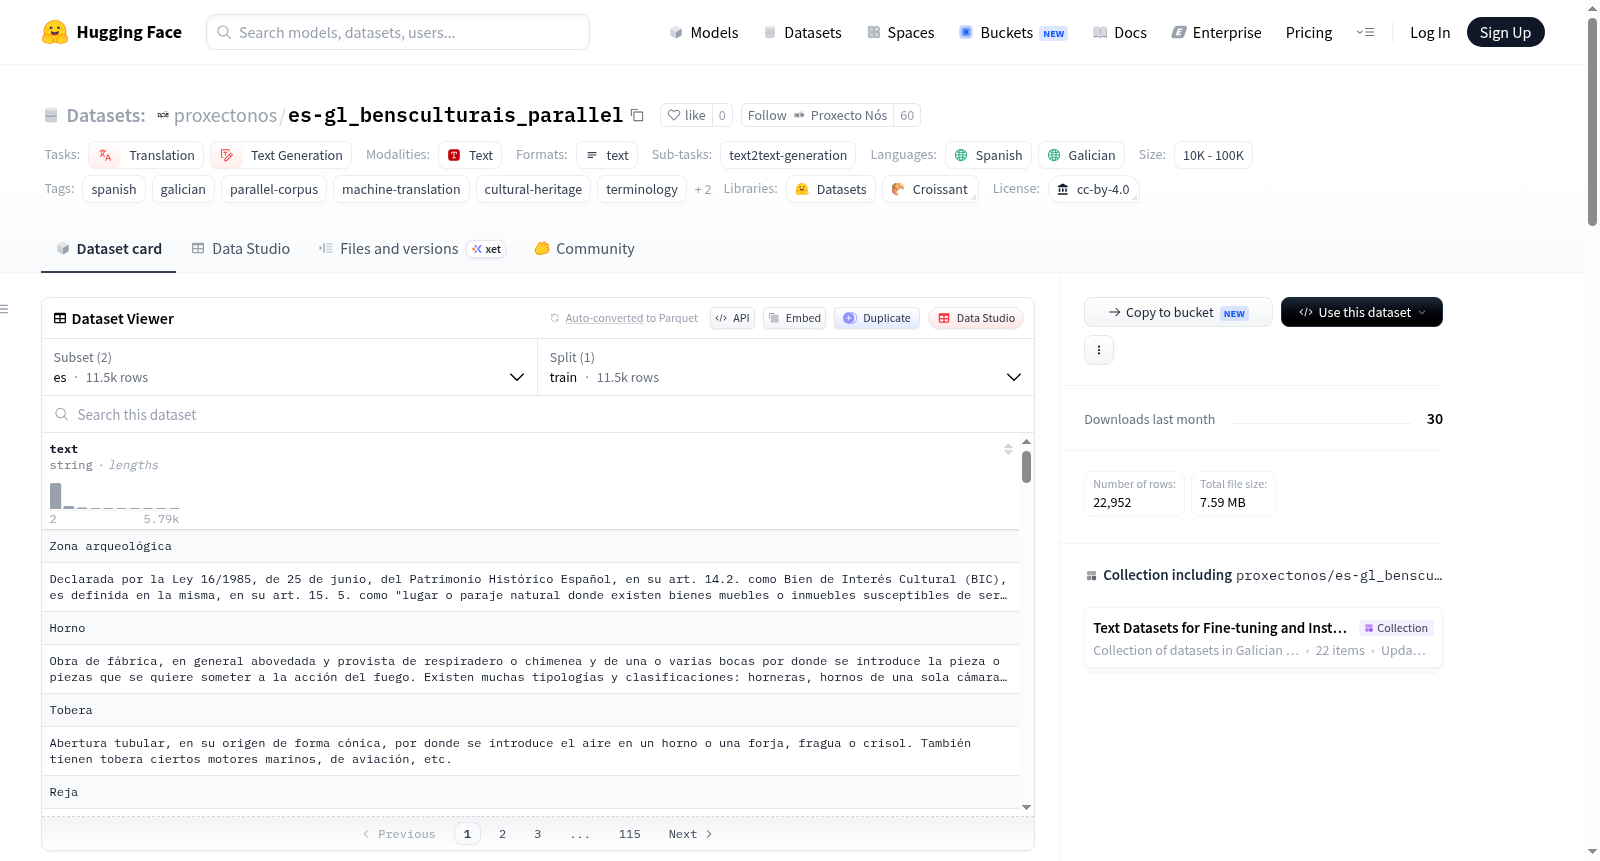
`es-gl_bensculturais_parallel` 是一个西班牙语-加利西亚语平行语料库,专注于文化遗产术语和定义。它包含从文化遗产术语资源中提取并对齐的西班牙语和加利西亚语文本文件。该数据集旨在支持机器翻译、术语适应、领域特定语言建模以及在文化遗产领域开发西班牙语-加利西亚语资源。
`es-gl_bensculturais_parallel` is a Spanish-Galician parallel corpus focused on cultural heritage terminology and definitions. It contains Spanish and Galician text files extracted and aligned from cultural heritage terminology resources. This dataset aims to support machine translation, terminology adaptation, domain-specific language modeling, and the development of Spanish-Galician resources in the cultural heritage domain.
提供机构:
proxectonos搜集汇总
数据集介绍
构建方式
该数据集源自西班牙文化部官方发布的《文化财产名称词典》,通过从公共数据门户提取西班牙语与加利西亚语的术语及定义,进行逐行对齐与清洗归一化处理,构建成双语平行语料库。原始内容经人工校对与自动化流程结合,确保两种语言间的语义对应关系得以完整保留,最终形成结构简洁的纯文本文件对(es.txt与gl.txt),并以Hugging Face平台上的独立配置形式呈现。
特点
数据集专注于文化遗产领域,收录西班牙语与加利西亚语的专业术语及定义,规模紧凑但语义精准。其最大的特点在于严格的行对齐结构,使得每一条术语在双语间保持一一对应,为机器翻译和术语对齐任务提供了高保真的训练数据。此外,数据源具有官方背景,内容规范且专业性强,适用于低资源场景下的领域适配与模型评估。
使用方法
用户可直接加载Hugging Face上的`es`或`gl`配置,提取对应语言的文本字段。若需执行翻译或对齐实验,建议保留`es.txt`与`gl.txt`的行对应关系,避免打乱顺序。数据集适合用于训练或微调西班牙语-加利西亚语翻译模型、评估文化遗产术语处理能力、以及构建领域限定语言模型。使用时需注明原始出处,并遵循CC BY 4.0许可协议。
背景与挑战
背景概述
该数据集名为“Spanish-Galician Cultural Heritage Terms and Definitions Parallel Corpus”,由西班牙文化与数字转型部门在欧盟NextGenerationEU资助框架下创建,属于ALIA模型开发项目的一部分。其核心研究问题在于构建一个聚焦文化遗产领域的西班牙语-加利西亚语平行语料库,以支持术语对齐、机器翻译及领域语言模型开发。该数据集源于西班牙文化部官方发布的《文化遗产对象名称词典》,通过提取、翻译、对齐与清洗流程,形成高质量的术语与定义对。尽管规模较小,但其针对低资源语言对及专门领域的贡献,为加利西亚语在文化遗产场景下的自然语言处理研究提供了宝贵基础资源,推动了该语种在专业领域的数字化应用。
当前挑战
该数据集所面临的挑战主要体现在两个方面:首先,在领域问题层面,文化遗产术语具有高度专业性和语义复杂性,其翻译不仅要求跨语言对应,还需保持文化概念的精确性,这对机器翻译模型在稀疏数据场景下的泛化能力构成显著考验;其次,在构建过程中,原始资源需经过清洁、对齐与标准化处理,确保line级双语对应无误,但小规模语料(n<1K)导致数据稀疏性突出,难以覆盖术语的多义性与上下文变体,同时需严格遵守CC BY-4.0许可证下的归属要求,避免语义篡改,这些步骤均增加了数据质量控制的难度。
常用场景
经典使用场景
在文化遗产领域,术语的跨语言对齐是机器翻译与多语言信息检索的关键基石。该数据集作为西班牙语-加利西亚语文化遗产术语与定义的平行语料库,经典使用场景聚焦于领域受限的机器翻译任务,特别是针对博物馆、考古遗址及文化遗产名录中专业术语的精准翻译。研究者常将其用于训练和评估面向低资源语言的翻译模型,通过线对齐的平行句子对,实现文化专有名词与描述性定义的跨语言映射,从而提升翻译系统在遗产保护文本上的语义保真度。
实际应用
在实际应用中,该数据集成为文化遗产数字化管理的关键工具,助力博物馆与图书馆构建多语言标签系统。例如,通过基于该语料库训练的翻译引擎,策展人能够自动将西班牙语的文物名称和定义转化为加利西亚语,服务于地方语言社区的展览说明与教育材料。此外,它还可嵌入旅游导览应用,提供实时术语翻译,增强游客对文化遗产的理解。在政府层面,它支持公共文化数据库的本地化更新,促进跨区域的文化资源整合与传播。
衍生相关工作
基于该数据集,学界衍生了一系列创新性工作,包括面向文化遗产领域的术语对齐算法优化以及跨语言预训练语言的微调策略。研究者利用其线对齐特性开发了术语级翻译质量评估框架,并探索了零样本学习在低资源平行语料上的扩展。此外,该数据集被整合进ALIA项目的多语言模型训练管线,作为专门领域的验证基准,其构建流程也启发了其他罗曼语族语言(如加泰罗尼亚语与巴斯克语)类似语料库的创建,形成了文化遗产术语对齐的方法论范式。
以上内容由遇见数据集搜集并总结生成


