
遇见数据集

Xalitobeirut/Nemotron-Personas-Korea

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

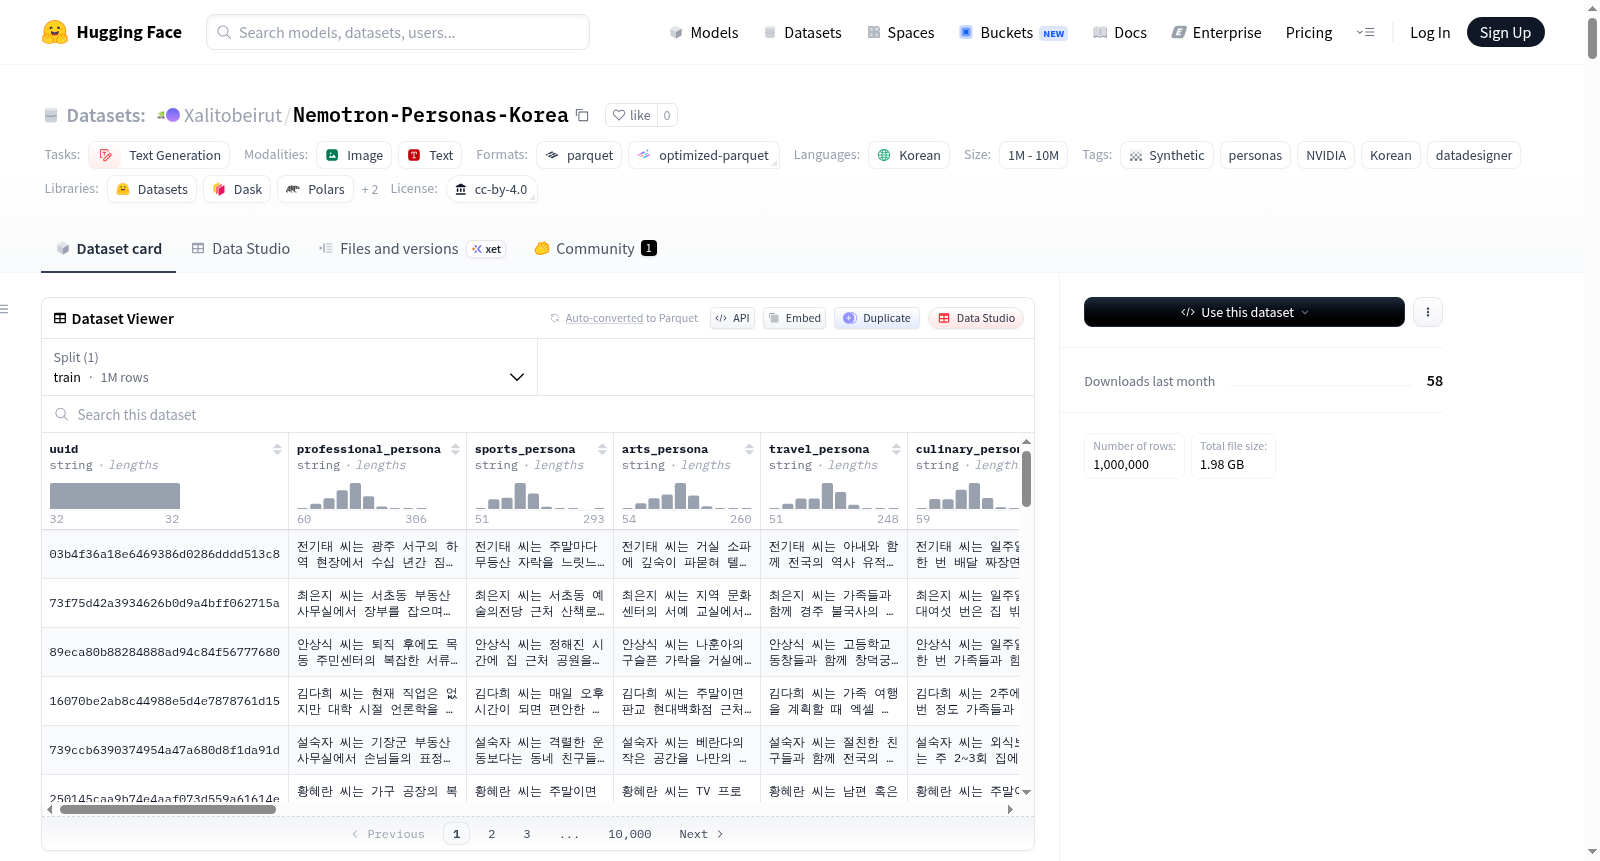
Nemotron-Personas-Korea是一个基于韩国真实世界人口统计、地理和性格特征分布合成的开源人物角色数据集(CC BY 4.0)。该数据集旨在广泛反映韩国人口的多样性和特征,包含姓名、性别、年龄、婚姻状况、教育水平、职业和居住地区等属性。数据集使用NVIDIA的NeMo Data Designer企业级合成数据生成复合AI系统创建,结合了专有的概率图模型和Apache-2.0许可的google/gemma-4-31B-it模型。数据集包含100万条记录,涵盖700万个人物角色,26个字段,包括7个人物角色字段、6个人物角色属性字段、12个人口统计和地理背景字段以及1个唯一标识符。该数据集支持韩国模型开发者构建包含重要地区特定人口统计和文化背景的主权AI系统,可用于扩大合成数据的多样性、减轻数据和模型偏见以及提高模型响应的多样性。数据集在CC BY 4.0许可下免费供商业和非商业使用。

Nemotron-Personas-Korea is an open-source persona dataset (CC BY 4.0) synthesized based on real-world demographic, geographic, and personality trait distributions of South Korea. It is designed to broadly reflect the diversity and characteristics of the South Korean population, including attributes such as name, sex, age, marital status, education level, occupation, and region of residence. The dataset was created using NVIDIAs NeMo Data Designer, an enterprise-grade compound AI system for synthetic data generation, leveraging a proprietary probabilistic graphical model and the Apache-2.0 licensed google/gemma-4-31B-it model. It contains 7M personas across 1M records with 26 fields: 7 persona fields, 6 persona attribute fields, 12 demographic & geographic contextual fields, and 1 unique identifier. This dataset supports South Korean model builders in developing Sovereign AI systems that incorporate important region-specific demographics and cultural context. It can be used to expand the diversity of synthetic data, mitigate data and model bias, and improve the diversity of model responses. The dataset is freely available for both commercial and non-commercial use under the CC BY 4.0 license.
提供机构:
Xalitobeirut
搜集汇总
数据集介绍
Xalitobeirut/Nemotron-Personas-Korea 数据集图片
构建方式
Nemotron-Personas-Korea数据集基于韩国真实人口统计、地理及人格特质分布,利用NVIDIA NeMo Data Designer这一企业级复合AI系统构建而成。其核心方法为:首先从韩国统计厅、大法院、国民健康保险公团等官方渠道获取种子数据,随后采用专有的概率图模型(PGM)与Apache-2.0许可的google/gemma-4-31B-it大语言模型协同工作,通过生成、验证与评估的迭代流程,最终合成出100万条记录、总计700万个人物画像,确保数据在人口统计学维度上忠实反映现实分布。
特点
该数据集作为首个大规模韩语人物画像数据集,展现了卓越的结构化多样性与文化嵌入性。其特点包括:涵盖17个道(省)与252个市郡区(区)的完整地理层级,并细化为职业、体育、艺术等七种人格描述类型;每条记录包含26个字段,如姓名、年龄、婚姻状况、教育背景及居住地等,丰富了上下文属性。数据集特别注重对高龄人群、农村地区及非主流职业的覆盖,以缓解现有数据集的代表性偏差。此外,姓名生成基于真实姓氏与命名趋势,精准复现了韩国社会中的同名现象与代际差异。
使用方法
此数据集遵循CC BY 4.0许可,可自由用于商业与非商业目的。主要应用于主权AI(Sovereign AI)系统的开发,通过提供多样化的人物画像来增加合成数据集的多样性,从而减轻语言模型中的偏见并提升生成文本的多视角性。用户可直接将数据集用于微调韩语大语言模型,或作为条件控制信号引导模型生成符合特定人口统计特征的响应。同时,NeMo Data Designer用户亦能直接加载其扩展版本,便于融入更复杂的合成数据流水线。
背景与挑战
背景概述
Nemotron-Personas-Korea数据集由NVIDIA于2026年4月发布,是全球首个大规模韩语合成人物数据集,旨在为韩国主权人工智能系统提供反映本地人口统计学与文化脉络的多样化人物数据。该数据集基于韩国统计厅、大法院、国民健康保险公团等官方统计,通过NeMo Data Designer中的概率图模型与Gemma 4语言模型生成百万条记录,涵盖职业、艺术、家庭等七种人物类型及丰富人口属性。其在语言模型微调、数据多样性增强与偏差缓解方面具有重要应用价值,为韩国开源社区推动模型技术演进提供了坚实数据基础。
当前挑战
该数据集核心致力于解决两大挑战:其一,现有韩语人物数据集在年龄、地域、教育等维度上严重偏离实际人口分布,导致模型生成内容缺乏真实性与代表性,尤其忽视高龄与农村群体。其二,构建中面临公共数据可用性、时效性有限及概率图模型的计算约束,例如因变量间独立性假设无法捕捉性别与专业等交互效应,且韩国公开统计缺乏性别认同数据,无法纳入多元性别维度。此外,数据集限定成人样本,未能覆盖未成年人场景,限制了在特定应用中的泛化能力。
常用场景
经典使用场景
Nemotron-Personas-Korea数据集的核心经典用途在于为大语言模型(LLM)的微调与对齐提供高度拟真的韩国人口合成角色(Persona)数据。每一个记录均深度融合了韩国真实的年龄、性别、职业、居住地、教育背景与家庭结构等人口统计学特征,并附带了涵盖职业、运动、艺术等多维度的自然语言角色描述。这使得该数据集成为构建具备韩国文化语境感知能力的主权AI模型的关键基石,尤其适用于需要精准反映地方人口多样性与社会复杂性的文本生成任务。
衍生相关工作
该数据集衍生了一系列重要的基础性工作与技术探索。首先,其构建流程开创性地结合了概率图模型与Google Gemma系列大语言模型,形成了可复用的复合AI合成角色生成管线,为后续其他地域或语言的角色数据集开发提供了工程范式。其次,数据集的发布直接支撑了关于合成数据在主权AI部署中有效性的评估研究,推动了如何利用人口统计锚定数据防止模型坍缩与提升生成内容多样性的方法论进展。此外,其公开的CC BY 4.0授权条款正日益催化社区在韩语LMM训练、负责任的AI对齐以及文化特定角色的下游应用评测等方向上的创新合作。
数据集最近研究
最新研究方向
Nemotron-Personas-Korea数据集聚焦于基于韩国真实人口统计学、地理和性格分布构建的大规模合成韩语角色数据集,旨在为主权AI系统开发提供高度多样化和代表性数据。其最新研究方向包括利用概率图模型与谷歌Gemma模型生成多达700万个角色,覆盖17个省份、252个行政区及209,000个独特姓名,以缓解现有角色数据集中的年龄、地域、教育等维度偏差,从而提升合成数据多样性、减少模型偏见并防止模型坍缩,为韩国本土化AI模型的公平性与文化适应性奠定基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

