
遇见数据集

leeroy-jankins/NIST-AI-Risk-Management-Framework

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

NIST AI风险管理框架问答数据集是一个基于NIST人工智能风险管理框架(AI RMF 1.0)的合成指令式问答数据集。该数据集旨在支持与AI风险管理、可信AI、负责任AI、AI治理、AI生命周期风险控制和人机交互相关的训练、微调、检索评估和领域特定问答用例。源文档解释称,AI RMF旨在帮助设计、开发、部署或使用AI系统的组织管理AI风险,并促进可信和负责任的AI。它被描述为自愿性、保护权利、非行业特定且与用例无关的框架。

The NIST AI Risk Management Framework Question Answering Dataset is a synthetic instructional question-answering dataset based on the NIST Artificial Intelligence Risk Management Framework (AI RMF 1.0). This dataset is designed to support training, fine-tuning, retrieval evaluation, and domain-specific question-answering use cases related to AI risk management, trustworthy AI, responsible AI, AI governance, AI lifecycle risk control, and human-computer interaction. The source documentation states that AI RMF is intended to help organizations that design, develop, deploy, or use AI systems manage AI-related risks and advance trustworthy and responsible AI. It is characterized as a voluntary, rights-protecting, industry-agnostic, and use case-agnostic framework.
提供机构:
leeroy-jankins
搜集汇总
数据集介绍
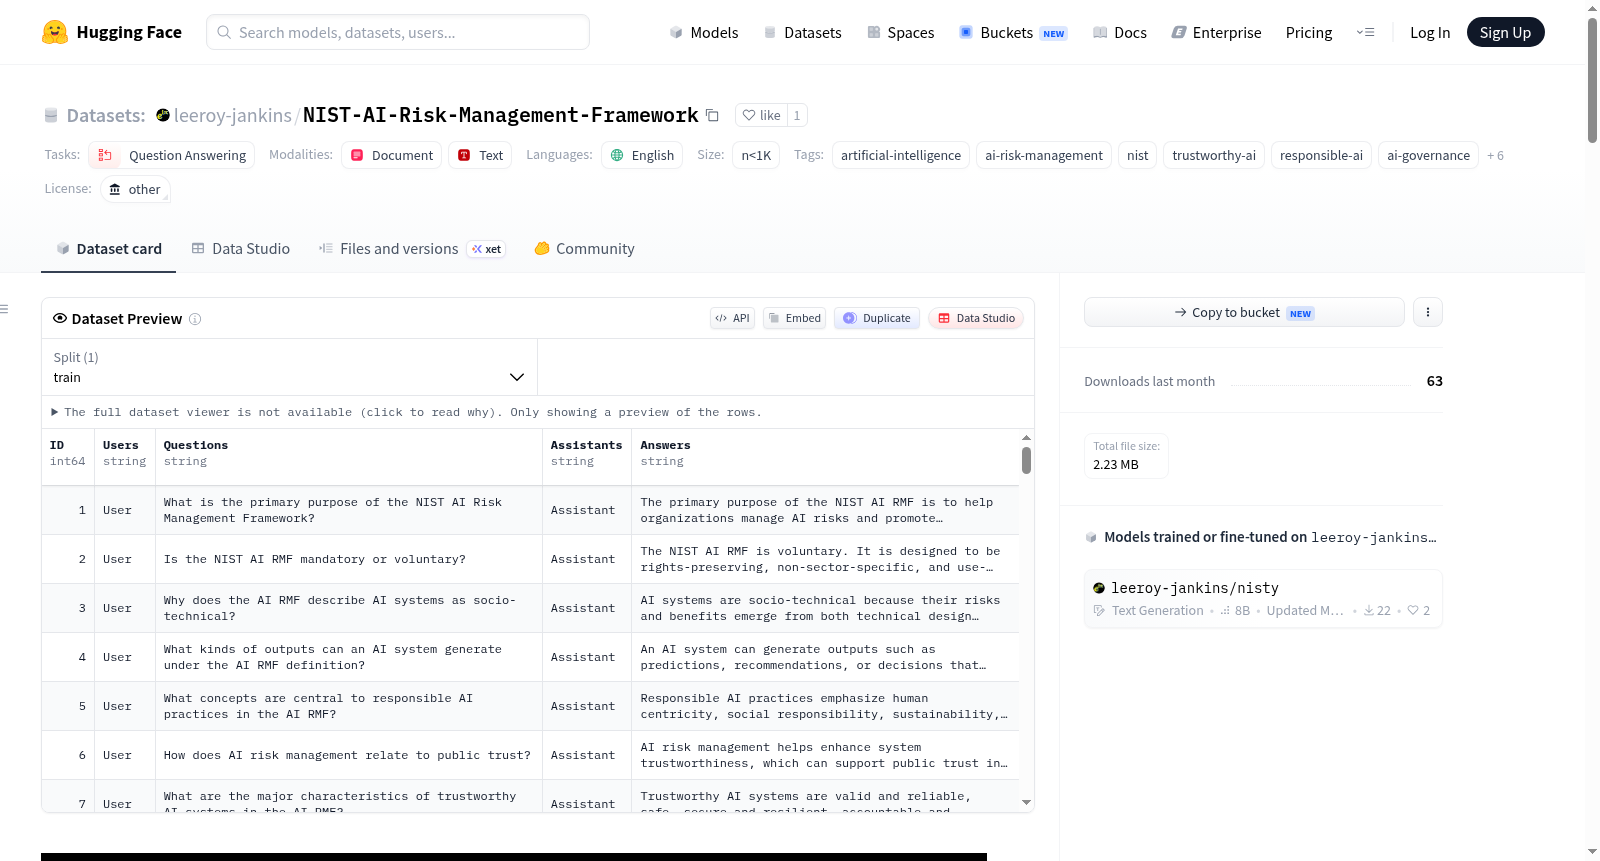
leeroy-jankins/NIST-AI-Risk-Management-Framework 数据集图片
构建方式
该数据集基于美国国家标准与技术研究院(NIST)发布的《人工智能风险管理框架(AI RMF 1.0)》构建而成,属于合成型指令式问答数据集。研究者从源文档中系统抽取了涵盖AI风险基础概念、可信AI特性、治理核心功能(涵盖Govern、Map、Measure、Manage活动)及AI生命周期风险管理等关键主题,通过自动化方法生成问题和答案,并保持简洁的对话式结构,便于指令微调与检索增强生成评估等场景使用。当前版本包含350条记录。
特点
数据集专为AI风险管理与可信AI领域设计,具备高度的领域集中性与权威性,所有问答均严格锚定NIST官方框架。其特点在于以标准化字段结构(ID、用户问题、助手回答)组织数据,便于模型训练和评估;同时采用合成方式提炼原文核心内容,降低了直接引用可能带来的版权风险。虽为教育性质,但精准覆盖治理原则、人机交互及生命周期风险控制等关键维度。
使用方法
适用于小语言模型在AI治理与风险管理概念上的微调,以及构建检索增强生成系统的评估集。用户可利用该数据集测试问答系统在政策导向领域的准确性,或创建面向AI风险管理、可信AI的教育工具。建议结合官方NIST AI RMF文档使用以避免简化或遗漏,在关键应用前应核实数据集是否满足特定任务的完整性及准确性要求。
背景与挑战
背景概述
随着人工智能技术在各个领域的深度渗透,如何系统性地管理其潜在风险已成为全球治理的焦点。美国国家标准与技术研究院(NIST)于2023年1月发布了《人工智能风险管理框架》(AI RMF 1.0),旨在为组织提供一套自愿性、非部门特定且用途中立的指导原则,以应对AI生命周期中的伦理、安全与可靠性挑战。基于该框架构建的NIST AI风险管理框架问答数据集,由相关研究人员合成生成,专注于将宏大的政策框架转化为可操作的知识点,涵盖治理、映射、测量与管理等核心职能,以及可信AI与负责任AI的原则。该数据集的出现,为AI治理政策的落地教育与模型对齐提供了宝贵资源,推动了从理论框架到实践应用的转化进程。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:AI风险管理本身是一个高度复杂且不断演进的跨学科领域,涉及技术、法律、伦理与社会影响,单一的问答形式难以覆盖框架中所有细微差异和动态变化。在构建过程中,数据集采用合成生成方式,虽能快速产出大规模样本,但可能简化或遗漏原生文献中的关键语境与限定条件,导致答案的准确性和完整性不足。此外,由于缺乏逐条记录级别的正式引用,用户难以回溯原始依据,这在需要高可靠性的政策咨询或合规审查场景中构成了重大局限。数据集还需克服偏见、过度泛化以及主题选择偏差等问题,以确保其在不同应用场景中的公平性与有效性。
常用场景
经典使用场景
该数据集专为人工智能风险管理领域的指令微调与问答系统设计,其经典应用在于构建能够精准应答NIST AI RMF 1.0框架相关知识的小型语言模型。通过模拟用户对可信AI、责任AI、AI治理及生命周期风险控制等概念的提问,该数据集可用于训练模型掌握Govern、Map、Measure、Manage四大核心职能的内涵与关系。教育机构与组织内部培训中,它被广泛用于开发智能问答助手,帮助从业者快速理解AI风险管理的非部门专用、自愿性及保护权利的基本特征,从而在理论层面夯实对框架的整体认知。
实际应用
实际应用中,该数据集主要服务于企业内部的AI治理教育平台与合规性预审工具的开发。它被嵌入到检索增强生成的系统中,使得组织能够快速搭建针对AI生命周期的风险管理知识库,帮助设计、开发、部署或使用AI系统的团队实时查阅框架中的控制活动与治理要求。此外,公共政策机构借助该数据集可以自动生成面向公众的AI风险释义与指导,降低理解门槛,同时为监管科技提供经过验证的问答语料,从而在落地层面提升负责任的AI实践效率。
衍生相关工作
基于该数据集,衍生出了多项聚焦于AI治理知识蒸馏与指令微调策略优化的研究工作。部分工作探索了如何将其350条记录与更大规模的政策语料结合,构建多层次的检索增强生成评估集,以衡量模型在推断不完整上下文时的鲁棒性。另有研究以该数据集为基准,对比了不同小参数量模型在AI风险管理问答上的准确性,促进了轻量化合规助手的研发。此外,该数据集还催生了关于合成数据偏见与框架简化风险的讨论,间接推动了更忠实于原始文献的细粒度数据集构建方法的前沿探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

