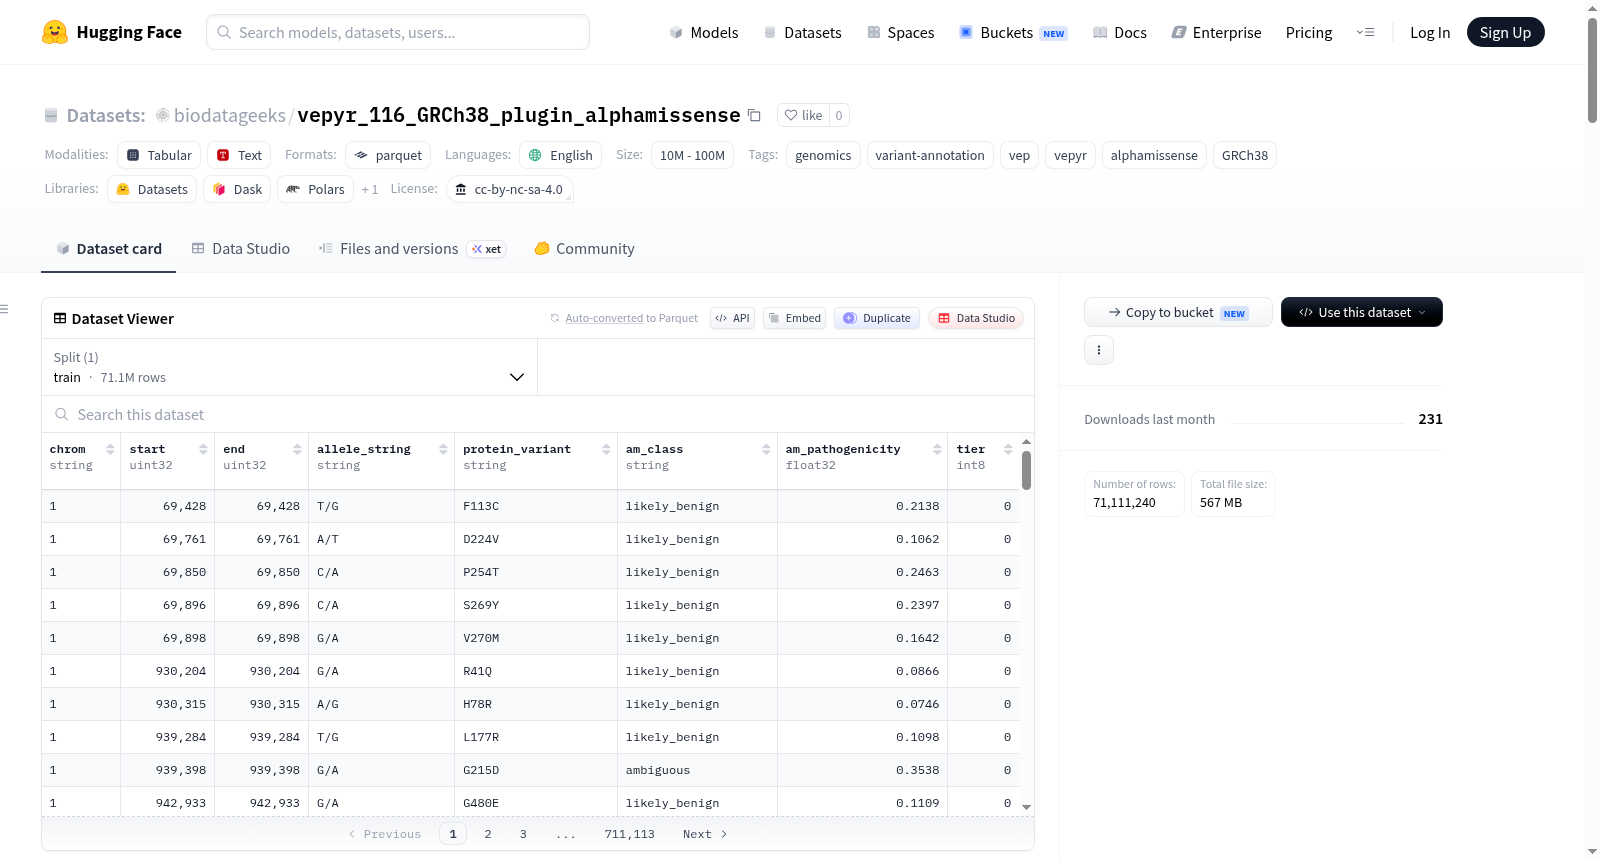
vepyr_116_GRCh38_plugin_alphamissense
收藏资源简介:
该数据集是vepyr的AlphaMissense插件缓存,基于GRCh38基因组构建和Ensembl VEP 116版本。它预构建了按频率分层的Parquet格式缓存,包含DeepMind AlphaMissense 2023年发布的错义突变致病性预测。数据来源为AlphaMissense_hg38.tsv.gz文件(仅包含标准转录本)。该缓存复现了VEP 116的--plugin AlphaMissense插件的CSQ输出,无需在注释时使用上游TSV文件或Perl插件。数据集包含22个常染色体染色体分片(chr1-chr22),不包括chrX、chrY和chrM。总数据量约545 MB,共68,241,195行,其中83,141行标记为warm(频率层0),68,158,054行标记为cold(频率层1)。模式包含8个字段:chrom(染色体)、start(1-based起始位置)、end(1-based结束位置)、allele_string(REF/ALT等位基因,VEP最小化)、protein_variant(蛋白变异描述符,格式为ref_aa+Protein_position+alt_aa)、am_class(致病性分类,值为likely benign、ambiguous或likely pathogenic)、am_pathogenicity(致病性分数,浮点数)、tier(频率层,0为warm,1为cold)。CSQ输出字段为am_class和am_pathogenicity,按VEP自身顺序排列。am_class阈值:分数<0.34为likely benign,>0.564为likely pathogenic,否则为ambiguous。该数据集适用于基因组变异注释,特别是使用vepyr引擎进行AlphaMissense致病性预测,也可直接通过DuckDB、Polars或DataFusion等工具查询Parquet文件。许可为CC BY-NC-SA 4.0,仅限非商业用途,且需进行引用。
This dataset is a plugin cache for AlphaMissense by vepyr, based on the GRCh38 genome build and Ensembl VEP version 116. It is pre-built as a frequency-tiered Parquet cache containing missense mutation pathogenicity predictions from DeepMind AlphaMissense released in 2023. The data source is the AlphaMissense_hg38.tsv.gz file (only canonical transcripts). This cache reproduces the CSQ output of VEP 116s --plugin AlphaMissense without requiring the upstream TSV file or Perl plugin during annotation. The dataset includes 22 autosome chromosome shards (chr1-chr22), excluding chrX, chrY, and chrM. Total data size is approximately 545 MB, with 68,241,195 rows, of which 83,141 are marked as warm (frequency tier 0) and 68,158,054 as cold (frequency tier 1). The schema contains 8 fields: chrom, start (1-based), end (1-based), allele_string (REF/ALT alleles, VEP-minimized), protein_variant (protein variant descriptor in ref_aa+Protein_position+alt_aa format), am_class (pathogenicity classification: likely benign, ambiguous, or likely pathogenic), am_pathogenicity (pathogenicity score, float), and tier (frequency tier: 0 for warm, 1 for cold). The CSQ output fields are am_class and am_pathogenicity, in VEPs own order. Thresholds for am_class: score < 0.34 is likely benign, > 0.564 is likely pathogenic, otherwise ambiguous. This dataset is suitable for genome variant annotation, particularly for AlphaMissense pathogenicity prediction using the vepyr engine, and can also be queried directly via tools like DuckDB, Polars, or DataFusion. Licensed under CC BY-NC-SA 4.0 for non-commercial use only, with attribution required.
vepyr plugin cache — AlphaMissense (GRCh38, VEP 116) 数据集详情
数据集概述
这是一个为 vepyr(基于 Rust/DataFusion 的 VEP 兼容变异注释引擎)预构建的 AlphaMissense 致病性预测 Parquet 格式缓存数据集。它能够在不依赖上游 TSV 文件或 Perl 插件的情况下,复现 Ensembl VEP 116 的 --plugin AlphaMissense 的 CSQ 输出。
数据版本与来源
| 项目 | 详情 |
|---|---|
| 源文件 | AlphaMissense_hg38.tsv.gz(经典转录本) |
| 上游发布 | DeepMind AlphaMissense,2023 年发布(Cheng 等,Science 2023) |
| 源文件 MD5 | 9fd167735f16a1b87da6eb3e4c25fcb5 |
| 构建输入 MD5 | 46d0028375cf95088bd014ff6855cffd |
| 源数据获取日期 | 2026-07-06 |
| 基因组版本 | GRCh38 / hg38,1-based,含 chr 前缀 |
| 缓存构建日期 | 2026-08-27 |
| 目标 VEP 版本 | Ensembl VEP 116 |
数据内容
- 染色体范围:仅常染色体(chr1–chr22),不包含 chrX、chrY 和 chrM
- 数据规模:约 545 MB,共 68,241,195 行(其中 warm 层 83,141 行,cold 层 68,158,054 行)
- 文件格式:Parquet 分片文件(
chr1.parquet至chr22.parquet),每染色体一个分片 - 附带文件:
manifest.json(包含 schema、CSQ 字段映射、各分片行数/分层计数及来源信息)
数据模式(Schema)
| 列名 | 类型 | 说明 |
|---|---|---|
chrom |
string | 染色体(contig) |
start |
uint32 | 1-based 位置 |
end |
uint32 | 1-based 位置 |
allele_string |
string | VEP 最小化的 REF/ALT |
protein_variant |
string | 转录本匹配判别符,格式为 {ref_aa}{Protein_position}{alt_aa} |
am_class |
string | 映射为 CSQ 字段 am_class |
am_pathogenicity |
float | 映射为 CSQ 字段 am_pathogenicity |
tier |
int8 | 频率分层 — 0 为 warm,1 为 cold |
CSQ 输出字段(按 VEP 顺序):am_class、am_pathogenicity
am_class 分类阈值(AlphaMissense 官方标准):
- 评分 < 0.34:likely benign(可能良性)
- 评分 > 0.564:likely pathogenic(可能致病)
- 其他:ambiguous(意义不明确)
匹配语义
AlphaMissense 是一种逐转录本注释工具。VEP 将每个转录本后果的氨基酸变化与数据行的 protein_variant 进行匹配。查询键为 (chrom, start, end, allele_string) 加上 protein_variant 判别符(vepyr 在运行时根据引擎属性 ref_aa、Protein_position 和 alt_aa 构建)。等位基因以最小化形式存储,与 AlphaMissense.pm 的匹配逻辑一致。
频率分层机制
- 每个分片按
(tier, start)排序 tier从构建时使用的 release-116 GRCh38 variation cache 逐行继承;若插件行在变异缓存中无匹配,则标记为 coldtier = 0(warm)仅占 0.12%(83,141 行),物理上排列在文件前端,因此仅查询 warm 数据时只需访问少量 row groups,无需扫描整个分片- 各分片的 warm/cold 计数可在
manifest.json中查看
使用方式
可直接通过 hf download 命令下载该数据集到本地目录,例如:
bash hf download biodatageeks/vepyr_116_GRCh38_plugin_alphamissense --repo-type dataset --local-dir ~/vepyr_plugin_cache/plugin/alphamissense
文件为纯 Parquet 格式,可独立于 vepyr 直接用于 DuckDB、Polars 或 DataFusion 查询,例如使用 SQL 查询某个位置范围内的数据。
许可与引用
- 许可协议:CC BY-NC-SA 4.0(仅限非商业用途,须相同方式共享)
- 数据版权:© 2023 DeepMind Technologies Limited
- 使用声明:AlphaMissense 仅供研究使用,未经临床直接应用验证
- 引用文献:Cheng, J., Novati, G., Pan, J., et al. Accurate proteome-wide missense variant effect prediction with AlphaMissense. Science 381, eadg7492 (2023). doi:10.1126/science.adg7492