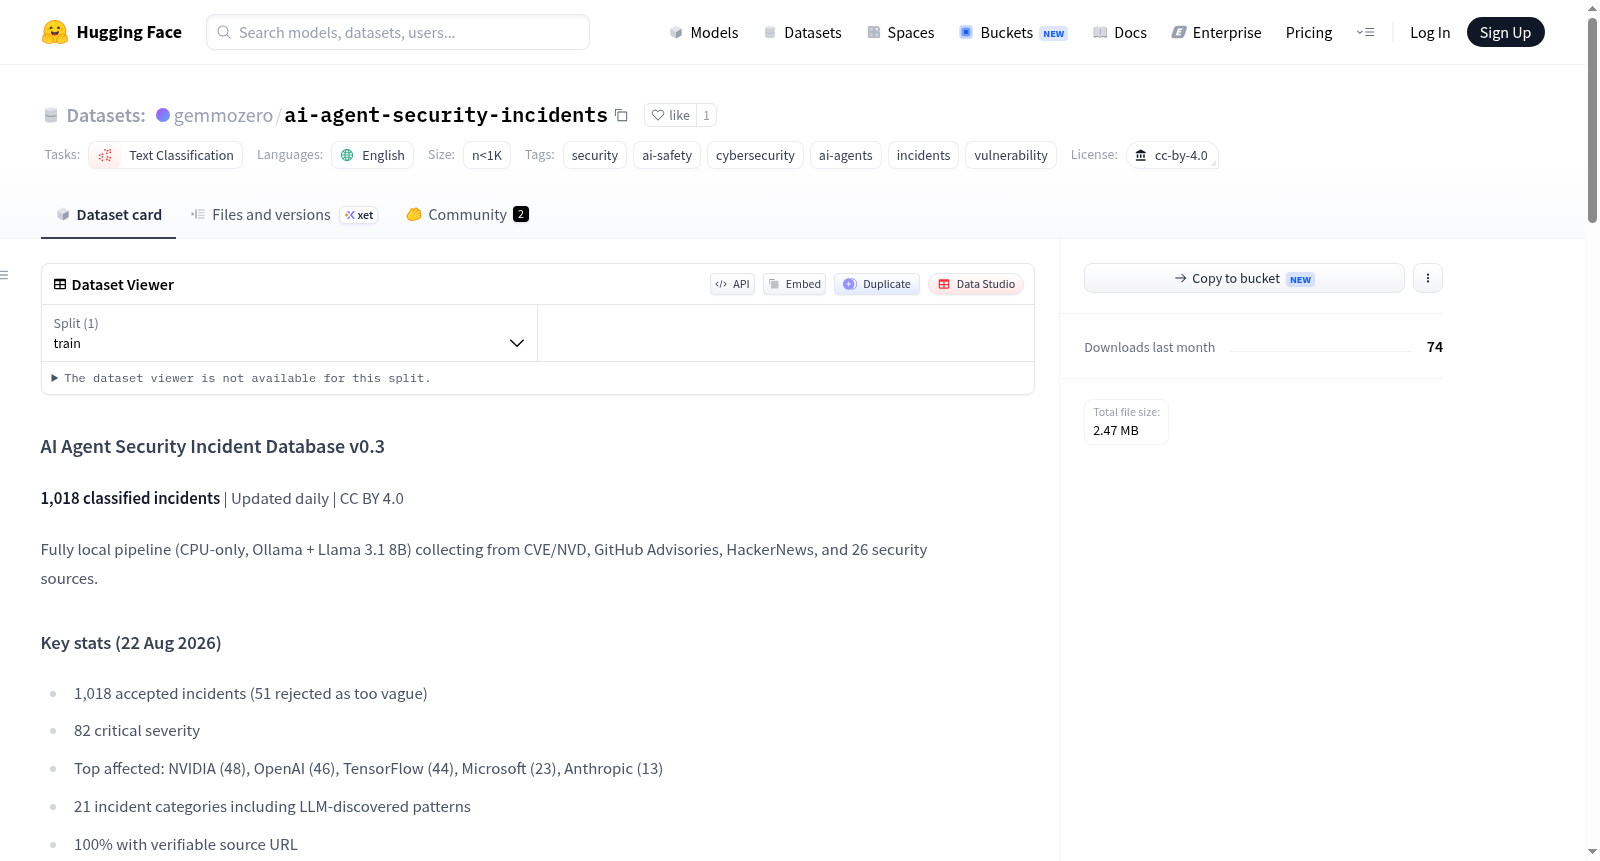
ai-agent-security-incidents
收藏资源简介:
AI Agent 安全事件数据库(AI Agent Security Incident Database)v0.3 是一个专注于 AI 代理安全事件的开源数据集,包含 1,018 个已分类的事件,每日更新,采用 CC BY 4.0 许可。数据来源于 CVE/NVD、GitHub Advisories、HackerNews 以及 26 个安全源,通过全本地化流水线(使用 Ollama 和 Llama 3.1 8B 模型,仅 CPU)自动采集并分类。事件共分为 21 个类别,包括 API 漏洞(312 个)、未授权操作(144 个)、配置漏洞(141 个)、数据泄露(106 个)、提示注入(78 个)、沙箱逃逸(72 个)、代理逃逸(52 个)等。严重程度分布为:严重 81 个、高 765 个、中 156 个、低 16 个。所有事件均附带可验证的源 URL,分类错误率约为 4.8%。数据集以 CSV 和 JSON 格式提供,包含元数据和被拒绝的条目。该数据集适用于 AI 安全研究、事件分类模型训练、安全趋势分析等任务。
The AI Agent Security Incident Database (v0.3) is an open-source dataset focusing on AI agent security incidents, containing 1,018 classified events, updated daily, and licensed under CC BY 4.0. Data is sourced from CVE/NVD, GitHub Advisories, HackerNews, and 26 other security sources, automatically collected and classified via a fully local pipeline (using Ollama and Llama 3.1 8B model, CPU only). Events are categorized into 21 classes, including API vulnerabilities (312), unauthorized operations (144), configuration vulnerabilities (141), data leaks (106), prompt injections (78), sandbox escapes (72), agent escapes (52), etc. Severity distribution: 81 critical, 765 high, 156 medium, 16 low. All events include verifiable source URLs, with a classification error rate of approximately 4.8%. The dataset is provided in CSV and JSON formats, including metadata and rejected entries. It is suitable for AI security research, incident classification model training, security trend analysis, and other tasks.
AI Agent 安全事件数据库 (v0.3)
数据集概览
- 许可协议: CC BY 4.0
- 任务类型: 文本分类
- 语言: 英语
- 数据规模: 少于 1,000 条
- 更新频率: 每日更新
核心内容
该数据集包含 1,018 条已分类的 AI Agent 安全事件记录,通过完全本地化的流水线(CPU-only,使用 Ollama + Llama 3.1 8B 模型)从 CVE/NVD、GitHub Advisories、HackerNews 等 26 个安全信息源 自动收集并分类。
关键统计(截至 2026 年 8 月 22 日)
- 1,018 条已接受事件(另有 51 条因过于模糊被拒绝)
- 82 条严重(critical)级别事件
- 受影响最多的厂商:NVIDIA (48)、OpenAI (46)、TensorFlow (44)、Microsoft (23)、Anthropic (13)
- 共 21 个事件类别,包含 LLM 发现的新模式
- 100% 的事件附带可验证的来源 URL
- 分类错误率:约 4.8%
事件类别分布
| 类别 | 数量 |
|---|---|
| api_exploit | 312 |
| unauthorized_action | 144 |
| configuration_exploit | 141 |
| data_exfiltration | 106 |
| prompt_injection | 78 |
| sandbox_escape | 72 |
| agent_escape | 52 |
| command_injection | 35 |
| security_by_obscurity | 34 |
| path_traversal | 10 |
| denial_of_service | 9 |
| injection | 7 |
| cross_site_scripting | 4 |
| supply_chain | 4 |
| model_manipulation | 4 |
| slopsploit_attack_chain | 1 |
| adversarial_examples | 1 |
分类器发现了原始分类体系中不存在的新类别,包括 slopsploit_attack_chain(利用存在漏洞的 LLM 生成代码进行攻击)和 adversarial_examples。
严重级别分布
| 严重级别 | 数量 |
|---|---|
| critical | 81 |
| high | 765 |
| medium | 156 |
| low | 16 |
方法论
- 通过 API 和 RSS 从 26 个公开信息源自动收集
- 使用 Llama 3.1 8B 模型(本地、设备端)进行 AI 分类
- 归一化处理:统一值类型和严重级别
- 质量过滤:拒绝模糊条目,拆分复合条目
- 被拒绝的条目单独提供,保持透明度
已知局限性
- 自动化分类(8B 模型)可能存在错误
- 严重级别分布偏斜:75% 被归类为 high
- 部分 CVE 可能并非专门针对 AI Agent
- 覆盖时间范围为 2026 年,正在向历史数据扩展
数据文件
- ai_agent_security_incidents_v0.1.csv — 1,018 条已接受事件
- AISI_v0.1_20260822.json — 完整数据集,包含元数据及被拒绝的条目
版本更新记录
- v0.3(8月22日):1,018 条事件,错误率 4.8%,发现新类别
- v0.2(8月20日):981 条事件,26 个信息源,错误率 4.2%
- v0.1(8月18日):98 条事件,10 个信息源,错误率 8.4%
相关资源
- 流水线及 n8n CVE 扫描器 v2.0 代码仓库:https://github.com/Legion33shadow/legion-n8n-shield