loc_chronicling_america_1770-1810_issues
收藏资源简介:
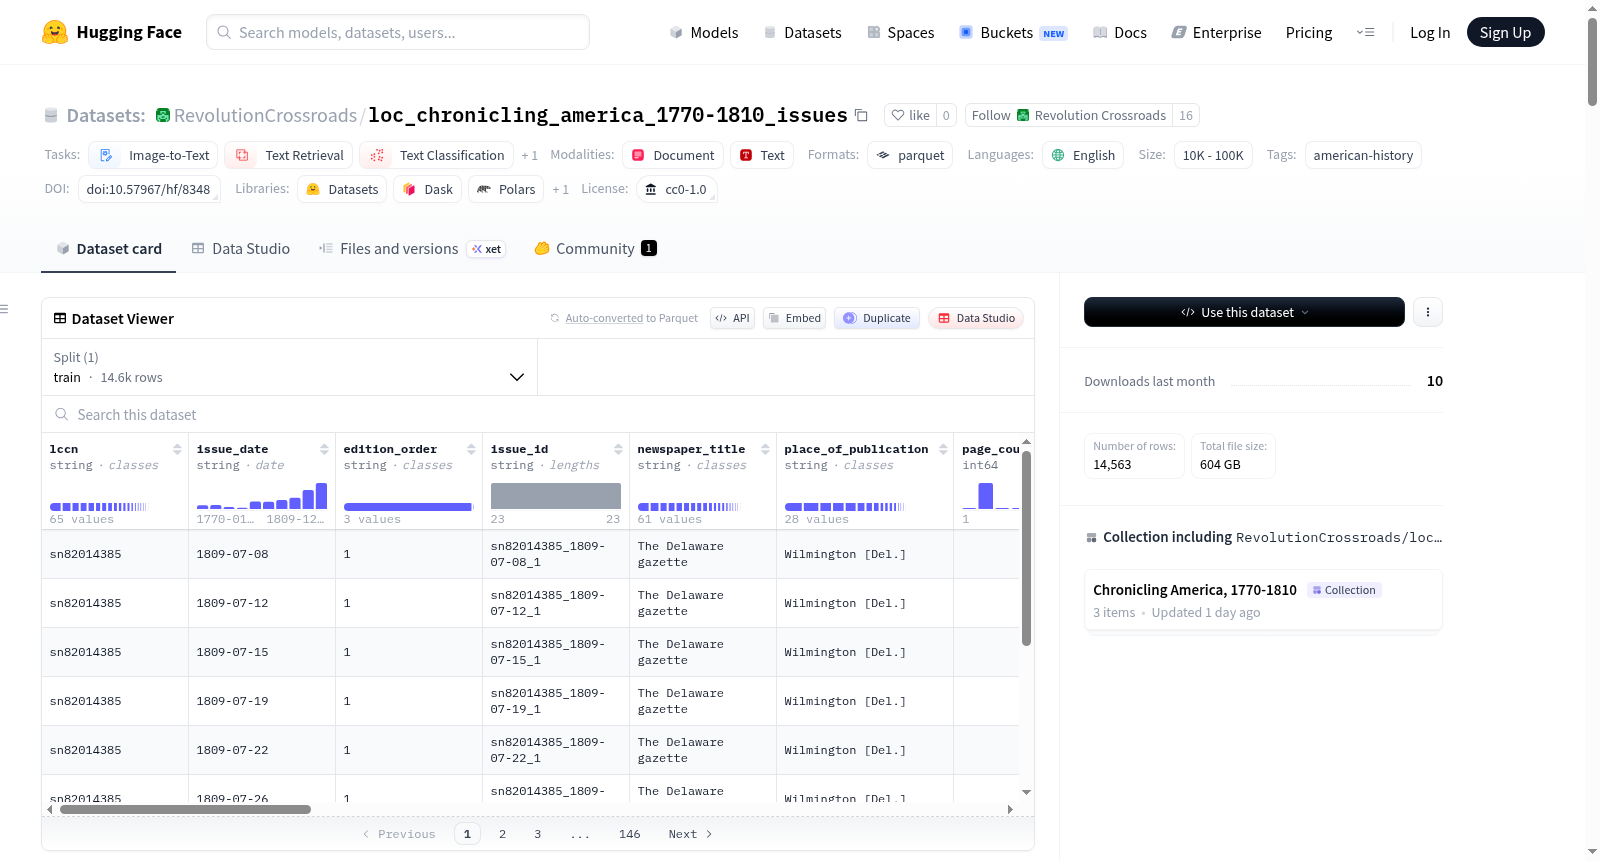
该数据集来源于美国国会图书馆的Chronicling America数字收藏,是国家数字报纸计划(NDNP)的一部分。数据集提供了1770年至1810年间出版的报纸的期级表示,将单个页面记录聚合为完整的报纸期次,包含OCR文本和出版元数据。数据集由史密森学会为'Revolution Crossroads'项目准备,基于公开可用的Chronicling America历史美国报纸收藏数据。数据集包含14,563个样本,每个记录对应一个报纸期次,包含图书馆控制号(LCCN)、出版日期、版次、期次ID、报纸标题、出版地、页数、期次URL、IIIF清单、缩略图URL、JPEG2000 URL、PDF URL、OCR URL、OCR文本和源记录创建日期等字段。数据集适用于图像到文本、文本检索、文本分类和特征提取等任务。
This dataset is derived from the Chronicling America digital collection of the Library of Congress, and is part of the National Digital Newspaper Program (NDNP). It provides issue-level representations of newspapers published between 1770 and 1810, aggregating individual page records into complete newspaper issues, and includes OCR text and publication metadata. This dataset was prepared by the Smithsonian Institution for the 'Revolution Crossroads' project, based on publicly available data from the Chronicling America historical American newspaper collection. It contains 14,563 samples, where each record corresponds to a newspaper issue, and includes fields such as Library of Congress Control Number (LCCN), publication date, edition number, issue ID, newspaper title, place of publication, page count, issue URL, IIIF manifest, thumbnail URL, JPEG2000 URL, PDF URL, OCR URL, OCR text, and source record creation date. This dataset is applicable to tasks such as image-to-text, text retrieval, text classification, and feature extraction.
数据集概述:Chronicling America Historic American Newspapers 1770–1810 - Issue-Level
数据集基本信息
- 数据集名称:Chronicling America Historic American Newspapers 1770–1810 - Issue-Level
- 提供者/共享者:Revolution Crossroads(史密森尼学会数字与创新办公室人员准备)
- 数据来源:美国国会图书馆 Chronicling America 历史美国报纸数字馆藏(国家数字报纸计划 NDNP 的一部分)
- 语言:英语
- 许可协议:CC0 1.0(公共领域)
- 任务类别:图像到文本、文本检索、文本分类、特征提取
- 标签:美国历史
- 规模类别:10K < n < 100K
数据集内容与范围
- 时间范围:1770年至1810年间出版的报纸。
- 数据层级:报纸“期”级别(Issue-Level)。该数据集是对原始页面级数据集的重构,将单个页面记录聚合为完整的报纸期次。
- 数据量:包含14,563个样本(即报纸期次记录)。
- 数据大小:下载大小约为845 MB,数据集大小约为1.16 GB。
- 派生关系:本数据集派生自页面级数据集(https://huggingface.co/datasets/RevolutionCrossroads/loc_chronicling_america_1770-1810)。
数据集结构
- 配置:默认配置(default)。
- 数据分割:仅包含一个“train”分割。
- 特征字段:共16个字段,具体如下:
lccn(string): 报纸标题的美国国会图书馆控制号。issue_date(string): 该期报纸的出版日期。edition_order(string): 当天的版次编号/顺序,默认为1。issue_id(string): 由LCCN、日期和版次衍生的唯一标识符,格式为lccn_issue_date_edition_order。newspaper_title(string): 报纸标题。place_of_publication(string): 出版城市和州。page_count(int64): 该期报纸的页数。issue_url(string): 指向Chronicling America网站上该期报纸的URL。iiif_manifest(string): 该期报纸的IIIF清单URL。thumbnail_url(sequence: string): 该期各页面缩略图URL的列表。jpeg2000_url(sequence: string): 该期各页面JPEG2000 (JP2) 图像URL的列表。pdf_url(sequence: string): 源自源数据集的各页面级PDF URL列表。ocr_url(sequence: string): 由Chronicling America合作机构提供的各页面OCR XML文件URL列表。ocr_text(sequence: string): 从该期所有页面聚合的OCR文本列表,源自原始的Chronicling America OCR。source_record_create_date(date32): 源记录的创建日期。
配套文件
- 在数据集的“文件”选项卡中提供了期级别的PDF文件。
- 这些PDF文件代表完整的报纸期次,由源页面图像编译而成,按报纸的LCCN分组存放,文件名格式为对应的
issue_id(即“titleLCCN_IssueDate_EditionNumber”)。
创建目的与用途
- 创建动因:原始页面级结构无法保留跨页面的文档级上下文。创建此数据集旨在:
- 保留跨页面的文档级上下文。
- 支持在期级别进行OCR和文本提取工作流。
- 支持跨完整报纸期次进行实体识别和分析。
- 项目背景:本数据集是为“Revolution Crossroads”项目(https://www.si.edu/revolution-crossroads)所准备。
使用注意事项
- 内容风险:数据集包含历史材料,其中的语言可能不符合所描绘社区成员的偏好,可能包含负面刻板印象或冒犯性词语。这些材料反映的是其创建者的观点。
- 数据质量:文本由光学字符识别(OCR)生成,存在错误,特别是在源图像质量不佳或排版特殊时。1810年以前出版的内容可能因历史排版(如类似“f”的“长s”字符)导致文本误读。
- 建议:在准确性至关重要时,研究人员应依据图像验证提取的信息,并谨慎对待OCR文本的完整性和权威性。建议查阅Chronicling America馆藏以获取最新记录。
引用信息
- BibTeX:参见README文件内容。
- APA:Revolution Crossroads Project Team. (2025). Chronicling America: Historic American Newspapers 1770–1810 - Issue-level [Data set]. Hugging Face.
联系方式
- revolutioncrossroads@si.edu