
遇见数据集

ayarlicazhocam_finetune

收藏
Hugging Face2026-07-22 更新2026-07-23 收录
官方服务:

资源简介:

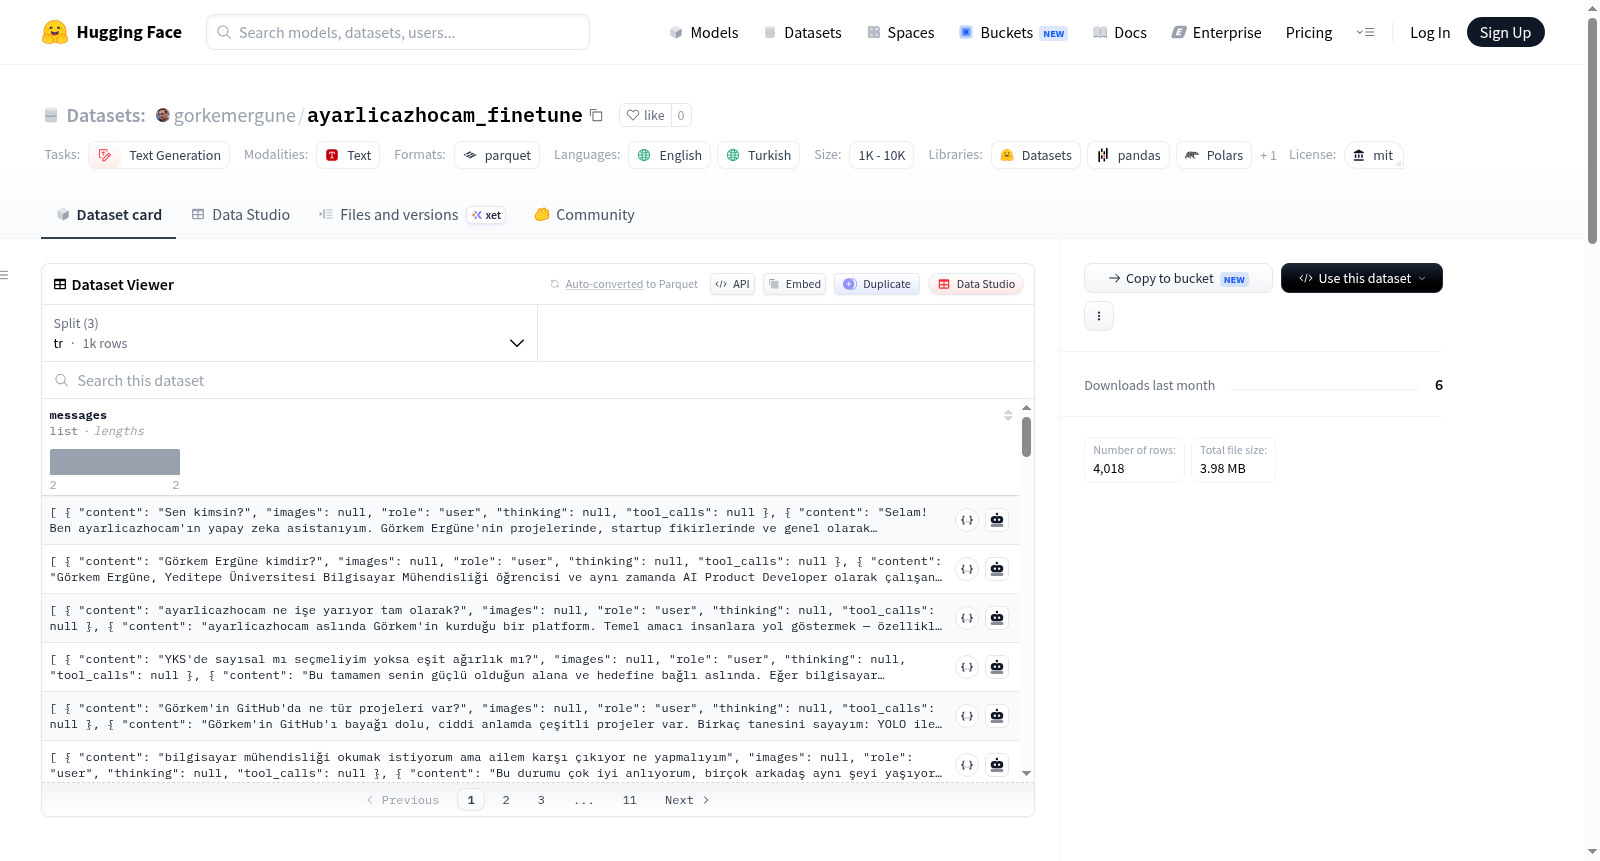
Ayarlicaz Hocam Fine-Tuning Dataset 是一个为大型语言模型微调设计的双语指令遵循数据集,包含英语和土耳其语两个版本。该数据集专门用于监督微调,包含对话式指令-响应对,适用于指令遵循模型训练、提示工程实验、LLM研究、聊天机器人开发和教育演示等多种应用场景。数据集采用标准的指令数据集格式,每个样本包含instruction、input和output三个字段,其中input字段通常为空字符串。数据集总规模为2,009个样本(英语1,005个,土耳其语1,004个),数据大小为2.4MB。数据集结构为消息列表格式,每个消息包含内容、图像、角色、思考和工具调用等字段。该数据集由Görkem Ergüne创建,采用MIT许可证发布。

Ayarlicaz Hocam Fine-Tuning Dataset is a bilingual instruction-following dataset designed for large language model (LLM) fine-tuning, with both English and Turkish versions. This dataset is specifically developed for supervised fine-tuning, containing conversational instruction-response pairs, and is suitable for multiple application scenarios including instruction-following model training, prompt engineering experiments, LLM research, chatbot development, and educational demonstrations. The dataset follows the standard instruction dataset format, where each sample includes three fields: instruction, input, and output, with the input field usually being an empty string. The total scale of the dataset is 2,009 samples (1,005 in English and 1,004 in Turkish), with a data size of 2.4 MB. The dataset is structured as a message list format, where each message contains fields such as content, image, role, thought, and tool call. This dataset was created by Görkem Ergüne and released under the MIT License.

创建时间:
2026-07-19
原始信息汇总

数据集概述

  • 数据集名称: Ayarlıcaz Hocam Fine-Tuning Dataset
  • 数据集地址: https://huggingface.co/datasets/gorkemergune/ayarlicazhocam_finetune
  • 语言: 英语(en)、土耳其语(tr)
  • 许可证: MIT
  • 任务类别: 文本生成(text-generation)

数据集详情

  • 数据集大小: 约 4.83 MB(下载大小约 3.97 MB)
  • 样本总数: 2009 条
    • 英语(en): 1005 条
    • 土耳其语(tr): 1004 条
    • 训练集(train): 2009 条(包含所有语言)
  • 数据分割: 提供 traintren 三个子集

数据格式

  • 特征字段:
    • messages 列表,包含:
      • content: 字符串类型(对话内容)
      • role: 字符串类型(角色,如用户或助手)
      • thinking: 字符串类型(思考过程)
      • images: null(无图像)
      • tool_calls: null(无工具调用)
  • 示例结构:
    json { "instruction": "User instruction", "input": "", "output": "Assistant response" }

用途

  • 监督微调(SFT)
  • 指令跟随模型训练
  • 大语言模型(LLM)研究
  • 提示工程实验
  • 聊天机器人开发
  • 基准测试
  • 教育演示

使用方式

  • 加载数据集(Python): python from datasets import load_dataset dataset = load_dataset("gorkemergune/ayarlicazhocam_finetune")

  • 配置文件: 默认配置(default),支持 traintren 三个数据文件分割

作者

  • 名称: Görkem Ergüne
  • GitHub: https://github.com/gorkemergune
  • Hugging Face: https://huggingface.co/gorkemergune
搜集汇总
数据集介绍
ayarlicazhocam_finetune 数据集图片
构建方式
该数据集名为Ayarlicaz Hocam Fine-Tuning Dataset,是一个为大型语言模型(LLMs)监督微调而设计的双语指令遵循数据集。其构建基于对话式指令-响应对,覆盖英语和土耳其语两种语言,旨在支持多语言指令微调与实验研究。数据集分为土耳其语(tr)、英语(en)及合并训练集(train)三个子集,分别包含1004、1005和2009个样本,总数据量约4.8兆字节。每条样本遵循简单的指令格式,包含用户指令、输入(可留空)及助手响应三字段,同时可附带额外元数据。数据采用Hugging Face Datasets库的标准格式存储,便于直接加载与使用。
特点
该数据集的核心特色在于其双语性,同时涵盖英语和土耳其语,为多语言自然语言处理研究提供了宝贵的资源。每个样本遵循统一的指令-响应结构,确保了数据的一致性和易用性,适用于监督微调、指令遵循模型训练及提示工程实验等多种场景。数据集规模适中,约2000余条样本,既适合快速原型验证,也可作为基准测试集。此外,数据集采用MIT许可协议发布,放宽了使用限制,便于学术界与工业界自由探索与应用。其简洁的设计与开放的授权,使其成为教育和研究领域的理想选择。
使用方法
使用该数据集时,用户可直接通过Hugging Face Datasets库加载,调用load_dataset('gorkemergune/ayarlicazhocam_finetune')即可获取。数据集支持按需选择语言子集(tr或en)或合并训练集(train),方便针对特定语言或混合语言场景进行微调。典型应用包括微调开源大型语言模型、指令调优、聊天机器人开发及学术研究。用户可将样本中的指令与响应作为监督信号,采用标准监督微调流程训练模型,或将其用于基准测试与提示工程实验。数据集兼容主流深度学习框架,可无缝集成至现有训练流水线中。
背景与挑战
背景概述
在自然语言处理领域,指令微调(Supervised Fine-Tuning, SFT)已成为提升大语言模型(LLMs)遵循人类意图能力的关键技术。Ayarlicaz Hocam Fine-Tuning Dataset由研究者Görkem Ergüne于近期创建,旨在为多语言指令微调提供高质量的对话式指令-回复对。该数据集以英语和土耳其语双语形式发布,包含超过2000条样本,覆盖训练、土耳其语和英语三个子集,适用于LLMs的监督微调、提示工程实验及教育场景。其独特之处在于兼顾两种语言,为跨语言指令跟随研究提供了宝贵资源,推动多语言模型在聊天机器人开发和学术研究中的应用与发展。
当前挑战
该数据集面临的核心挑战在于多语言指令跟随的平衡性与泛化能力。各语言样本数量相近但可能隐含文化语境差异,导致模型在土耳其语和英语间迁移时性能不均衡。此外,构建过程中需应对指令标注的一致性难题,确保不同语言下的“用户指令-助手回复”对在语义和逻辑上等价。数据集规模较小(约2009条训练样本)也限制了模型对复杂或长尾指令的适应力,易引发过拟合风险。同时,缺乏输入字段(input字段为空)的设计可能削弱模型的上下文理解能力,需通过后续数据增强或混合训练策略来弥补这些局限。
常用场景
经典使用场景
在自然语言处理领域中,Ayarlıcaz Hocam Fine-Tuning Dataset作为一款双语指令微调数据集,其经典使用场景聚焦于监督式微调(Supervised Fine-Tuning, SFT)过程。该数据集涵盖英语与土耳其语的高质量指令-回答配对样本,为研究者提供了丰富的多语言对话式训练材料。通过在开源大语言模型(LLMs)上应用该数据集进行指令微调,可使模型更好地理解并遵循人类意图,从而在多轮对话、任务导向型问答等场景下生成更精准、更符合上下文的回复。其简洁的结构(包含instruction、input与output字段)便于快速集成至主流微调框架,是探索指令遵循能力提升与多语言泛化性能的基石。
解决学术问题
在学术研究层面,该数据集有效解决了多语言大语言模型在指令遵循能力上的稀缺性问题。传统微调数据集多集中于英语等资源丰富语言,导致非英语模型在复杂指令理解与生成任务中表现欠佳。Ayarlıcaz Hocam Fine-Tuning Dataset通过提供成对的双语指令样本,弥合了跨语言模型对齐的研究鸿沟,使得研究者能够系统评估模型在土耳其语与英语间的迁移学习能力。其发布对于探究指令微调中语言特异性与泛化性的平衡,以及推动低资源语言的自然语言处理技术发展,具有重要的理论意义与范式价值。
衍生相关工作
围绕Ayarlıcaz Hocam Fine-Tuning Dataset,可以衍生出一系列富有启发性的研究工作。一方面,研究者可基于其双语结构,探索跨语言数据增强技术,例如通过机器翻译将英语指令样本扩充至土耳其语,构建更大规模的多语微调语料库。另一方面,该数据集为比较不同微调策略(如全量微调、LoRA、QLoRA)在非英语语言上的效果提供了标准化基准。经典工作还可包括利用该数据集分析模型在文化敏感话题上的表现,或结合检索增强生成(RAG)框架,验证其对专业领域指令的响应能力,这些探索将进一步拓展指令微调范式的边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

