遇见数据集

task4_training_data_conversation_input

收藏
Hugging Face2025-11-05 更新2025-11-06 收录
官方服务:

资源简介:

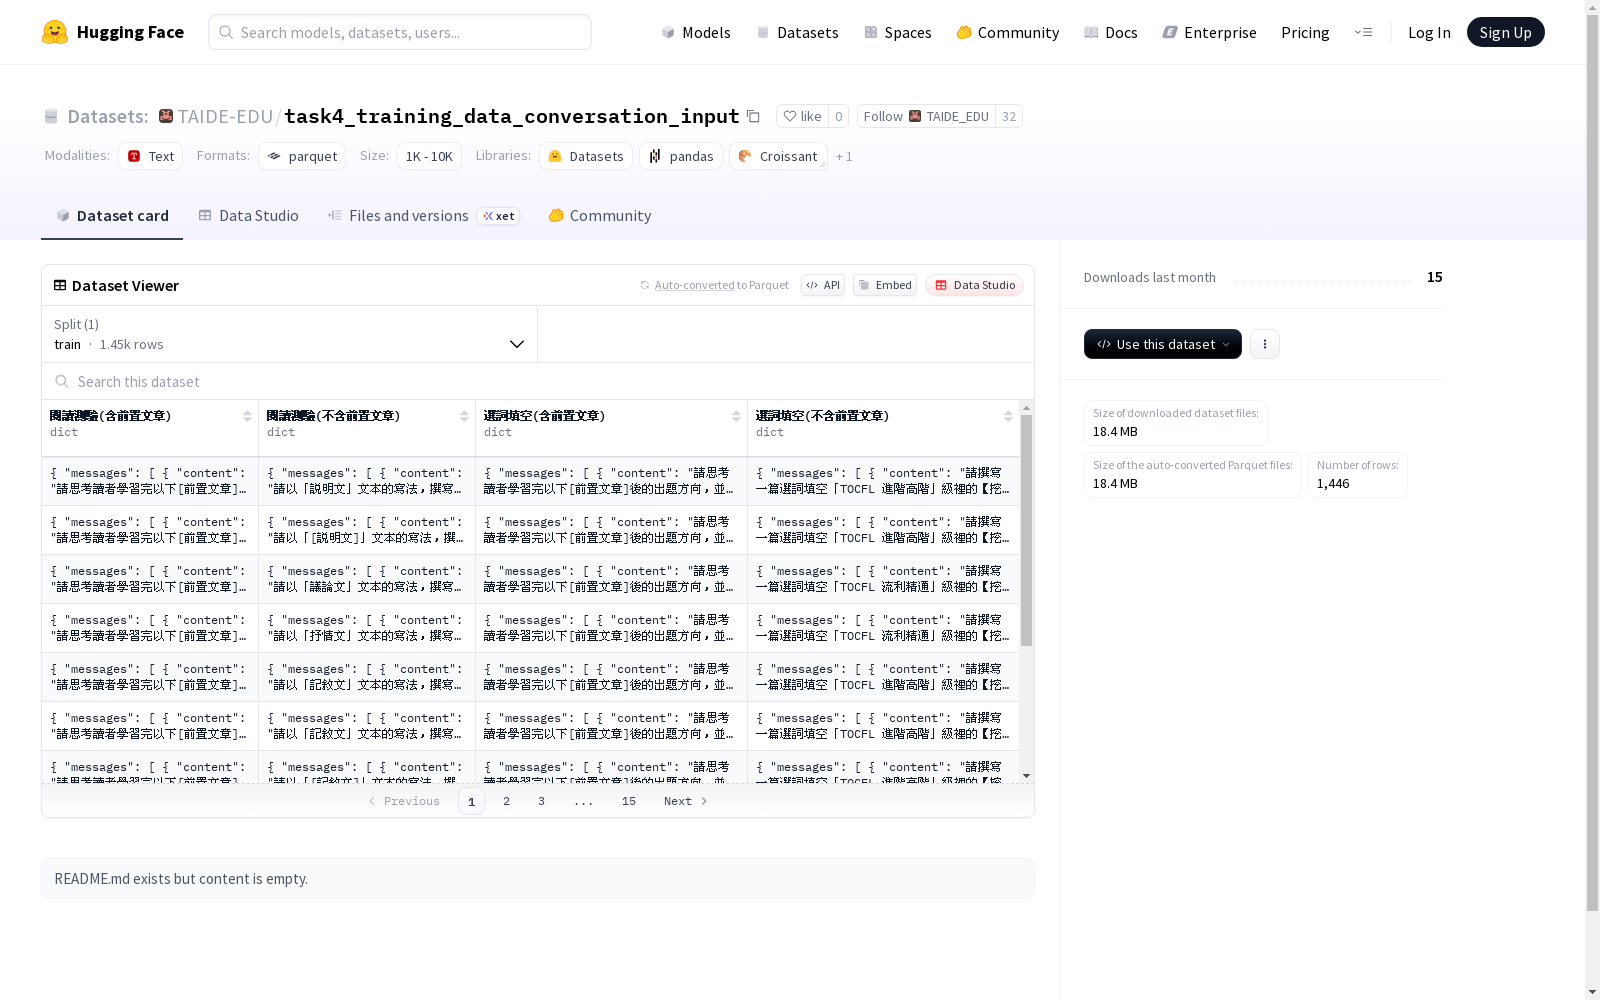
这是一个包含阅读测试和选词填空题型的教育数据集。每种题型又分为含前置文章和不含前置文章两种情况。数据集提供了文章的主题、文体、难度等级评估以及详细的题目和答案信息。阅读测试包括文章内容、题目描述、题目类别、题目选项和答案等。选词填空题型包括完整文章、挖空后的文章、题目句、题目选项和答案等。此外,数据集还提供了训练集的统计信息,如示例数量和文件大小。

This is an educational dataset covering reading comprehension tests and cloze tests. Each question type is divided into two scenarios: with a preceding passage and without a preceding passage. The dataset provides information such as the topic, genre, and difficulty level assessment of the passages, as well as detailed question and answer details. Reading comprehension tests include passage content, question descriptions, question categories, answer options, and correct answers. Cloze tests include complete passages, passages with blanks, question sentences, answer options, and correct answers. Additionally, the dataset provides statistical information for the training set, such as the number of samples and file size.

创建时间:
2025-10-26
原始信息汇总

数据集概述

基本信息

  • 数据集名称: task4_training_data_conversation_input
  • 数据集地址: https://huggingface.co/datasets/TAIDE-EDU/task4_training_data_conversation_input
  • 训练集样本数量: 1446
  • 训练集大小: 38409024字节
  • 下载大小: 18351184字节

数据结构特征

1. 閱讀測驗(含前置文章)

  • 消息列表
    • 内容字段: 字符串类型
    • 角色字段: 字符串类型
  • 元数据
    • 固定困惑度: 浮点数类型
    • 生成困惑度: 浮点数类型
    • 前置课文信息
      • 内容: 字符串类型
      • 等级: 字符串类型
      • 子主题: 字符串类型
      • 标题: 字符串类型
      • 主题: 字符串类型
    • 文章: 字符串类型
    • 文章主题: 字符串类型
    • 文章主题类别: 字符串类型
    • 文章文体: 字符串类型
    • 等级评估结果
      • 入门基础: 浮点数类型
      • 流利精通: 浮点数类型
      • 进阶高阶: 浮点数类型
    • 华策会等级: 字符串类型
    • 题目列表
      • 选项A: 字符串类型
      • 选项B: 字符串类型
      • 选项C: 字符串类型
      • 选项D: 字符串类型
      • 答案: 字符串类型
      • 答案转移: 字符串类型
      • 解析: 字符串类型
      • 题目描述: 字符串类型
      • 题目类别: 字符串类型
      • 题号: 整数类型

2. 閱讀測驗(不含前置文章)

  • 结构与"閱讀測驗(含前置文章)"相同

3. 選詞填空(含前置文章)

  • 消息列表
    • 内容字段: 字符串类型
    • 角色字段: 字符串类型
  • 元数据
    • 固定困惑度: 浮点数类型
    • 生成文章困惑度: 浮点数类型
    • 生成问题困惑度: 浮点数类型
    • 前置课文信息
      • 内容: 字符串类型
      • 等级: 字符串类型
      • 子主题: 字符串类型
      • 标题: 字符串类型
      • 主题: 字符串类型
    • 完整文章: 字符串类型
    • 挖空后的文章: 字符串类型
    • 等级评估结果
      • 入门基础: 浮点数类型
      • 流利精通: 浮点数类型
      • 进阶高阶: 浮点数类型
    • 华策会等级: 字符串类型
    • 题目列表
      • 选项A: 字符串类型
      • 选项B: 字符串类型
      • 选项C: 字符串类型
      • 选项D: 字符串类型
      • 答案: 字符串类型
      • 答案转移: 字符串类型
      • 解析: 字符串类型
      • 题目句: 字符串类型
      • 题号: 整数类型

4. 選詞填空(不含前置文章)

  • 结构与"選詞填空(含前置文章)"相同

配置信息

  • 默认配置名称: default
  • 数据文件路径: data/train-*
搜集汇总
数据集介绍
task4_training_data_conversation_input 数据集图片
构建方式
在语言教育技术领域,task4_training_data_conversation_input数据集通过系统化方法构建,涵盖阅读测验和选词填空两种任务类型,每种任务均包含含前置文章与不含前置文章的变体。数据收集过程整合了多层级语言材料,包括文章内容、题目列表及详细元数据,并引入困惑度指标和等级评估体系,确保数据在语言复杂度与教育适用性上的科学性。构建过程中注重结构一致性,采用标准化字段记录主题、文体、难度等级等信息,为模型训练提供丰富而规范的输入。
特点
该数据集在语言学习资源中展现出多维特征,其核心在于融合对话式交互结构与教育评估维度。每个样本均包含完整的消息序列和元数据,其中消息序列模拟真实对话场景,元数据则涵盖文章主题类别、文体分类及华策会等级等教育属性。独特之处在于集成困惑度计算与三级能力评估(入门基础、流利精通、进阶高阶),并针对不同教学场景提供有无前置文章的对比数据,为研究语言模型在教育领域的适应性提供了细粒度分析基础。
使用方法
针对自然语言处理在教育领域的应用,该数据集可通过加载标准数据分割进行模型训练与评估。使用者可直接调用训练集路径访问1446个样本,利用消息字段构建对话生成任务,或结合元数据中的题目列表与解析字段开发阅读理解模型。对于选词填空任务,挖空后文章与完整文章的对照设计支持词汇预测研究,而等级评估结果与困惑度指标则为模型性能验证提供了量化基准,适用于多任务学习框架下的教育技术实验。
背景与挑战
背景概述
在语言教育技术快速发展的背景下,task4_training_data_conversation_input数据集应运而生,专注于中文阅读理解和对话生成任务。该数据集由教育技术研究机构构建,旨在通过多模态任务设计,如阅读测验和选词填空,提升语言模型的交互能力。其结构包含丰富的元数据,如文章主题、文体分类和等级评估,反映了对语言学习层次化的深入探索。这一资源推动了自适应教育系统的发展,为个性化学习路径的优化提供了数据支撑。
当前挑战
该数据集致力于解决语言模型在阅读理解与对话生成中的语义连贯性挑战,特别是在处理多轮交互和上下文依赖时易出现偏差。构建过程中,确保题目与文章逻辑一致、难度分级准确面临巨大困难,需平衡语言复杂性和教育适用性。同时,数据标注的精确性和多样性要求高,涉及大量人工校验以避免噪声干扰,这对资源分配和质量控制构成了显著压力。
常用场景
经典使用场景
在语言教育技术领域,该数据集通过精心设计的阅读理解和选词填空任务,为中文作为第二语言的教学研究提供了重要支撑。其独特的对话式交互结构模拟真实学习场景,使研究者能够深入分析学习者在不同语言层级上的认知过程。数据集包含的多元化题型设计,特别是含前置文章与不含前置文章的对比设置,为探究背景知识对语言理解的影响机制创造了理想实验条件。
衍生相关工作
基于该数据集的丰富特征,学界涌现出多项创新研究。在语言模型优化方面,研究者利用其对话结构和难度分级数据,开发了更具教学敏感性的预训练方法。教育数据挖掘领域的研究者则通过分析学习者的答题模式,建立了语言能力发展预测模型。此外,该数据集还催生了多项关于知识迁移和跨任务学习的研究,推动了教育人工智能技术的交叉融合发展。
数据集最近研究
最新研究方向
在语言教育技术领域,task4_training_data_conversation_input数据集正推动自适应学习系统的前沿探索。该数据集通过整合阅读测验与选词填空任务,结合前置课文信息、多层级难度评估和困惑度指标,为构建个性化语言学习模型提供了结构化基础。当前研究聚焦于利用其丰富的元数据特征,开发能够动态调整教学内容的生成式AI系统,这些系统通过分析学习者的认知水平和任务表现,实现精准的知识点推荐与反馈生成。随着教育数字化转型加速,此类数据集在提升语言习得效率、减少认知负荷方面展现出深远潜力,尤其在中文作为第二语言的教学场景中,为智能辅导工具的优化与评估奠定了实证基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务