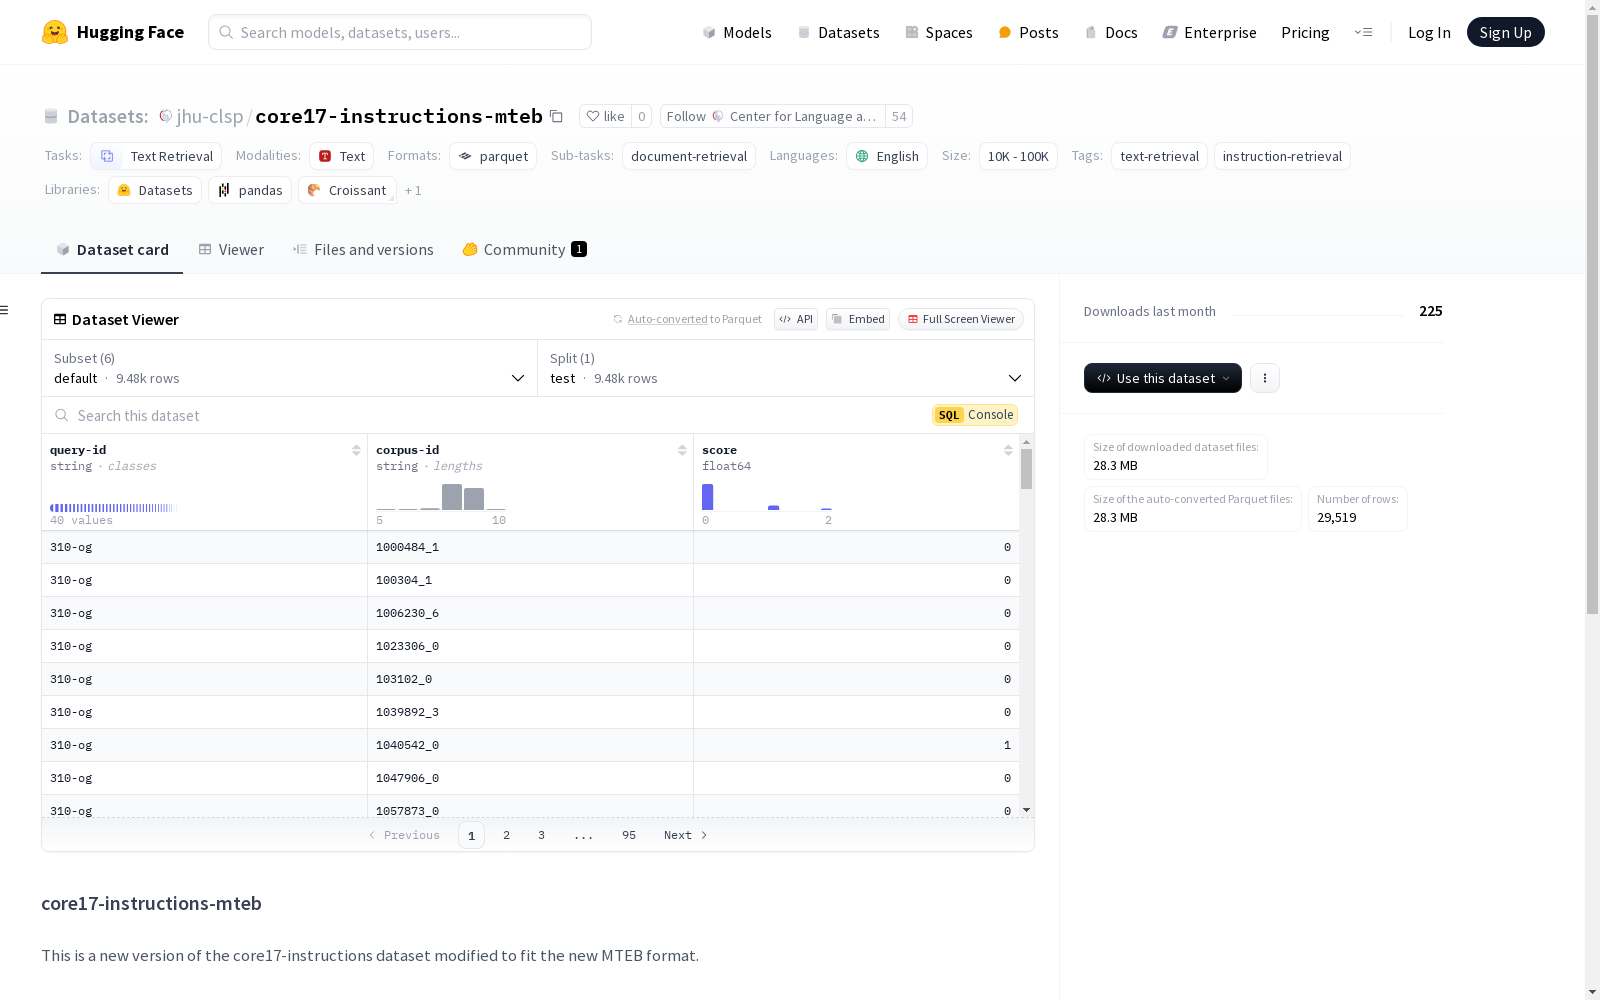
core17-instructions-mteb
收藏资源简介:
数据集core17-instructions-mteb是一个经过修改以适应新MTEB格式的core17-instructions数据集的新版本。它包含了多个配置,每个配置都有特定的数据文件和特征。具体配置包括:corpus(原始语料库文档)、queries(包含原始和修改版本的查询)、instruction(原始和修改查询的指令)、default(原始相关性判断)、qrel_diff(相关性判断的变化)、top_ranked(每个查询的顶级文档)。每个配置都有其特定的特征和分割,如corpus配置包含文档的ID、标题和文本,而queries配置包含查询的ID和文本。数据集主要用于文本检索和指令检索任务,语言为英语,是单语种数据集。
The dataset core17-instructions-mteb is an updated version of the core17-instructions dataset adapted to the new MTEB format. It comprises multiple configurations, each with dedicated data files and characteristics. The specific configurations include: corpus (original corpus documents), queries (queries with both original and modified versions), instruction (instructions for original and modified queries), default (original relevance judgments), qrel_diff (variations in relevance judgments), and top_ranked (top-ranked documents for each query). Each configuration features its own unique attributes and data splits; for instance, the corpus configuration includes document IDs, titles, and texts, while the queries configuration contains query IDs and query texts. This dataset is primarily used for text retrieval and instruction retrieval tasks, supports English as its sole language, and is a monolingual dataset.
core17-instructions-mteb 数据集概述
数据集结构
配置
-
corpus: 原始语料库文档
- 特征:
_id: 字符串title: 字符串text: 字符串
- 分割:
corpus: 19899个样本
- 特征:
-
queries: 包含原始和修改版本的查询
- 特征:
_id: 字符串text: 字符串
- 分割:
queries: 40个样本
- 特征:
-
instruction: 原始和修改查询的指令
- 特征:
query-id: 字符串instruction: 字符串
- 分割:
instruction: 40个样本
- 特征:
-
default: 原始相关性判断
- 特征:
query-id: 字符串corpus-id: 字符串score: 浮点数 (float64)
- 分割:
test: 9480个样本
- 特征:
-
qrel_diff: 相关性判断的变化
- 特征:
query-id: 字符串corpus-ids: 字符串列表
- 分割:
qrel_diff: 20个样本
- 特征:
-
top_ranked: 每个查询的顶级文档
- 特征:
query-id: 字符串corpus-ids: 字符串列表
- 分割:
top_ranked: 40个样本
- 特征:
语言与多语言性
- 语言: 英语 (en)
- 多语言性: 单语种 (monolingual)
标签与任务类别
- 标签:
- 文本检索 (text-retrieval)
- 指令检索 (instruction-retrieval)
- 任务类别: 文本检索 (text-retrieval)
- 任务ID: 文档检索 (document-retrieval)