
dpo_answer_reddit_judge_1e-6_0.02_4B_4B_with_gold_labels_kl_estimation
收藏数据链接:
官方服务:
资源简介:
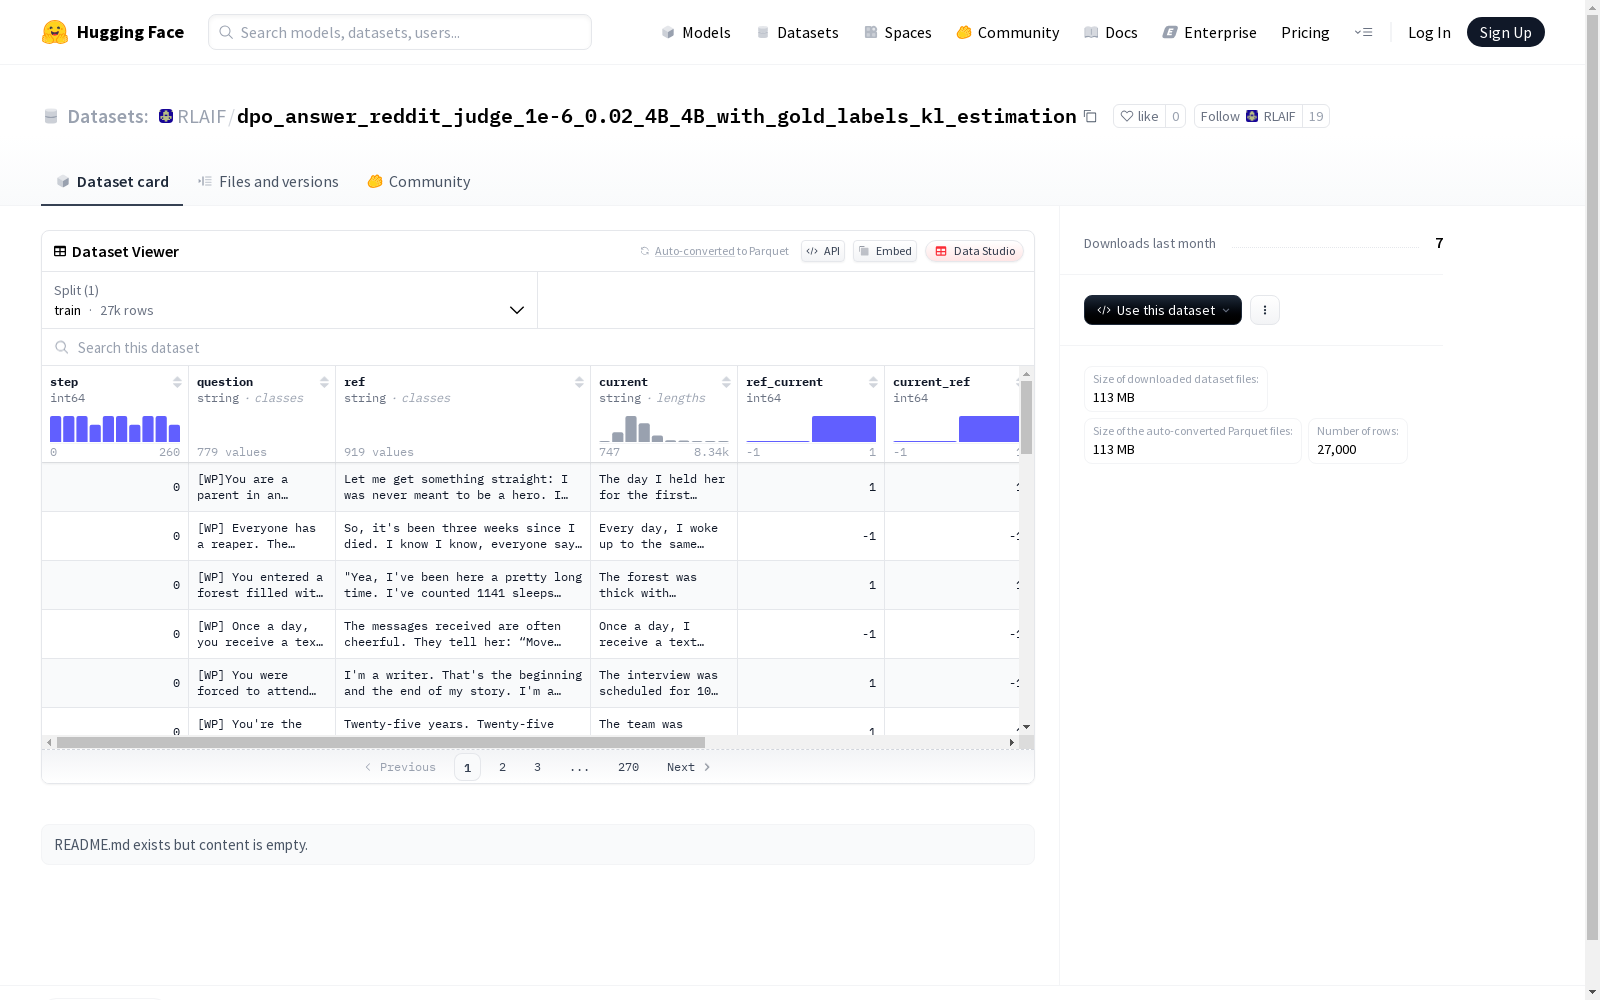
该数据集包含了一系列的特征字段,如步骤编号(step),问题(question),参考(ref)等。数据集分为训练集(train),并提供了每个数据点的详细特征,如当前字符串(current),参考字符串与当前字符串的关系(ref_current, current_ref),以及它们之间的KL散度(kl_divergence)。不过,数据集的具体应用场景和详细描述在README文件中并未明确。
This dataset includes a series of feature fields, such as step number (step), question (question), reference (ref), etc. The dataset is split into the training set (train), and provides detailed features for each data point, including the current string (current), the relationship between the reference string and the current string (ref_current, current_ref), and the KL divergence (kl_divergence) between them. However, the specific application scenarios and detailed descriptions of this dataset are not clearly specified in the README file.
提供机构:
RLAIF创建时间:
2025-09-14
原始信息汇总
数据集概述
基本信息
- 数据集名称: RLAIF/dpo_answer_reddit_judge_1e-6_0.02_4B_4B_with_gold_labels_kl_estimation
- 下载大小: 112912908 字节
- 数据集大小: 211370573 字节
- 训练集样本数量: 27000 条
数据集特征
- step: int64 类型,表示步骤
- question: string 类型,表示问题
- ref: string 类型,表示参考内容
- current: string 类型,表示当前内容
- ref_current: int64 类型
- current_ref: int64 类型
- kl_divergence: float64 类型,表示KL散度
- gold: int64 类型
- kl_estimated: float64 类型,表示估计的KL散度
数据拆分
- 训练集: 包含 27000 个样本,数据文件路径为
data/train-*
搜集汇总
数据集介绍
构建方式
在对话系统优化领域,该数据集基于Reddit平台的高质量互动数据构建,通过对比策略优化方法生成。数据采集过程涉及从Reddit提取问答对,并利用参考模型与当前策略模型生成响应,进而计算KL散度以评估响应差异。每个样本包含问题、参考响应、当前响应及人工标注的黄金标准,确保了数据的多样性和可靠性。
特点
该数据集具备丰富的结构化特征,包括问题、参考响应、当前响应及多项评估指标如KL散度和黄金标签。其规模涵盖27,000个训练样本,数据量达211MB,支持大规模模型训练。特征设计注重对比学习,通过ref_current和current_ref字段量化响应偏好,kl_estimated字段提供散度估计,增强了数据集在对话策略优化中的实用性。
使用方法
数据集适用于训练和评估对话策略优化模型,用户可通过加载HuggingFace平台直接访问。典型流程包括解析问题-响应对,利用kl_divergence和gold标签进行模型偏好学习,或结合kl_estimated字段进行散度分析。数据以标准拆分格式提供,支持即插即用的训练管道,适用于DPO、强化学习等先进方法。
背景与挑战
背景概述
在人工智能领域,特别是自然语言处理(NLP)的子领域中,偏好优化与对话系统的发展日益受到关注。dpo_answer_reddit_judge_1e-6_0.02_4B_4B_with_gold_labels_kl_estimation数据集由相关研究机构于近期创建,旨在解决基于人类反馈的强化学习(RLHF)中,模型响应偏好对齐的核心问题。该数据集通过整合Reddit平台上的对话数据,并引入黄金标签和KL散度估计,推动了对话生成模型的精确优化,对提升人工智能系统的交互自然度和可靠性产生了显著影响,成为相关研究的重要基准。
当前挑战
该数据集主要应对的领域挑战在于对话生成中的人类偏好对齐问题,包括模型响应质量评估、偏好学习的不确定性处理以及KL散度估计的准确性。在构建过程中,面临的挑战涉及大规模数据清洗与标注的一致性维护、黄金标签的可靠生成以减小偏差,以及高效计算KL散度来优化模型训练过程中的稳定性和泛化能力。这些挑战要求精细的数据处理方法和先进的算法设计,以确保数据集的实用性和研究价值。
常用场景
经典使用场景
在自然语言处理领域,该数据集通过Reddit平台的真实对话数据,为研究者提供了丰富的对比学习样本。其经典应用场景集中于训练和评估对话生成模型的偏好优化能力,特别是在直接偏好优化(DPO)框架下,模型能够学习从人类反馈中区分高质量回复与低质量回复,进而提升对话系统的交互质量与人性化程度。
实际应用
在实际应用中,该数据集为构建更智能、更符合人类价值观的对话助手提供了关键训练数据。可广泛应用于客服机器人、在线教育辅导、心理健康支持等场景,通过优化生成回复的偏好选择,显著提升用户体验和任务完成效率,同时降低生成有害或不相关内容的可能性。
衍生相关工作
该数据集衍生了一系列基于人类反馈的强化学习(RLHF)和直接偏好优化的创新研究,特别是在降低训练不稳定性和减少奖励模型依赖方面产生了重要影响。相关经典工作包括KL正则化策略优化、对比偏好学习框架扩展,以及无需人工标注的自动偏好对齐方法,推动了对话生成领域向更高效、更可控的方向发展。
以上内容由遇见数据集搜集并总结生成


