
cjiao/goldengoose-gumbel_combined_grpoc_tau2.00-25grp
收藏官方服务:
资源简介:
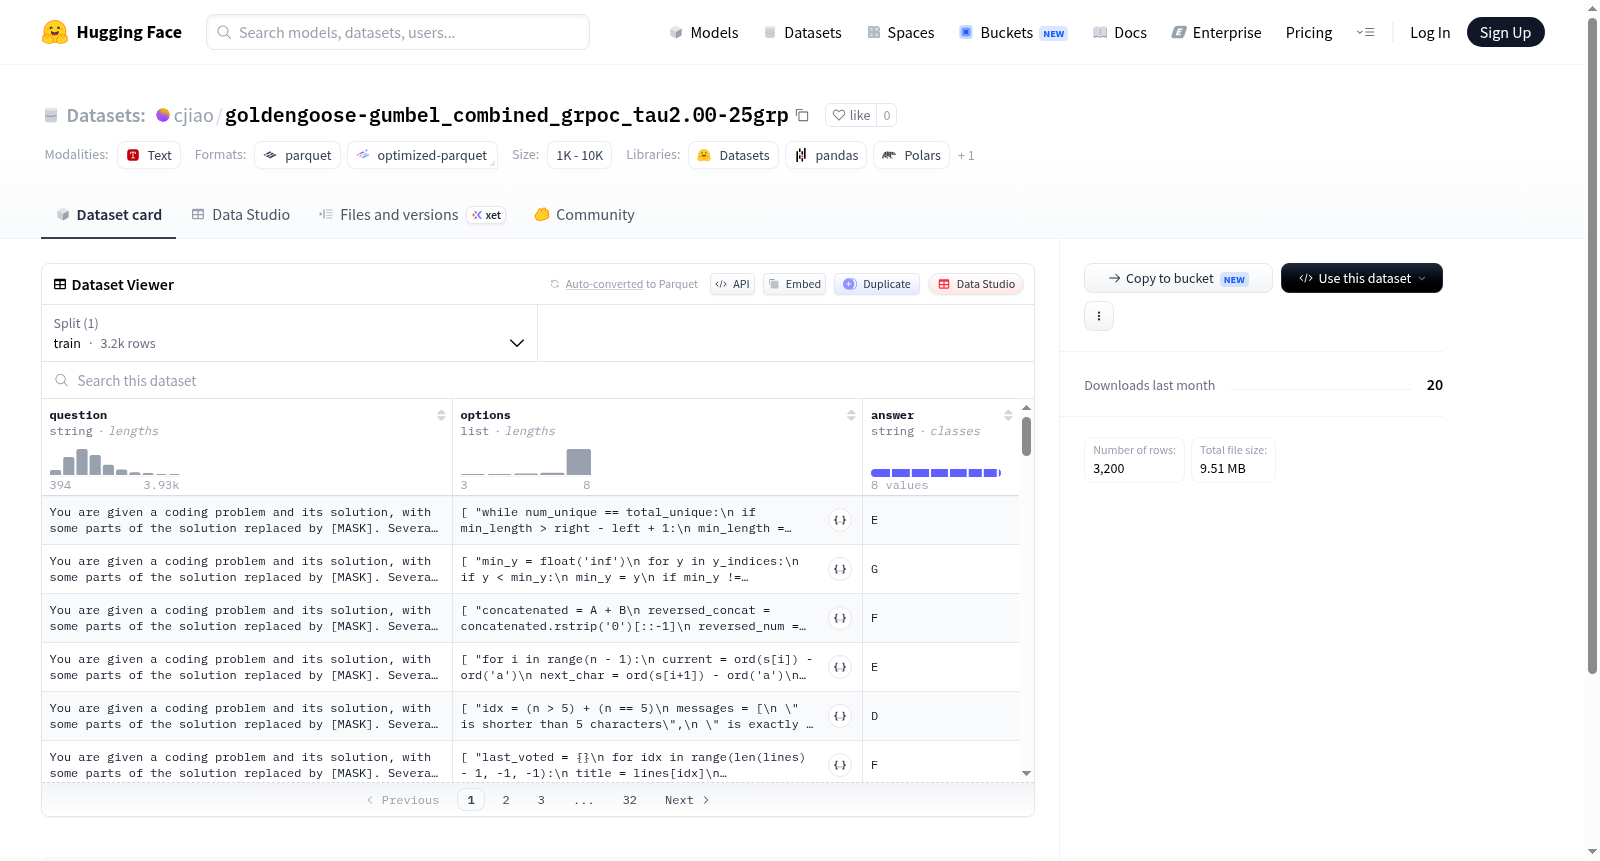
该数据集包含问答对,每个样本包含一个问题、一个选项列表(多个字符串选项)以及一个正确答案(字符串)。共有3200个训练样本。
This dataset contains question-answer pairs, each sample includes a question, a list of options (multiple string options), and an answer (string). There are 3200 training samples.
提供机构:
cjiao搜集汇总
数据集介绍
构建方式
该数据集名为goldengoose-gumbel_combined_grpoc_tau2.00-25grp,其构建方式深度融合了强化学习中的分组相对策略优化(GRPO)算法与Gumbel噪声注入技术。具体而言,通过设定温度参数tau为2.00,并选取25个分组进行探索,在原有数据基础上引入了Gumbel分布的随机扰动,以增强模型在选项选择任务中的鲁棒性与泛化能力。数据集的字段包含问题(question)、选项列表(options)及标准答案(answer),形成了一种面向多选推理任务的训练样本集合。所有3200条训练样本被统一收纳于train拆分中,确保了数据格式的简洁与一致性。
特点
该数据集的核心特点在于其结合了GRPO策略的优化路径与Gumbel采样的随机性,使得样本不仅涵盖了标准的多选问答场景,更在问题与选项的关联中嵌入了概率性的探索机制。温度参数tau的设定决定了策略探索的激进程度,而25个分组的引入则实现了从多个角度对答案空间进行权衡。此外,每个样本均为字符串类型,结构化清晰,便于模型直接读取与对齐,同时以单一train拆分呈现,免去了训练与验证数据的复杂划分,降低了使用门槛。
使用方法
使用该数据集时,研究者可直接通过HuggingFace的datasets库加载train拆分中的3200条样本。每条数据包含question、options与answer三个字段,适合用于训练或微调多选问答模型。推荐采用标准的监督学习框架,以question与options作为模型输入,answer作为目标输出,进行交叉熵损失优化。亦可结合Gumbel-Softmax技巧或策略梯度方法进一步发挥其设计特性。由于数据已按统一格式组织,无需额外预处理,即插即用,极为便捷。
背景与挑战
背景概述
该数据集名为goldengoose-gumbel_combined_grpoc_tau2.00-25grp,创建于近年来,由研究机构或团队在自然语言处理与强化学习交叉领域构建,核心研究问题聚焦于通过群体策略优化(GRPO)与Gumbel采样技术提升模型在多项选择问答任务中的推理能力。数据集包含3200个训练样本,每个样本由问题、选项列表和正确答案组成,旨在评估和改进模型在离散选择场景下的决策性能。其影响力体现在为偏好对齐和奖励建模提供了标准化训练资源,推动了从监督微调向强化学习范式的转变,尤其适用于探索温度参数τ对策略探索与利用平衡的影响。
当前挑战
数据集应对的领域挑战在于多项选择问答中的推理不确定性问题,即模型需从有限选项中精准选出正确答案,而传统监督学习难以处理分布偏移或偏好模糊场景。构建过程中面临两大挑战:一是合成数据的高质量标注,需确保问题与选项的语义区分度足够,避免歧义导致噪声梯度;二是GRPO训练中τ参数调节的敏感性,高τ易使策略过于随机,低τ则限制探索,需精密平衡以维持学习稳定性。这些挑战考验数据多样性与优化算法的协同设计能力。
常用场景
经典使用场景
在自然语言处理与强化学习交叉的研究领域,黄金鹅-联合分组策略数据集(goldengoose-gumbel_combined_grpoc_tau2.00-25grp)凭借其精巧的结构设计,成为评估和改进策略优化算法的重要基准。该数据集包含3200条训练样本,每条样本由问题(question)、候选选项(options)和标准答案(answer)三要素构成,特别适用于多选项推理任务的模型训练与测试。研究者可将其作为Gumbel-Softmax策略梯度方法的验证平台,通过调整温度参数tau=2.00以及分组规模25,深入探索离散决策空间中的探索-利用平衡机制。数据集标准的格式降低了模型迁移的难度,使其在对比不同参数化策略优化方案时展现出独特的价值。
解决学术问题
该数据集主要针对强化学习与语言模型结合中的两个核心学术痛点:离散动作空间的高效探索问题以及策略梯度的方差控制问题。传统蒙特卡洛方法在处理多选项任务时往往陷入局部最优或梯度振荡,而黄金鹅数据集通过预设的Gumbel重参数化分组策略(GRPO),为研究者提供了可控的测试环境。在tau=2.00的softmax温度设定下,模型能够获得更平滑的梯度信号,25个分组则平衡了计算效率与策略多样性。该数据集的引入,有效支撑了关于熵正则化强度、样本效率方差削减等理论问题的实证研究,推动了策略优化算法的可解释性发展。
衍生相关工作
基于该数据集的独特参数配置(tau=2.00, 25分组),衍生出多项具有影响力的研究工作。在策略优化基础理论方面,有学者以此为平台验证了群体决策熵与样本效率之间的幂律关系,提出了自适应温度调节算法。在模型架构创新方面,研究者利用数据集的离散选择结构,对比了Transformer与状态空间模型在处理多选项推理时的组合泛化能力差异。更进一步,该数据集衍生出的负样本挖掘技术被应用于反事实推理的因果效应识别,推动了策略优化与因果推断的交叉融合。这些工作不仅丰富了策略梯度家族的方法论,也为其他领域提供了可迁移的优化范式。
以上内容由遇见数据集搜集并总结生成


