
遇见数据集

subhrokomol/siglip2-large-lora-v1-dataset

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

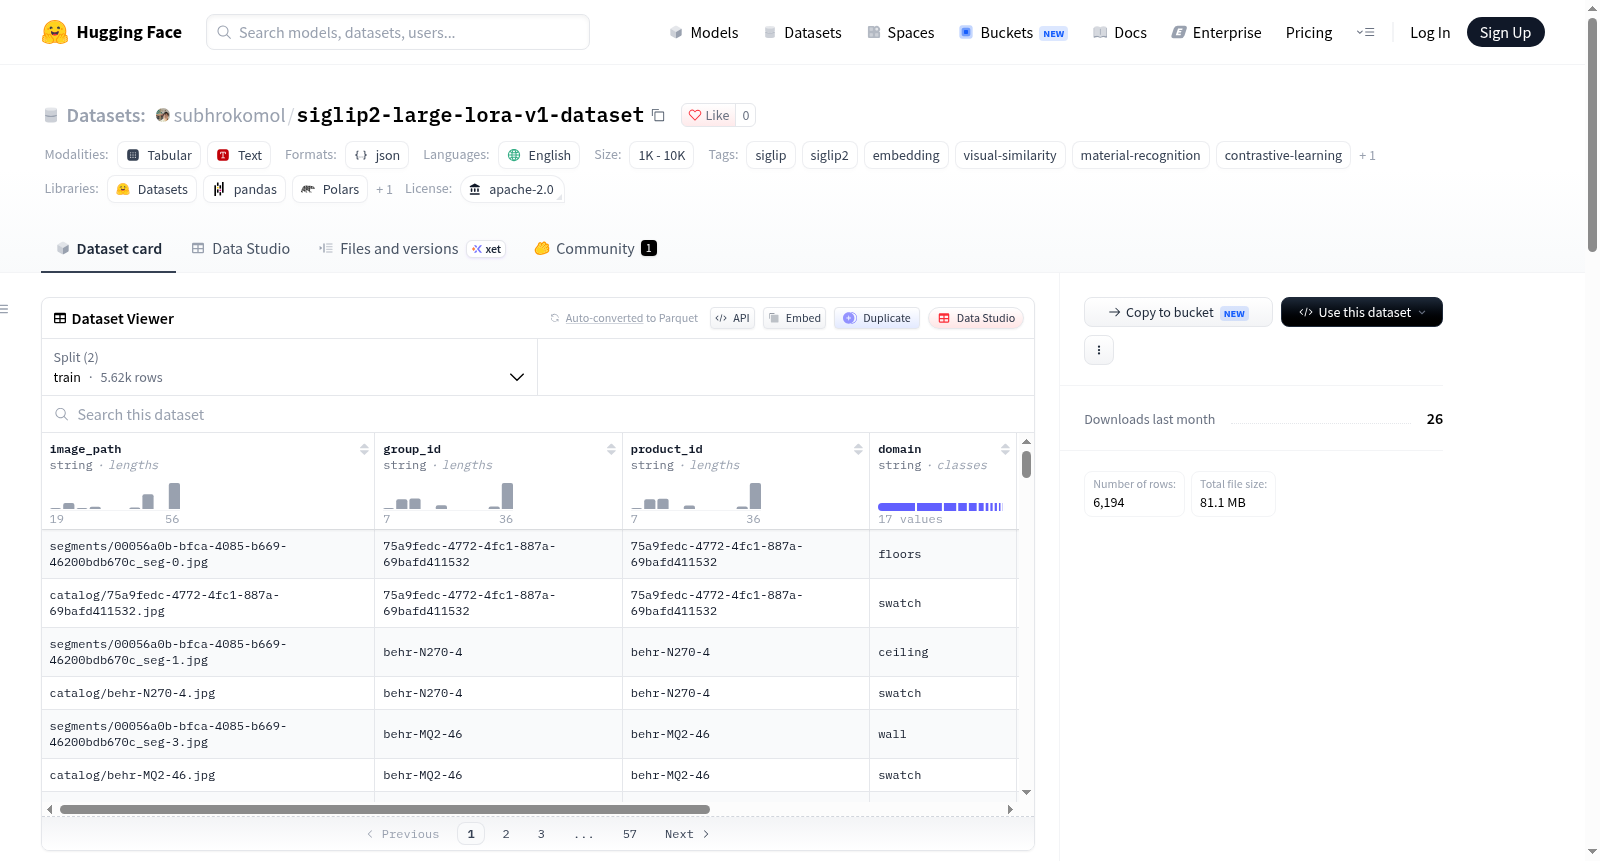
该数据集名为SigLIP2-Large LoRA v1 — Training Pairs,是一个用于微调SigLIP2-large模型的材料表面视觉相似性训练对数据集。它通过LoRA(低秩适应)和监督对比损失进行训练优化。数据集中的每一行数据将一个目录产品图像与从SAM3分割的内部房间渲染中提取的多边形裁剪材料作物相关联。数据生成过程包括:对内部房间渲染进行SAM3分割,使用voyage-multimodal-3.5生成每个片段的多模态嵌入,执行近似最近邻搜索匹配产品图像目录,并保留通过相似性阈值的top-k匹配。数据集包含5,618个训练样本和576个评估样本,文件包括JSONL格式的数据文件和包含图像片段的压缩包。数据集支持视觉相似性任务和材料识别研究,适用于对比学习和监督对比学习场景。

The dataset is named SigLIP2-Large LoRA v1 — Training Pairs, which is a material surface visual similarity training pair dataset for fine-tuning the SigLIP2-large model. It is trained and optimized using LoRA (Low-Rank Adaptation) and supervised contrastive loss. Each row in the dataset associates a catalog product image with polygon-cropped material crops extracted from SAM3-segmented indoor room renders. The data generation workflow includes: conducting SAM3 segmentation on indoor room renders, generating multimodal embeddings for each segment via voyage-multimodal-3.5, performing approximate nearest neighbor search to match catalog product images, and retaining top-k matches that pass the similarity threshold. The dataset contains 5,618 training samples and 576 evaluation samples, with files including JSONL-formatted data files and a compressed package containing image segments. This dataset supports visual similarity task and material recognition research, and is applicable to contrastive learning and supervised contrastive learning scenarios.
提供机构:
subhrokomol
搜集汇总
数据集介绍
subhrokomol/siglip2-large-lora-v1-dataset 数据集图片
构建方式
在视觉-语言对比学习领域,高质量的正负样本对是提升模型细粒度识别能力的关键要素。该数据集的构建以室内场景渲染图为起点,运用SAM3分割模型对房间图像进行多边形裁剪,提取出墙面、地板、沙发等材质区域。随后借助Voyage-AI多模态嵌入模型对每个分割片段生成语义向量,并通过近似最近邻搜索在商品图库中检索匹配项,经相似度阈值过滤后保留高置信度的图像对,最终形成训练集5618行与评估集576行的配对样本。
特点
该数据集呈现出鲜明的多模态协同与领域聚焦特征。图像对以商品目录图与室内材质裁剪区域的关联形式存在,每条记录包含分割置信度、多模态匹配得分、产品标识及材质类别等多维标注信息。数据规模适中,介于一千至一万行之间,覆盖墙面、地板、沙发等多种家居材质类别,且天然以产品标识作为监督对比学习的类别标签,为细粒度视觉相似性建模提供了结构化的正样本对。
使用方法
使用该数据集需先通过HuggingFace数据集接口加载训练与评估划分,同时下载并解压图像归档文件至同级目录下的segments文件夹,以确保JSONL记录中的相对路径能够正确解析。加载后的数据可直接用于SigLIP2-large模型的LoRA微调,配合监督对比损失函数进行训练。每条样本以图像路径、分组标识及域标签为核心字段,便于按类别组织正负样本对,亦可灵活扩展至其他视觉嵌入模型的对比学习任务中。
背景与挑战
背景概述
在视觉-语言表征学习与室内设计智能化交汇的背景下,材料与表面的细粒度视觉相似性建模成为连接商品目录图像与真实空间渲染的关键环节。siglip2-large-lora-v1-dataset由研究者subhrokomol构建并发布于HuggingFace平台,旨在为SigLIP2-large模型提供LoRA微调与监督对比学习所需的训练对。该数据集的核心研究问题在于跨越商品图像与室内场景分割片段之间的域差异,建立稳健的材料语义对齐,其影响力体现于为家居电商、增强现实与智能选材等下游应用提供了可复用的细粒度视觉嵌入训练资源。
当前挑战
该数据集所服务的领域问题——材料与表面的细粒度视觉相似性匹配——面临类间差异细微、光照与视角多变、材质纹理跨域迁移困难等固有挑战。在构建过程中,研究者需依赖SAM3对室内渲染图进行实例分割并保证分割置信度,借助voyage-multimodal-3.5生成多模态嵌入并执行近似最近邻检索以挖掘候选匹配,同时通过相似度阈值筛选与监督对比学习分组来抑制噪声正负对。如何平衡分割误差、嵌入偏差与匹配召回率,并确保商品图与场景片段之间的语义一致性,构成该数据集持续面临的核心难题。
常用场景
经典使用场景
在视觉-语言表征学习领域,该数据集最典型的使用场景在于以监督对比学习范式微调SigLIP2-large模型,通过LoRA低秩适配将产品目录图像与室内渲染图中经SAM3分割并多边形裁剪的材质区域构建为正样本对,从而训练模型精准捕捉材质与表面之间的视觉相似性。
解决学术问题
该数据集有效缓解了跨域视觉相似性学习中细粒度材质匹配标注稀缺的难题,为对比学习提供了具有明确类别标签(group_id)的正负样本对,推动了材质识别与视觉嵌入模型在室内设计场景下的可复现研究,对多模态表征学习的域适应问题具有实证意义。
衍生相关工作
围绕该数据集衍生出的经典工作主要为配套的subhrokomol/siglip2-large-lora-v1模型,其将LoRA微调与监督对比损失相结合,为后续材质识别、视觉相似性检索以及多模态嵌入的轻量化适配研究提供了可借鉴的训练范式与基线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

