
LeMaterial/LeMat-GenBench-embeddings
收藏搜集汇总
数据集介绍
构建方式
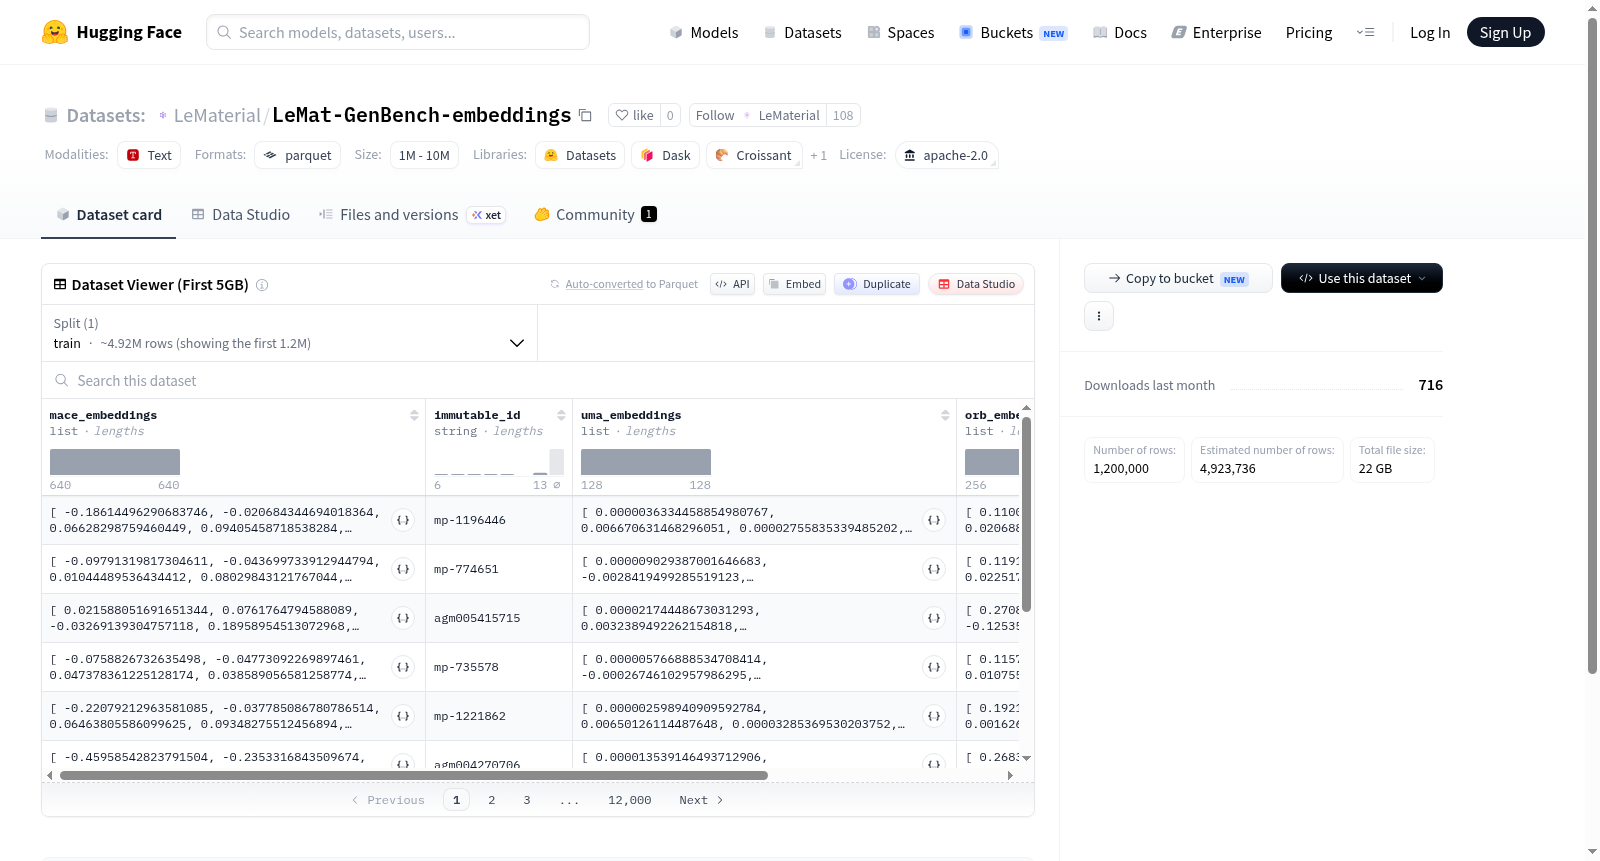
在自然语言处理与材料科学交叉融合的前沿领域,嵌入表征的质量直接决定了模型对复杂材料文本的理解能力。LeMaterial/LeMat-GenBench-embeddings数据集基于大规模材料科学语料库构建,通过预训练语言模型对海量文献、专利及结构化材料描述进行语义编码,生成高维稠密向量表示。其构建过程注重领域知识的嵌入,利用自监督学习范式捕捉材料组成、结构与性能之间的潜在关联,并经过严格的清洗与标准化处理,确保嵌入向量的鲁棒性与可迁移性。
特点
该数据集的核心特征在于其专门面向材料科学领域的通用基准测试设计,提供了涵盖多种材料子领域的标准化嵌入表示。这些嵌入向量具有维度统一、语义对齐良好的特性,能够有效反映不同材料实体间的相似性与差异性。此外,数据集采用Apache-2.0开源协议发布,便于学术研究与工业应用中的自由使用与二次开发,为材料信息学中的下游任务如性能预测、材料检索等提供了可靠的嵌入基础。
使用方法
使用者可通过HuggingFace平台直接加载该数据集,利用`datasets`库中的`load_dataset`函数获取嵌入向量及其对应的元数据。这些嵌入可作为特征输入,结合传统机器学习或深度学习模型进行材料属性预测、聚类分析或相似性搜索等任务。建议在使用前根据具体任务对嵌入进行必要的归一化或降维处理,以适配不同模型的计算需求,并参考配套文档理解每个嵌入向量的语义来源与生成参数。
背景与挑战
背景概述
LeMaterial/LeMat-GenBench-embeddings数据集由LeMaterial团队创建,专注于材料科学领域的生成式模型评估与嵌入表示研究。该数据集旨在为材料属性的生成与预测提供标准化的基准测试平台,其核心研究问题在于如何通过嵌入向量高效捕捉材料的晶体结构、化学组成与物理性质之间的复杂关联。自发布以来,该数据集对材料信息学领域产生了深远影响,推动了生成式模型在新型材料发现中的可重复性与可比性研究,成为连接计算材料科学与机器学习的重要桥梁。
当前挑战
该数据集面临的主要挑战包括:第一,材料科学中数据的高维性与稀疏性使得嵌入表示难以全面覆盖多样化的晶体结构与化学空间;第二,生成式模型在材料属性预测中常遭遇分布外样本泛化能力不足的问题,导致基准测试结果与实际应用存在偏差;第三,构建过程中需处理来自不同实验条件与计算方法的异构数据,统一嵌入格式与标准化流程面临数据噪声与标注不一致的困难,限制了数据集的扩展性与跨领域迁移能力。
常用场景
经典使用场景
LeMaterial/LeMat-GenBench-embeddings 数据集专为材料科学领域的生成式模型评估而设计,其核心用途在于提供高维嵌入表示,用于衡量材料结构生成算法的保真度与多样性。研究者常将其作为基准,对比不同生成模型(如扩散模型、变分自编码器)在晶体结构、分子构型等任务上的表现,从而推动材料逆向设计的标准化进程。
实际应用
在实际应用中,该数据集助力加速新型功能材料的虚拟筛选与优化。例如,在光伏材料或电池电极的研发中,利用其嵌入特征可高效评估生成候选结构的稳定性与电子性质,减少对昂贵第一性原理计算的依赖。此外,其嵌入表示还可用于材料相似性检索,辅助实验科学家快速定位与目标性能匹配的现有材料,从而缩短研发周期。
衍生相关工作
LeMat-GenBench-embeddings 衍生了一系列经典工作,包括基于其嵌入特征训练的生成对抗网络(GAN)用于预测亚稳相材料,以及结合图神经网络(GNN)的嵌入空间插值方法实现晶体结构的连续变形。这些工作不仅拓展了材料生成模型的理论边界,还催生了如“材料嵌入空间导航”等新范式,推动机器学习在材料科学中的交叉创新。
以上内容由遇见数据集搜集并总结生成


