
deqing/addition_dataset_4digits
收藏官方服务:
资源简介:
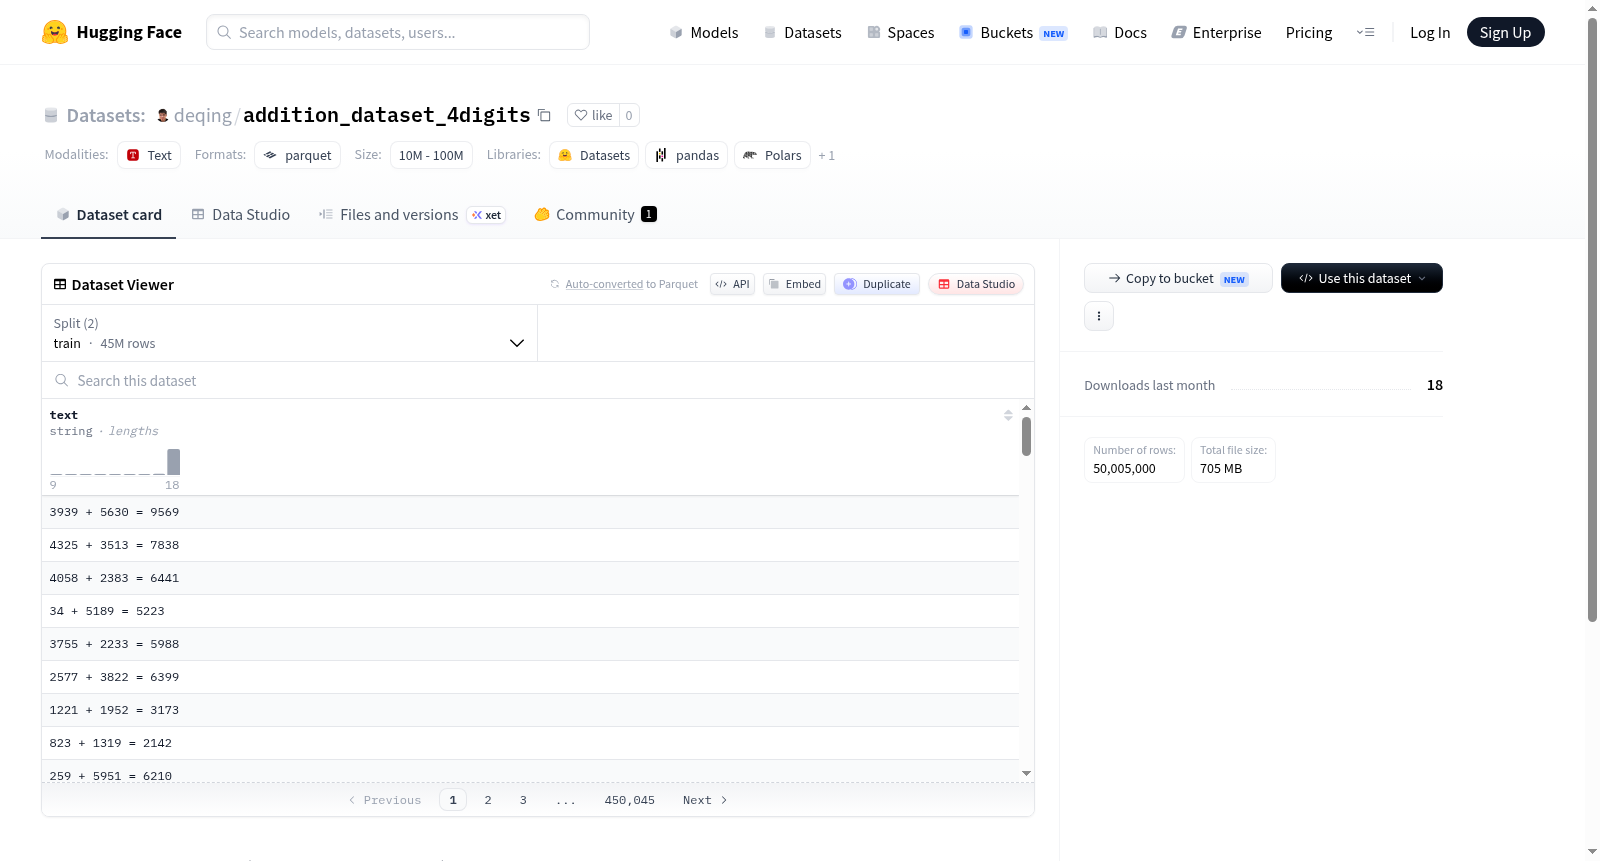
这是一个4位数加法数据集(a + b = c,所有数字均不超过4位数)。通过穷举枚举所有满足条件的(a, b)对生成,其中a和b在[0, 9999]范围内,且a + b <= 9999(因此结果c也不超过4位数)。数据集包含50,005,000个有序对,并进行了交换律安全的90/10训练/测试分割。训练集约45M个示例(在Llama-3分词器下约570M个令牌);测试集约5M个示例。
This is a 4-digit addition dataset (a + b = c, where all numbers are no more than 4 digits). It is generated by exhaustively enumerating all valid (a, b) pairs, where a and b fall within the range [0, 9999] and a + b ≤ 9999 (thus the result c also does not exceed 4 digits). The dataset contains 50,005,000 ordered pairs, with a commutativity-safe 90/10 train/test split. The training set comprises approximately 45 million examples (around 570 million tokens under the Llama-3 tokenizer), while the test set includes about 5 million examples.
提供机构:
deqing搜集汇总
数据集介绍
构建方式
该数据集通过穷举枚举的方式构建,覆盖了所有满足 a、b ∈ [0, 9999] 且 a + b ≤ 9999 的有序整数对 (a, b),确保结果 c 同样为四位数以内。总计包含 50,005,000 个有序样本,充分反映了四位数加法运算的全空间分布。数据集进一步采用交换安全的 90/10 比例划分为训练集与测试集,其中训练集包含约 4500 万条样本,对应约 5.7 亿 Llama-3 分词器下的词元;测试集则约含 500 万条样本,保障了模型评估的统计稳健性。
特点
数据集的核心特色在于其完备性与对称性:所有合法加法组合无一遗漏,使得模型能够学习到四位数加法运算的完整映射关系。交换安全的分割策略确保了 (a, b) 与 (b, a) 不会跨集合分布,避免了数据泄露,从而更准确地衡量模型的泛化能力。此外,数据量庞大且结构规整,每个样本为简单的 a + b = c 格式,有利于作为算术推理任务的基准测试,也可用于探测大型语言模型在基本数学操作上的能力边界。
使用方法
数据集以 Parquet 格式存储,按分片方式组织在 1BT 目录下,可通过 Hugging Face Datasets 库便捷加载。用户可指定 config_name 为 '1BT',并分别选取 train 或 test 分片进行训练或评估。适用于监督学习场景中序列到序列的加法预测任务,例如将字符串 '1234+5678=' 作为输入,并期望模型输出 '6912'。研究者也可将其用于分析模型对数值位置编码、进位逻辑及数字范围的理解程度,或作为预训练与微调阶段的辅助数据源。
背景与挑战
背景概述
在算术推理领域,尤其是针对大规模语言模型(LLMs)的数值计算能力评估中,结构化、可复现的基准数据集至关重要。addition_dataset_4digits数据集由研究机构于近年创建,旨在系统性地探究语言模型在四位数加法任务上的泛化能力。该数据集通过穷举枚举a、b∈[0, 9999]且a+b≤9999的所有有序对,生成总计50,005,000个样本,并采用保持交换律性质的90/10训练/测试划分,确保模型在未见组合上的评估无偏。其设计直接服务于对Transformer架构中算术操作内在表征与计算机制的研究,为评估模型何时能够从示例中学习到精确加法算法提供了标准化测试床,对理解大模型的符号推理瓶颈具有奠基性意义。
当前挑战
该数据集所解决的领域核心挑战在于,尽管语言模型在自然语言任务上表现卓越,但其在低数值精度加法的符号计算上仍频繁出错,暴露出对纯规则性运算的泛化脆弱性。addition_dataset_4digits通过构造一个封闭、完全枚举的四位数加法空间,将问题简化至可验证的精确计算范畴,从而孤立出模型架构与训练策略导致的系统性偏移。构建过程中面临的挑战包括:确保在训练与测试集划分时,任意训练对与测试对之间不存在简单规则关联(如交换顺序),以避免泄露答案模式;同时需平衡数据集的规模(约570M词元)与模型训练的计算效率,以及确保穷举枚举不引入数据重复或数值溢出漏洞,最终形成一个清晰、完备且不存在歧义的基准,用于诊断与改进模型的数值推理能力。
常用场景
经典使用场景
该数据集被广泛应用于探索神经网络在符号推理与算术运算方面的能力边界。研究者在训练语言模型执行整数加法任务时,常将其作为基准测试,用以评估模型对数值关系的理解与泛化性能。特别是,其穷举式构造方式(涵盖所有a、b在0至9999范围内且和不超过9999的有序对)确保了训练与测试分布的一致性,使得研究者能够精确衡量模型在未见数据上的外推表现。这种设计使其成为分析Transformer架构在结构化符号任务中内在局限性的理想平台。
实际应用
在实际应用中,该数据集为开发具有基本数值认知能力的智能体提供了训练基石。基于此数据训练的模型可被嵌入财务审核系统中,用于自动校验发票金额加减和简单的库存统计,降低人工复核成本。在教育培训领域,利用该数据集微调的对话式AI能够模拟小学数字运算辅导过程,实时生成并验证加减法题目,提供个性化学习反馈。此外,该数据集也是构建可解释AI系统中计算验证模块的核心资源,帮助系统在涉及数字操作的环节保证输出逻辑的可靠性。
衍生相关工作
该数据集衍生了一系列探讨算术推理机制的重要工作,包括分析模型在加法任务中是否真正学到进位操作等核心技能的突破性研究。基于该数据集的研究揭示了标准Transformer在精确进位传播上的性能衰减,进而催生了状态空间模型与神经图灵机等改进架构在符号运算中的应用探索。另一部分经典工作则利用该数据集构造了长度泛化实验,验证了相对位置编码和递归循环对提升模型外推能力的显著效果。这些工作共同奠定了现代语言模型在可推理符号计算任务上的理论基础。
以上内容由遇见数据集搜集并总结生成


