
遇见数据集

logo-lab/trl-ctbench

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

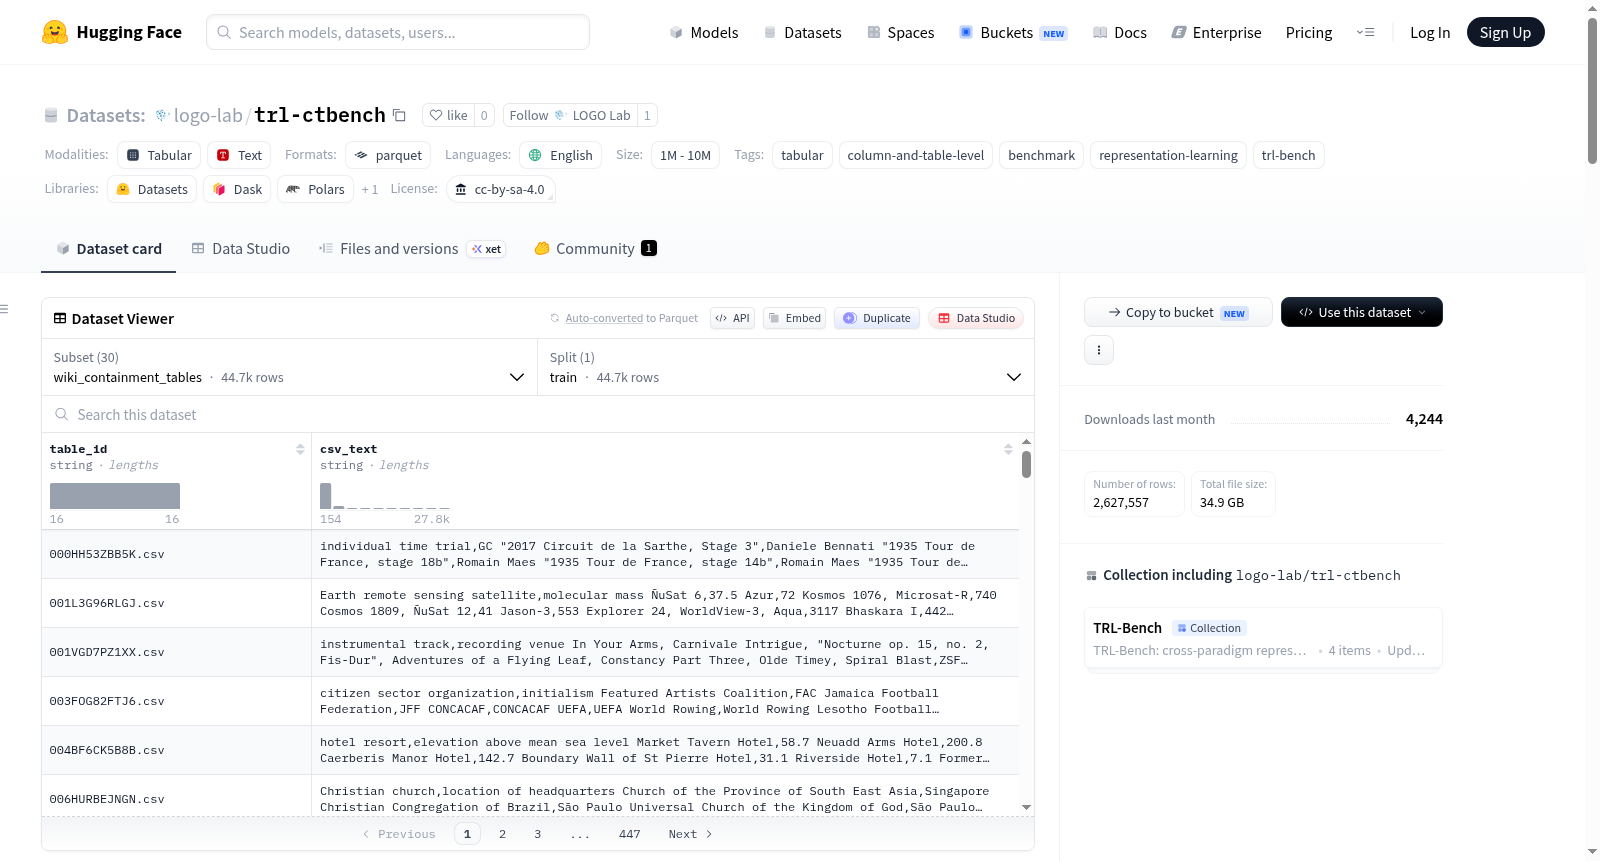
TRL-CTbench是一个用于表格数据表示学习的基准测试套件,包含27个配置,覆盖多种任务如检索式联合搜索、模式匹配、列类型预测、表问答、关系提取等。数据集规模在1M到10M之间,使用CC-BY-SA-4.0许可证。它提供了多个子数据集,如ckan_subset、ecb_union、nq_tables、sato、valentine等,每个配置针对不同的表格数据处理任务,支持训练、验证和测试分割。数据集适用于评估表格数据的表示学习模型,并包含快速使用示例。

TRL-CTbench is a benchmark suite for tabular data representation learning, which includes 27 configurations covering various tasks such as retrieval-based joint search, pattern matching, column type prediction, table question answering, relation extraction and more. The dataset has a scale ranging from 1M to 10M, and is released under the CC-BY-SA-4.0 license. It provides multiple sub-datasets like ckan_subset, ecb_union, nq_tables, sato, valentine and others. Each configuration targets different tabular data processing tasks, and supports training, validation and test splits. This dataset is suitable for evaluating tabular data representation learning models, and also contains quick usage examples.
提供机构:
logo-lab
搜集汇总
数据集介绍
logo-lab/trl-ctbench 数据集图片
构建方式
在表格数据表示学习领域,构建一个覆盖多任务、多来源的标准化基准测试集对于模型评估至关重要。TRL-CTbench数据集正是为此而生,它整合了来自CTbench论文附录中提及的全部27个配置,涵盖列级与表级评估任务。数据集的构建采用多源异构数据融合策略,每个配置对应一个特定任务场景,通过parquet格式存储以保证高效读写,部分配置还针对大规模语料设计了独立的`*_tables`子配置,以规避文件分片限制。
使用方法
使用TRL-CTbench数据集极为便捷,用户可通过`load_dataset`接口直接按名称加载任意配置。对于自包含的小型任务如`valentine`,单次加载即可获得完整数据;而对于包含独立表格语料的任务如`wiki_union`,则需要分别加载标签集与表格集。关系抽取配置中的JSON标注字段需通过`json.loads`解析,而`wtq_mapo`配置因结构异质性,需通过`snapshot_download`下载原始JSON文件。
背景与挑战
背景概述
TRL-CTbench数据集由LOGO Lab研究团队于近期创建,专注于表格数据的列级与表级表示学习评估。该数据集整合了来自CKAN、WikiTableQuestions、SATO、SOTAB、TUS等数十个公开资源,覆盖列类型预测、模式匹配、联合搜索、语义解析等多种任务,总计超过27种配置,规模达数百万样本。作为TRL-Bench套件的核心组成部分,CTbench为表格理解研究提供了标准化、多维度的评估平台,显著推动了弱监督表表示学习领域的发展。其影响力体现在统一了分散的表格基准任务,使研究人员能够更公平地比较不同方法在列级和表级任务上的表现。
当前挑战
表格数据表示学习面临的核心挑战在于其结构异构性与语义复杂性。列级任务要求模型理解列名的隐含语义、数据类型分布及上下文关系,而表级任务则需捕捉跨列关联与表间模式。CTbench构建过程中,整合来自不同来源的表格数据带来了显著的格式不一致问题,包括列名标注差异、数据类型混杂与标签分布不平衡。此外,大规模多配置数据管理面临存储与加载效率的挑战,如部分配置因标签数据量过大需要分片处理。这些挑战共同构成了开发鲁棒、通用表格表示模型的系统性障碍。
常用场景
经典使用场景
TRL-CTbench数据集专为表格数据的列级与表级表示学习而设计,其经典使用场景涵盖列类型预测、模式匹配、关联性检测和表级问答等多个核心任务。研究人员可通过该数据集的标准配置,便捷地评估和训练基于深度学习的表格理解模型。例如,sato和sotab配置用于列类型预测,valentine配置用于跨表模式匹配,而wiki_union和wiki_containment则分别面向表的二元分类和连接列回归任务。这些多样化的任务设定使TRL-CTbench成为表格结构理解与语义表示领域的权威基准,推动了模型从原始表格文本中提取结构化知识的能力发展。
解决学术问题
该数据集系统性地解决了表格数据表示学习中缺乏统一、多任务评估基准的学术难题。在以往的研究中,列类型预测、表连接发现和模式匹配等任务往往使用各自独立的评估集,导致模型性能难以横向比较。TRL-CTbench通过整合20余个源自公开数据源(如CKAN、Wikipedia、SPIDER等)的子集,构建了覆盖列/表级分类、回归、检索和语义解析等多种任务的综合评测平台。其意义在于为学术界提供了一个标准化、可复现的评估生态,使得研究者能够跳出单一任务的局限,全面衡量表格编码器的泛化能力,进而推动更具鲁棒性和迁移性的表格表示学习范式诞生。
实际应用
在实际应用中,TRL-CTbench衍生的模型可被部署于自动化数据集成、知识库构建和智能报表分析等场景。例如,opendata_*系列配置模拟了开放政府数据集之间的连接与联合检索任务,这直接服务于数据湖中的自动模式发现与敏感数据表格的关联分析。此外,面向WikiTableQuestions的wtq配置所支撑的表问答技术,可赋能企业级商业智能系统,让用户通过自然语言查询复杂报表;而sotab和sato训练的列类型预测器,则能辅助数据清洗与元数据自动标注流程,大幅降低人工标注成本。这些应用充分体现了数据集从学术研究到工业落地的桥梁作用。
数据集最近研究
最新研究方向
在表格与列级别表示学习的前沿探索中,TRL-CTbench数据集以其涵盖27个配置的综合性评估体系,正迅速成为表格理解与检索领域的基石性基准。该数据集巧妙整合了来自CKAN、欧洲央行、WikiTables及多个开放数据平台的多源表格语料库,覆盖从列类型预测、模式匹配到联合并查与语义分析等多样化工任务,为评估深度表示学习模型在多层级结构化数据上的泛化能力提供了标准测试台。当前,伴随大语言模型在表格问答(如WikiTableQuestions)与程序合成(融合MAPO策略优化)等热点方向的突破,TRL-CTbench凭借其规模逾百万的富标注样本以及严谨的列级与表级标签设计,有力推动了基于预训练的表格表示方法向真实数据湖场景的应用转化,在开放数据联邦查询与知识图谱构建等实际课题中展现出关键价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

