wop/my-personal-codex-data
收藏资源简介:
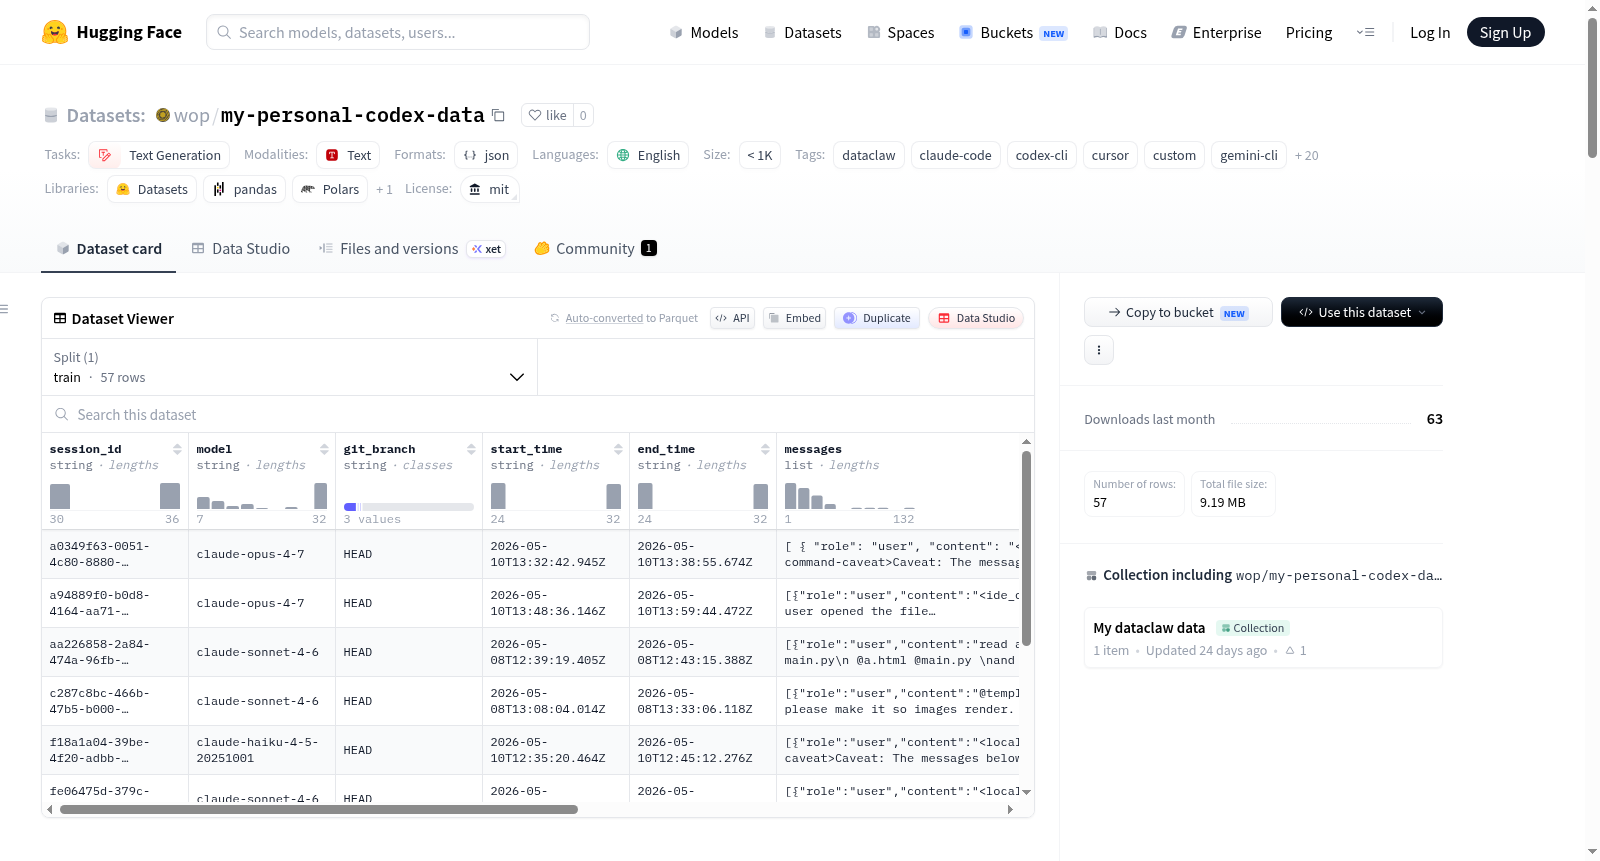
该数据集是一个编码助手对话日志集合,通过DataClaw工具导出,旨在对抗Anthropic的数据政策,促进数据共享。数据集包含57个会话、20个项目,总计约7560万输入令牌和88.1万输出令牌。数据记录了多种AI模型(如deepseek-v4-flash-free、claude-haiku-4-5-20251001、gpt-5-4等)在编码任务中的对话,包括用户请求、助手响应、工具使用(如bash命令)及结构化内容(如图像附件)。每个会话以JSONL格式存储,包含会话ID、项目名称、模型、时间戳、消息列表和统计信息。数据集适用于文本生成、编码助手、工具使用和代理编码等NLP任务。
This dataset is a collection of coding assistant conversation logs exported via the DataClaw tool, intended to counter Anthropic's data policies and promote data sharing. It contains 57 sessions and 20 projects, totaling approximately 75.6 million input tokens and 881,000 output tokens. The dataset records coding task conversations across multiple AI models (e.g., deepseek-v4-flash-free, claude-haiku-4-5-20251001, gpt-5-4, etc.), including user requests, assistant responses, tool usage (such as bash commands), and structured content like image attachments. Each session is stored in JSONL format, containing session ID, project name, model, timestamp, message list, and statistical information. This dataset is applicable to NLP tasks such as text generation, coding assistants, tool usage, and agent-based coding.