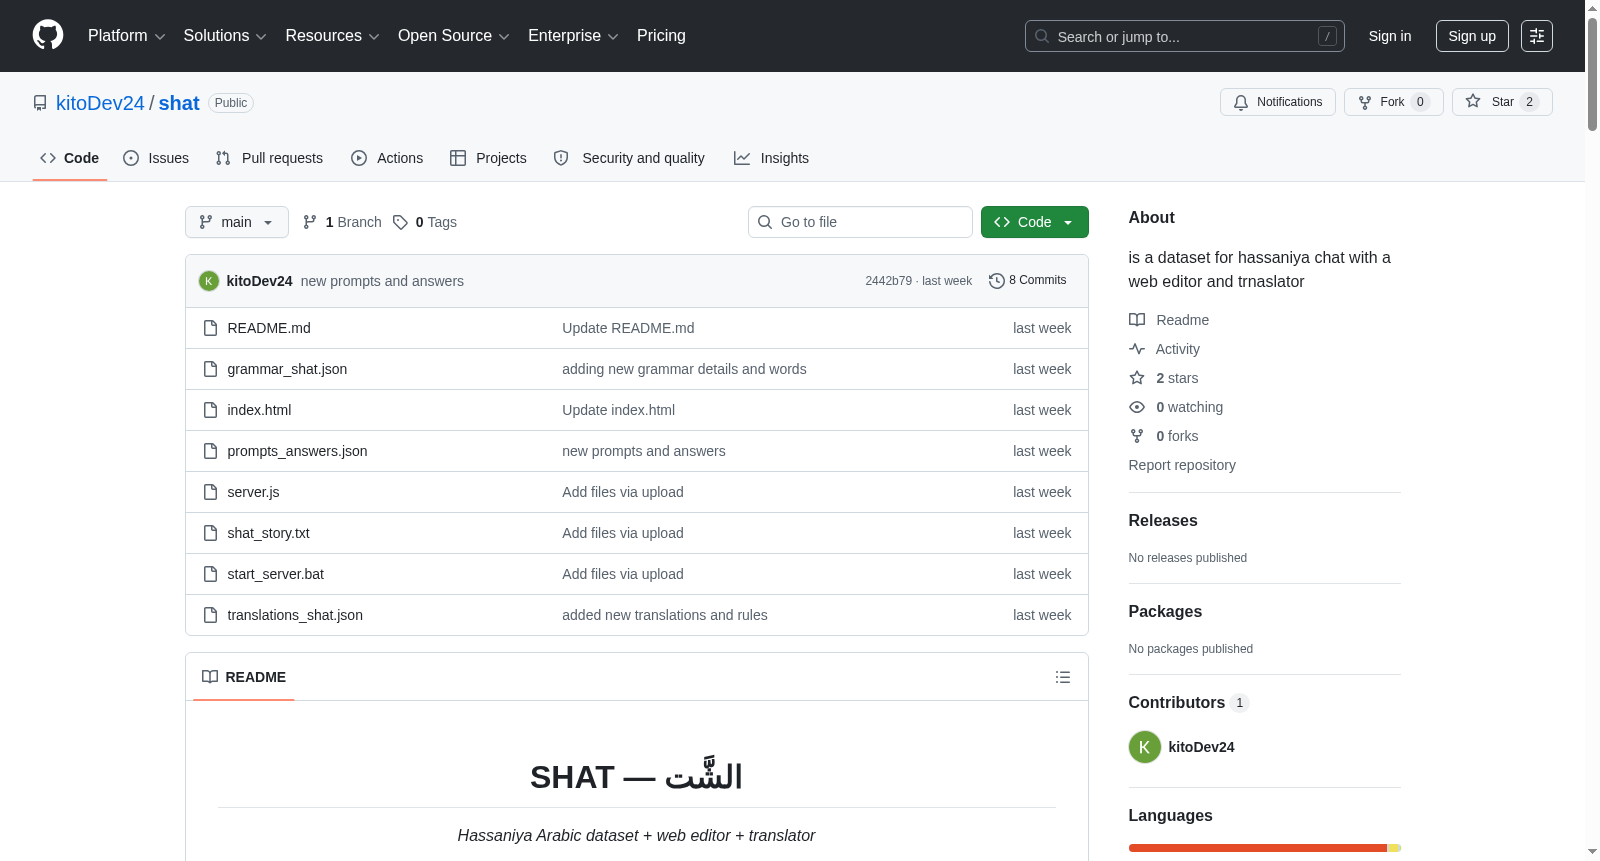
SHAT (الشَّت)
收藏资源简介:
SHAT是一个开源数据集和工具链,专注于哈桑尼亚阿拉伯语(毛里塔尼亚及撒哈拉部分地区使用的方言)。它包括一个不断增长的词典(约700+英语↔哈桑尼亚词条)、基于网络的编辑器、语法感知翻译器以及用于构建哈桑尼亚聊天模型的训练数据。
SHAT is an open-source dataset and toolchain dedicated to Hassaniya Arabic, a dialect used in Mauritania and parts of the Sahara. It includes a growing dictionary with approximately 700+ English↔Hassaniya lexical entries, a web-based editor, a grammar-aware translator, and training data for developing Hassaniya chat models.
数据集概述
SHAT (الشَّت) 是一个面向 哈桑尼亚阿拉伯语(Hassaniya Arabic,毛里塔尼亚及撒哈拉部分地区方言)的开源数据集与工具链。
核心组成
- 词典:包含约 700+ 条英语↔哈桑尼亚语对照词条,涵盖问候、日常生活、情感、食物、旅行、技术、紧急情况等多种类别。
- 翻译器:一个基于语法的翻译工具,支持最长短语优先匹配、形容词-名词词序调整、定冠词规则(太阳字母与太阴字母)、疑问句处理、惯用语替换及缺失词检测。
- 训练数据:包括用于微调聊天模型的提示/答案对,以及用于语言建模的故事语料库。所有数据以纯 JSON 或文本文件存储。
- 网页编辑器:提供完整的增删改查界面,用于管理翻译、提示/答案对及故事语料。
哈桑尼亚语简介
哈桑尼亚语是毛里塔尼亚、西撒哈拉、阿尔及利亚西南部、马里北部、尼日尔西部及塞内加尔北部等地区数百万人使用的阿拉伯方言。它保留了古典阿拉伯语的许多特征,包括完整的辅音词根系统和性/数一致。
| 英语 | 哈桑尼亚语(拉丁转写) |
|---|---|
| Hello | Slm |
| How are you? | Ch7alak / Chmassy |
| Good night | Leyle zeine |
| I dont know | Ane man3rav |
| See you later | Nchovak ba3din |
语法规则要点
翻译器自动应用以下哈桑尼亚语/阿拉伯语语法规则:
| 规则 | 说明 | 示例 |
|---|---|---|
| 1 | 主谓宾语序 (SVO) | Ane nvakar 7oulm = “I think a dream” |
| 2 | 后置形容词 | wete zeine (car beautiful),非 zeine wete |
| 3 | 定冠词:太阳字母 → e- + 双写 |
chems → echems (the sun) |
| 4 | 定冠词:太阴字母 → l- |
9amar → l9amar (the moon) |
| 5 | 过去时 -t 后缀 |
kal → kelt (I ate) |
| 6 | 将来时 ndor- 前缀 |
ndor nmchi (I will go) |
| 7 | 第一人称 n- 前缀 |
n3rav (I know), nged (I can) |
| 8 | 否定式 ma...4i |
man3rav (I dont know) |
| 9 | 破碎复数 | ktab → ktoub (books) |
| 10 | 阴性 -e 后缀 |
mu3alim → mu3alima (teacher f.) |
项目结构
shat/ ├── server.js # Node.js HTTP 服务器 (端口 3000) ├── index.html # 网页编辑器界面 ├── translations_shat.json # 英语↔哈桑尼亚语词典 ├── prompts_answers.json # 训练提示/答案对 ├── shat_story.txt # 故事语料库 ├── README.md # 本文件 └── start_server.bat # Windows 启动脚本
使用方式
- 环境准备:安装 Node.js。
- 启动服务:在项目目录下运行
node server.js。 - 访问界面:在浏览器中打开
http://localhost:3000。 - 主要功能:
- 通过“Add Translation”视图添加英-哈桑尼亚语词条。
- 通过“Translator”视图输入英语文本,实时查看哈桑尼亚语翻译。
- 通过“Edit Translations”等视图编辑或删除词典条目及训练数据。
计划功能
- 词典导出为 CSV / Anki 格式
- 音频发音录制
- 反向翻译(哈桑尼亚语 → 英语)
- 词典中的词性标注
- 动词变位表
- 移动端友好的用户界面
- 机器学习训练管道的导入/导出