Til-Corpus-Additions-v2
收藏资源简介:
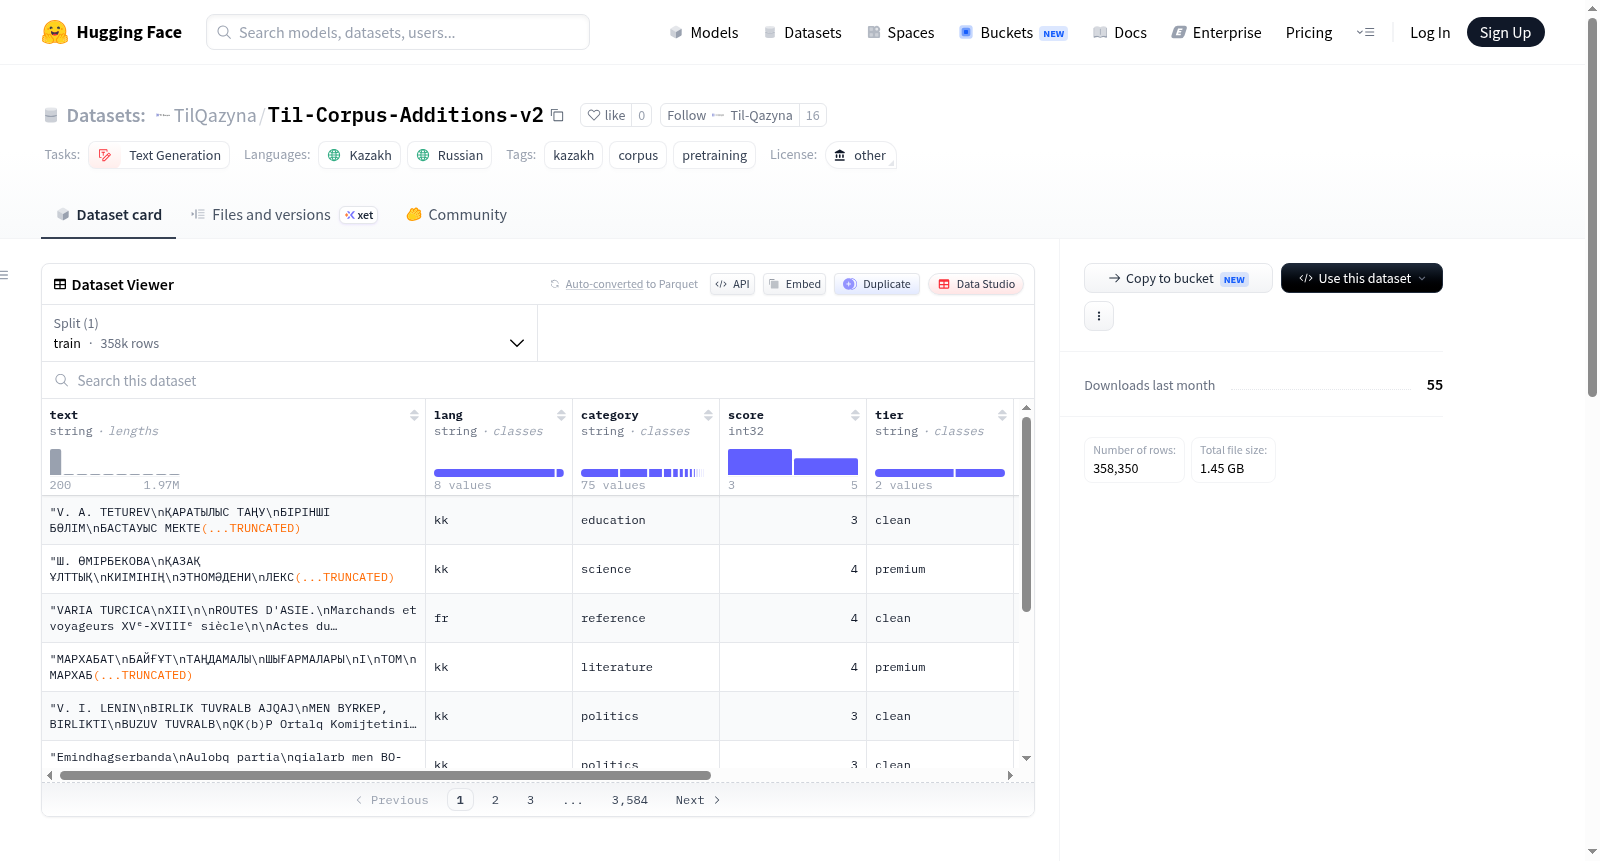
Til-Corpus-Additions-v2 是一个用于哈萨克语 Til-Corpus 的预训练文本补充数据集。它整合了来自 TilQazyna 2026 年新来源的高质量、经过评判的文本,旨在实现“识别/抓取文本同时加入 Til-Corpus”的总体规划。数据来源包括:KazNEB OCR 书籍、zharar 散文、KK 教育网络爬虫以及 600-kitap 有声读物的自动语音识别(ASR)转录文本。数据集仅包含每个来源 `processed/` 分割中评判分数不低于 3 的“优质”和“干净”文本行,并统一为单一模式。每条数据记录包含文本内容及其来源元数据,具体字段包括:文本内容 (`text`)、语言/分数/类别等评判标签 (`lang`/`score`/`category`)、质量层级 (`tier`,分为“premium”和“clean”)、数据来源 (`source`) 以及获取方式 (`route`)。该数据集主要面向哈萨克语的非商业研究用途,计划在去重后合并到未来的 Til-Corpus v2 中,适用于文本生成等预训练任务。
Til-Corpus-Additions-v2 is a supplementary pre-trained text dataset for the Kazakh-language Til-Corpus. It integrates high-quality, annotated texts from new sources of TilQazyna 2026, aiming to fulfill the overall plan of "identifying/scraping texts and incorporating them into Til-Corpus". Data sources include: KazNEB OCR books, zharar prose, KK education web crawler data, and automatic speech recognition (ASR) transcriptions from 600-kitap audiobooks. The dataset only retains "high-quality" and "clean" text lines with an annotation score of no less than 3 in the `processed/` split of each source, and unifies them into a single format. Each data entry contains the text content and its source metadata, with specific fields including: text content (`text`), annotation labels such as language/score/category (`lang`/`score`/`category`), quality tier (`tier`, divided into "premium" and "clean"), data source (`source`), and acquisition method (`route`). This dataset is primarily intended for non-commercial research purposes related to the Kazakh language. It is planned to be merged into the future Til-Corpus v2 after deduplication, and is applicable to pre-training tasks such as text generation.
数据集概述
Til-Corpus-Additions-v2 是一个面向哈萨克语的预训练文本补充数据集,用于扩展原有的 Til-Corpus。该数据集由 TilQazyna 从2026年新增的多个来源中收集高质量文本,经筛选后统一格式。
数据来源
数据集包含以下四种来源经过评判后的高质量文本:
- Til-Books-KazNEB:来自哈萨克斯坦国家电子图书馆的OCR识别书籍。
- Til-Zharar-v2:来自于Zharar文章的文本。
- Til-Web-KK:来自哈萨克语教育网络爬取的内容。
- Til-Audio:来自600-kitap有声书的ASR转录文本。
数据筛选与分类
- 仅保留每个来源中
processed/分片里评判分数≥3的 premium 与 clean 行。 tier字段用于区分质量等级:premium:分数≥4 且语言为哈萨克语的行。clean:其余符合基本质量标准的行。
- 所有行统一为单一的
text文本架构。
字段说明
| 字段 | 含义 |
|---|---|
text |
文档、页面或转录文本内容 |
lang / score / category |
由 Qwen 模型评判的语言、分数和类别标签 |
tier |
质量等级(premium / clean) |
source |
数据来源(Til-Books-KazNEB / Til-Zharar-v2 / Til-Web-KK / Til-Audio) |
route |
数据获取路径(ocr / web / asr) |
使用方式
可通过 Hugging Face Datasets 库加载训练集,示例代码如下:
python from datasets import load_dataset ds = load_dataset("TilQazyna/Til-Corpus-Additions-v2", split="train") premium = ds.filter(lambda r: r["tier"] == "premium")
预期用途
该数据集计划在进行去重处理后,合并到未来的 Til-Corpus v2 中,用于非商业性的哈萨克语研究。
许可与语言
- 许可协议:其他(非商业许可)
- 语言:哈萨克语(kk)、俄语(ru)