
遇见数据集

princeton-nlp/QuRatedPajama-260B

收藏
Hugging Face2024-04-16 更新2024-06-22 收录
官方服务:

资源简介:

QuRatedPajama-260B数据集是cerebras/SlimPajama-627B数据集的一个子集,包含了260B个token,并由princeton-nlp/QuRater-1.3B模型根据四个标准进行了序列级别的质量评分。这四个标准包括:教育价值(如文本是否包含清晰的解释、逐步推理或问答)、事实与琐事(文本中包含多少事实和琐事知识,偏好特定事实和冷门知识而非常见知识)、写作风格(文本的写作风格是否精炼和优秀)和所需专业知识(理解文本所需的专业知识和前提知识的多少)。在预处理步骤中,文档被分割成1024个token的块,并使用Llama-2 tokenizer进行tokenization。文件还强调了负责任使用该数据集的重要性,指出了质量评分中可能存在的偏见,并建议在训练语言模型时进行全面的评估。

QuRatedPajama-260B数据集是cerebras/SlimPajama-627B数据集的一个子集,包含了260B个token,并由princeton-nlp/QuRater-1.3B模型根据四个标准进行了序列级别的质量评分。这四个标准包括:教育价值(如文本是否包含清晰的解释、逐步推理或问答)、事实与琐事(文本中包含多少事实和琐事知识,偏好特定事实和冷门知识而非常见知识)、写作风格(文本的写作风格是否精炼和优秀)和所需专业知识(理解文本所需的专业知识和前提知识的多少)。在预处理步骤中,文档被分割成1024个token的块,并使用Llama-2 tokenizer进行tokenization。文件还强调了负责任使用该数据集的重要性,指出了质量评分中可能存在的偏见,并建议在训练语言模型时进行全面的评估。

提供机构:
princeton-nlp
原始信息汇总

QuRatedPajama-260B

数据集概述

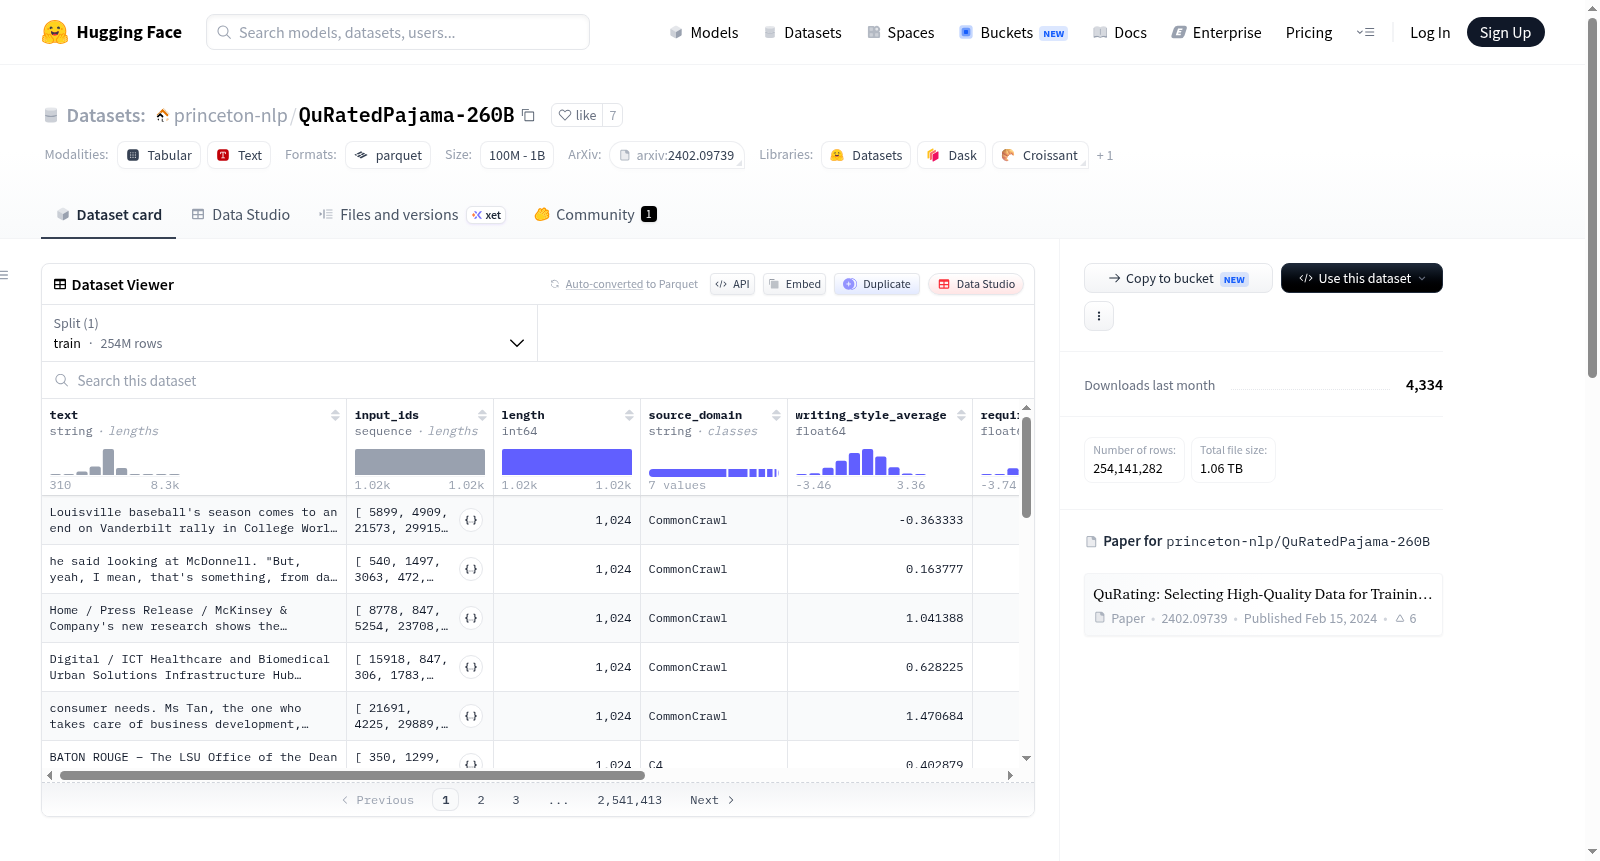
QuRatedPajama是一个260B token的子集,来源于cerebras/SlimPajama-627B,并通过princeton-nlp/QuRater-1.3B进行了序列级质量评分的标注,涵盖以下四个标准:

  • 教育价值 - 例如文本是否包含清晰的解释、逐步推理或问题与答案。
  • 事实与琐事 - 文本包含多少事实和琐事知识,其中特定事实和晦涩的琐事优于更常见的知识。
  • 写作风格 - 文本的写作风格有多精致和优秀。
  • 所需专业知识 - 理解文本所需的专业知识和先验知识有多少。

在预处理步骤中,我们将文档分割成正好1024个token的块,并提供使用Llama-2 tokenizer的tokenization在input_ids列中。

使用指南

在论文中,我们记录了质量评分中存在的各种偏差(与领域、主题、社会角色、地区和语言相关的偏差 - 见论文第6节)。因此,使用QuRating进行数据选择可能会对正在训练的语言模型产生意外和有害的影响。我们强烈建议在实际部署前对语言模型进行这些和其他类型偏差的全面评估。我们希望发布数据/模型能够促进未来旨在发现和缓解此类偏差的研究。请注意,质量评分不衡量文本的社会或文学价值,也不应用于文本或人口统计学研究。

引用

@article{wettig2024qurating, title={QuRating: Selecting High-Quality Data for Training Language Models}, author={Alexander Wettig, Aatmik Gupta, Saumya Malik, Danqi Chen}, journal={arXiv preprint 2402.09739}, year={2024} }
搜集汇总
数据集介绍
princeton-nlp/QuRatedPajama-260B 数据集图片
构建方式
在自然语言处理领域,高质量训练数据的筛选对于提升语言模型性能至关重要。QuRatedPajama-260B数据集从cerebras/SlimPajama-627B语料库中精心抽取2600亿个token,利用princeton-nlp/QuRater-1.3B模型对每个序列进行四项质量维度的标注。预处理阶段,文档被分割为1024个token的等长片段,并采用Llama-2分词器生成input_ids列,确保数据格式的统一性与高效性。
特点
该数据集的核心特色在于其多维度的质量评估体系,涵盖教育价值、事实与冷知识含量、写作风格以及所需专业知识四个标准。教育价值侧重文本的解释性与推理逻辑,事实维度偏好特定与罕见知识,写作风格关注文字的精致度,而所需专业知识则衡量理解文本的预备门槛。这些细粒度评分使得数据选择更加精准,但同时也需警惕其中蕴含的领域、主题及语言偏见,避免对模型训练产生负面影响。
使用方法
研究人员可直接加载该数据集,利用预标注的质量评分进行数据筛选实验,例如根据特定标准的阈值或加权组合构建训练子集。使用时需注意,质量评分不应被视作文本的社会或文学价值度量,且推荐在模型训练后进行全面偏见评估。数据集以HuggingFace格式提供,可通过datasets库便捷调用,配合Llama-2分词器即可无缝接入语言模型训练流程。
背景与挑战
背景概述
在大规模语言模型预训练中,数据质量与数量之间的权衡已成为核心议题。QuRatedPajama-260B数据集由普林斯顿大学Alexander Wettig、Danqi Chen等人于2024年创建,旨在从SlimPajama-627B中筛选高质量子集,以提升语言模型的训练效率与性能。该数据集以教育价值、事实与冷知识、写作风格及所需专业知识四个维度对文本进行序列级质量评分,从而量化数据质量。这一工作不仅为数据筛选提供了新范式,还推动了语言模型预训练中从“以量取胜”向“以质取胜”的转变,对自然语言处理领域具有深远影响。
当前挑战
QuRatedPajama-260B面临的挑战主要体现在两方面。在领域问题层面,如何精确界定并自动评估文本的“教育价值”与“写作风格”等主观性强的质量指标,仍是开放难题,现有评分模型可能引入领域、主题或社会角色相关的偏见。在构建过程中,将文档切割为固定1024令牌的片段可能破坏语义完整性,且依赖Llama-2分词器可能对非英语文本产生偏差。此外,质量评分未衡量文本的社会或文学价值,若直接用于数据筛选,可能导致语言模型学习到有害或刻板印象,需要后续全面评估与缓解偏见的研究。
常用场景
经典使用场景
QuRatedPajama-260B数据集的核心使用场景在于为大规模语言模型的预训练提供高质量数据筛选的基准。该数据集从SlimPajama-627B中精选出2600亿词元,并基于教育价值、事实与常识、写作风格及所需专业知识四个维度进行了序列级质量标注。研究者可借助这些细粒度的质量评分,训练数据选择模型或直接对语料进行优先级排序,从而在有限计算资源下提升语言模型的训练效率与下游性能。这一经典用法为数据驱动的大模型优化提供了标准化评估平台。
解决学术问题
该数据集解决了学术研究中一个关键难题:如何在大规模无标注语料中自动识别并选择高质量训练数据。传统方法依赖启发式规则或人工筛选,难以兼顾规模与深度。QuRatedPajama-260B通过多维质量评分,使研究者能够量化文本的语义丰富度与结构清晰度,从而系统性地研究数据质量对模型泛化能力、知识记忆及写作风格的影响。其意义在于将数据选择从经验性操作提升为可复现的科学范式,推动了数据效率与模型性能之间关联性的理论探索。
衍生相关工作
围绕QuRatedPajama-260B衍生了一系列重要工作。其配套的QuRater-1.3B评分模型本身即是一个经典产出,展示了小型模型如何高效评估大规模语料质量。后续研究借鉴其四维标注框架,开发了针对特定领域(如科学文献或法律文本)的自适应质量评估器。此外,该数据集催生了关于数据选择偏见与公平性的探讨,例如论文中系统性记录的领域与区域偏差分析,为构建更公正的语言模型提供了实证基础。这些工作共同推动了高质量数据驱动的大模型研究生态发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

