
takara-ai/micropajama
收藏官方服务:
资源简介:
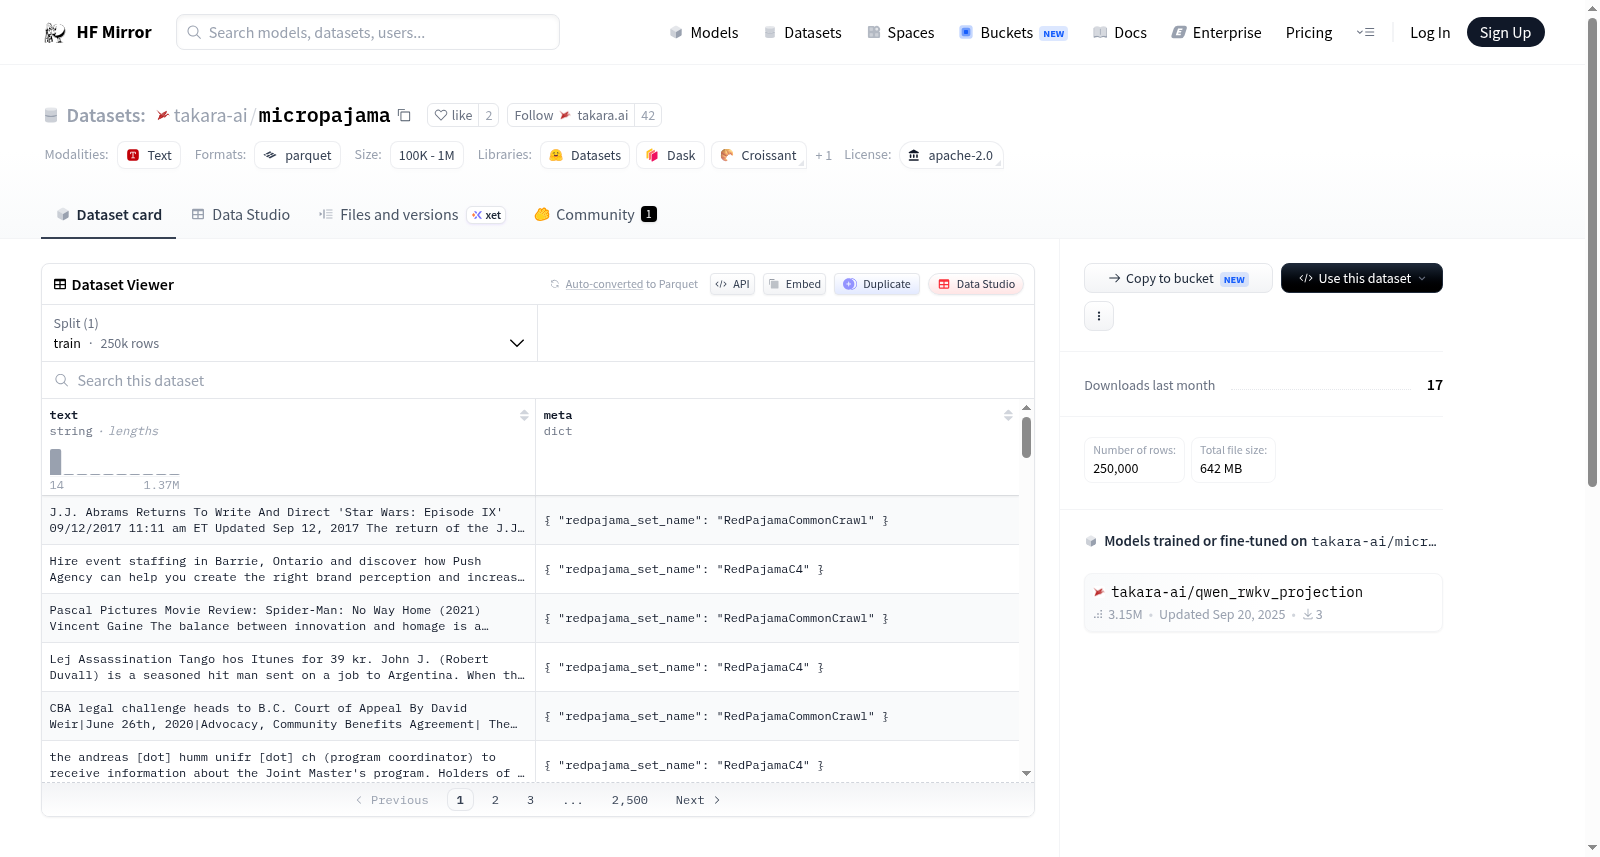
MicroPajama是一个用于蒸馏和特征提取的数据集,不包含维基百科内容,从更大的SlimPajama数据集创建而来。它包含253,636,240个tokens,使用BAAI/bge-large-en-v1.5 wordpiece tokenizer。
MicroPajama is a dataset made for distillation and feature extraction without wikipedia, created from the larger SlimPajama dataset. It contains 253,636,240 tokens using the BAAI/bge-large-en-v1.5 wordpiece tokenizer.
提供机构:
takara-ai搜集汇总
数据集介绍
背景与挑战
背景概述
MicroPajama是SlimPajama的子集,移除了维基百科部分,专为模型蒸馏和特征提取设计。它包含约2.5亿个token,以parquet格式存储,共250,000行,数据来源包括CommonCrawl、C4、StackExchange、Github等,适用于文本研究和模型训练。
以上内容由遇见数据集搜集并总结生成


