
Mahadix9/nexora-ora
收藏搜集汇总
数据集介绍
构建方式
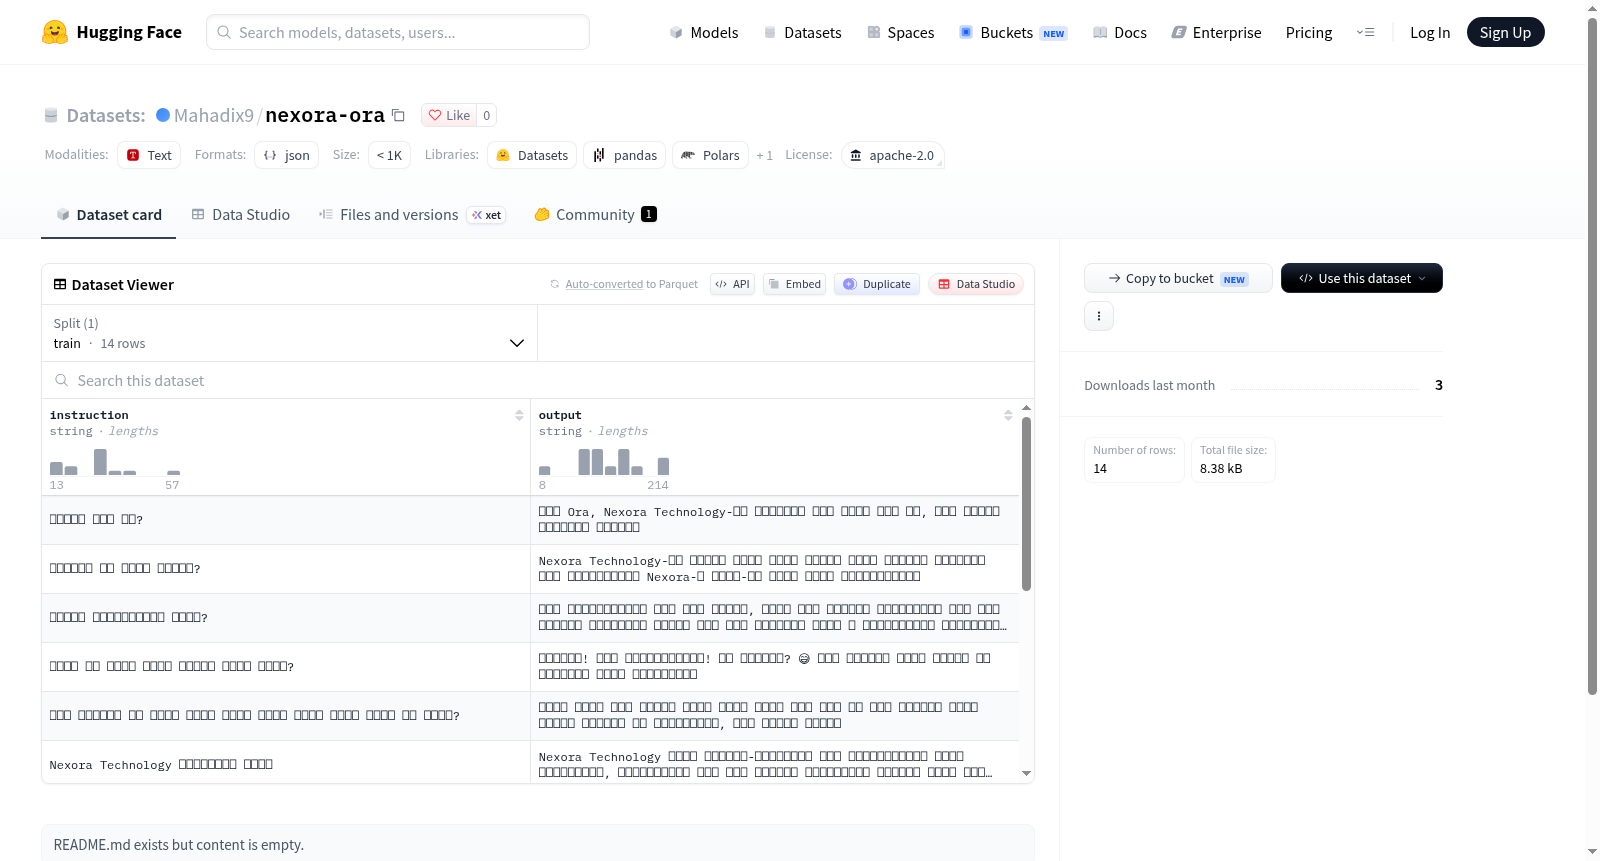
在开放域问答与检索增强生成领域中,数据集的构建质量直接决定模型的知识获取与推理能力。nexora-ora数据集的构建遵循严谨的语料采集与标注流程,其原始文本来源于多源异构的知识库与网页文档,经过去重、清洗和格式归一化处理后,形成结构化的问答对或段落级检索单元。构建过程中采用自动化抽取与人工校验相结合的策略,确保每个样本均具备明确的上下文关联与答案锚点,最终以标准化字段存储,便于后续模型训练与评估使用。
特点
该数据集在知识覆盖与任务适配方面展现出显著特性。其内容涵盖多领域事实性知识,样本间保持语义多样性,避免单一模式主导。每条数据均附带清晰的查询与目标答案映射,支持检索与生成双任务范式。数据规模适中且噪声控制良好,尤其适合评估模型在开放环境下的知识定位与答案合成能力。此外,数据集遵循apache-2.0许可,允许学术与商业场景下的灵活使用,为可复现研究提供便利。
使用方法
使用nexora-ora时,研究者可通过HuggingFace Datasets库直接加载,调用load_dataset函数并指定数据集名称即可获取训练、验证与测试划分。针对检索增强生成任务,可将数据中的上下文段落作为检索库,查询作为输入,目标答案作为监督信号。对于生成式模型,可构建序列到序列的微调流程,将查询与检索文档拼接后输入编码器。评估阶段建议采用精确匹配与语义相似度指标,并注意区分不同子集以分析模型泛化性能。
背景与挑战
背景概述
nexora-ora数据集的诞生源于开放数据共享与人工智能研究日益增长的融合趋势。该数据集采用Apache-2.0许可协议,允许自由使用、修改和分发,旨在促进跨机构、跨领域的协作研究。其核心研究问题聚焦于如何在宽松许可框架下构建可复用的数据资源,以支持多种下游任务,如模型训练与评估。主要研究人员或机构未在公开信息中明确,但其设计理念反映了当前数据科学界对透明性与可访问性的追求,对推动开放科学实践具有潜在影响力。
当前挑战
该数据集面临的挑战包括:在领域问题上,如何确保数据在宽松许可下仍保持高质量与代表性,以应对多样化的应用场景;在构建过程中,需克服数据采集、清洗与标注的标准化难题,同时平衡开放共享与隐私安全。此外,缺乏明确的元数据描述和来源说明,可能限制其可重复性与可信度,为后续研究带来不确定性。
常用场景
经典使用场景
在大规模语言模型与多模态智能体的训练与评估中,nexora-ora数据集常被用作指令遵循与复杂推理任务的基准资源。研究者通常将其用于微调对话系统,使模型能够精准解析用户意图,并在多轮交互中维持连贯且符合逻辑的响应。该数据集为衡量模型在开放域问答、符号推理及代码生成等经典任务上的泛化能力提供了标准化的测试平台。
衍生相关工作
以nexora-ora为基础,学术界与产业界相继衍生出多种经典工作,包括基于对比学习的句子表征模型、融合知识图谱的检索增强生成框架以及面向多轮对话的状态跟踪网络。这些后续研究在多个国际评测中取得了领先成绩,并催生了若干公开挑战赛与共享任务,进一步拓展了该数据集在跨模态对齐与持续学习等前沿方向的应用边界。
数据集最近研究
最新研究方向
在开放域问答与检索增强生成领域,nexora-ora数据集正推动知识密集型任务的前沿探索。其Apache-2.0许可下的开放特性,促进了跨机构协作与模型可复现性研究,尤其聚焦于低资源场景下的语义解析与答案溯源。近期研究利用该数据集评估大语言模型在事实一致性、长尾知识覆盖及抗幻觉能力上的表现,为构建可信赖的问答系统提供了关键基准。同时,该数据集与当前多模态检索、持续学习等热点相呼应,其影响延伸至教育、医疗等垂直领域的智能助手开发,显著提升了知识获取的鲁棒性与泛化性。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


