
MIA-near-public
收藏官方服务:
资源简介:
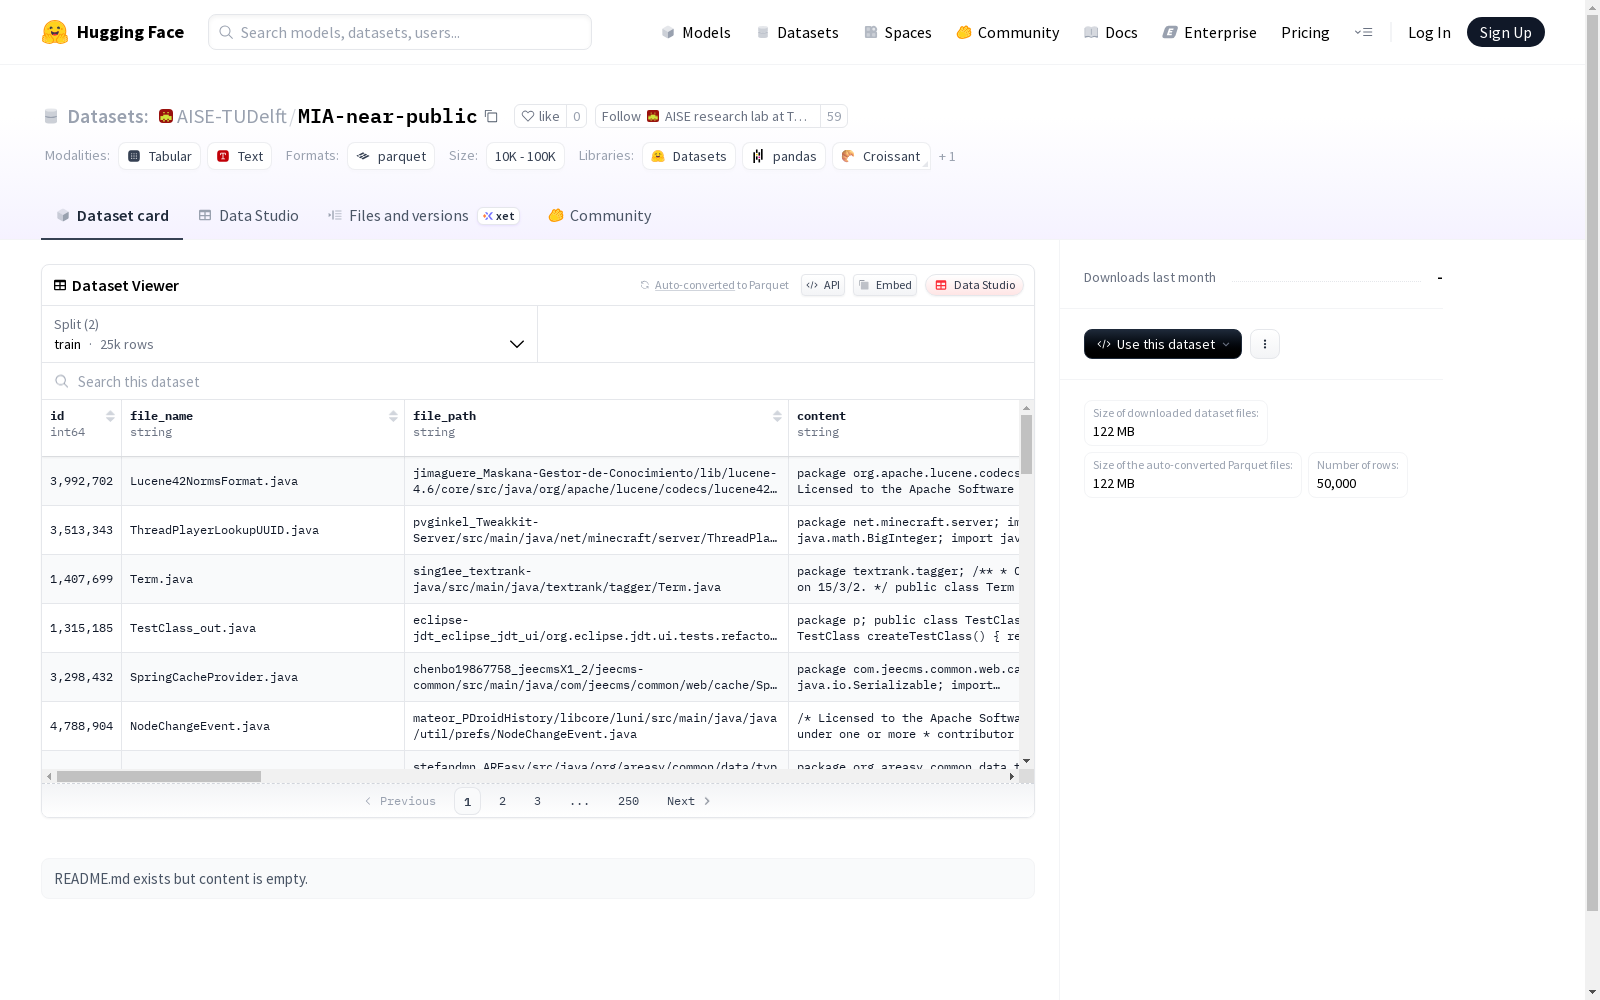
该数据集是一个包含文件属性和代码仓库信息的集合,具体包括文件名、路径、内容、大小、语言、扩展名、行数、平均行长度、最大行长度、字母数字比例等信息,以及代码仓库的名称、星星数、分支数、打开的问题数、许可证类型和提取日期。同时,数据集还标注了文件的重复性信息。
This dataset is a collection comprising file attributes and code repository information. Specifically, it includes filename, file path, file content, file size, programming language, file extension, line count, average line length, maximum line length, alphanumeric ratio, and other relevant metrics. For code repositories, the dataset contains repository name, star count, branch count, number of open issues, license type, and extraction date. Additionally, the dataset annotates the duplicate information of the files.
创建时间:
2025-11-04
原始信息汇总
MIA-near-public 数据集概述
数据集基本信息
- 数据集名称:MIA-near-public
- 存储位置:https://huggingface.co/datasets/AISE-TUDelft/MIA-near-public
- 总下载大小:122,349,323 字节
- 数据集总大小:373,252,854 字节
数据规模与划分
- 训练集:25,000 个样本,186,626,427 字节
- 测试集:25,000 个样本,186,626,427 字节
- 总样本数:50,000 个样本
数据特征结构
文件标识信息
- 文件ID(id)
- 文件名(file_name)
- 文件路径(file_path)
- 内容(content)
- 文件大小(size)
代码特征
- 编程语言(language)
- 文件扩展名(extension)
- 总行数(total_lines)
- 平均行长度(avg_line_length)
- 最大行长度(max_line_length)
- 字母数字比例(alphanum_fraction)
仓库元数据
- 仓库名称(repo_name)
- 仓库星标数(repo_stars)
- 仓库分支数(repo_forks)
- 仓库开放问题数(repo_open_issues)
- 仓库许可证(repo_license)
- 仓库提取日期(repo_extraction_date)
重复检测标识
- RedPajama精确重复(exact_duplicates_redpajama)
- RedPajama近似重复(near_duplicates_redpajama)
- GitHub代码精确重复(exact_duplicates_githubcode)
- StackV2精确重复(exact_duplicates_stackv2)
- StackV1精确重复(exact_duplicates_stackv1)
- GitHub代码近似重复(near_duplicates_githubcode)
- StackV1近似重复(near_duplicates_stackv1)
- StackV2近似重复(near_duplicates_stackv2)
- 长度(length)
数据文件配置
- 配置名称:default
- 训练集路径:data/train-*
- 测试集路径:data/test-*
搜集汇总
数据集介绍
构建方式
在代码数据挖掘领域,MIA-near-public数据集通过系统化采集GitHub开源项目构建而成。该数据集从海量代码仓库中提取了5万个样本文件,每个样本均包含完整的代码内容与丰富的元数据信息。构建过程中特别注重代码质量,通过文件扩展名识别编程语言类型,并采用多维度重复检测机制,分别与RedPajama、GitHubCode以及Stack系列数据集进行精确和近似重复比对,确保数据集的独特性和多样性。
特点
该数据集最显著的特点是具备全面的代码质量评估维度。每个样本不仅包含基础的文件大小、行数统计信息,还提供了代码复杂度指标如平均行长度和字母数字比例。数据集覆盖多种编程语言,并通过仓库星级、分支数等指标反映项目流行度。独特的重复检测标记体系使得研究者能够精准识别代码片段的来源关系,为代码克隆检测和知识产权研究提供了重要依据。
使用方法
针对代码智能研究需求,该数据集支持直接加载与分片处理。用户可通过标准数据加载接口获取训练集和测试集,每个集合均包含25000个样本。数据集提供完整的特征字段访问,支持基于编程语言、仓库特征或重复标记的数据筛选。研究者可利用该数据集进行代码生成、代码克隆检测、代码质量评估等任务,丰富的元数据为多维度分析提供了便利条件。
背景与挑战
背景概述
随着人工智能技术在代码智能分析领域的深入应用,MIA-near-public数据集应运而生,聚焦于源代码质量评估与去重机制的研究。该数据集由专业研究团队构建,整合了多源代码仓库的元数据与内容特征,旨在解决大规模代码库中存在的冗余与质量问题。通过精确标注代码文件在不同基准数据集中的重复状态,该资源为代码克隆检测、知识图谱构建及软件工程优化提供了关键数据支撑,显著推动了智能编程辅助工具的发展进程。
当前挑战
在代码质量分析领域,核心挑战在于如何精准识别跨代码库的语义相似性,同时克服不同编程语言范式带来的结构差异。数据集构建过程中面临多重技术难题:需设计高效的近重复检测算法以处理海量代码片段,建立统一的质量评估指标来平衡代码复杂度与可读性,并解决多源数据集成时出现的格式不一致与元数据缺失问题。这些挑战直接关系到代码去重系统的准确性与泛化能力。
常用场景
经典使用场景
在代码数据质量评估领域,MIA-near-public数据集通过标注精确与近似重复样本,为大规模代码库去重研究提供了标准基准。研究者可借助其多维特征字段,系统分析代码重复模式对模型训练的影响,尤其在预训练数据清洗环节具有关键价值。该数据集支持跨项目代码相似性检测,为构建高质量训练语料奠定了方法论基础。
实际应用
在工业界实践中,该数据集被广泛应用于智能编程助手的训练数据优化。科技企业可依据其标注的重复模式,构建高效的数据过滤管道,提升代码生成模型的输出质量。同时,该数据集为开源代码库维护者提供了重复代码检测工具的开发基准,助力实现更可持续的软件生态系统。
衍生相关工作
基于该数据集衍生的经典工作包括代码去重算法比较研究,如基于最小哈希的近似检测技术优化。多项研究利用其构建的基准测试集,系统评估了不同去重策略对模型性能的影响。这些工作共同推动了《BigCode》等开源计划的数据治理标准建立,为后续代码大模型训练提供了重要参考框架。
以上内容由遇见数据集搜集并总结生成


