
遇见数据集

JonAuror/tplegacy-teachings

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

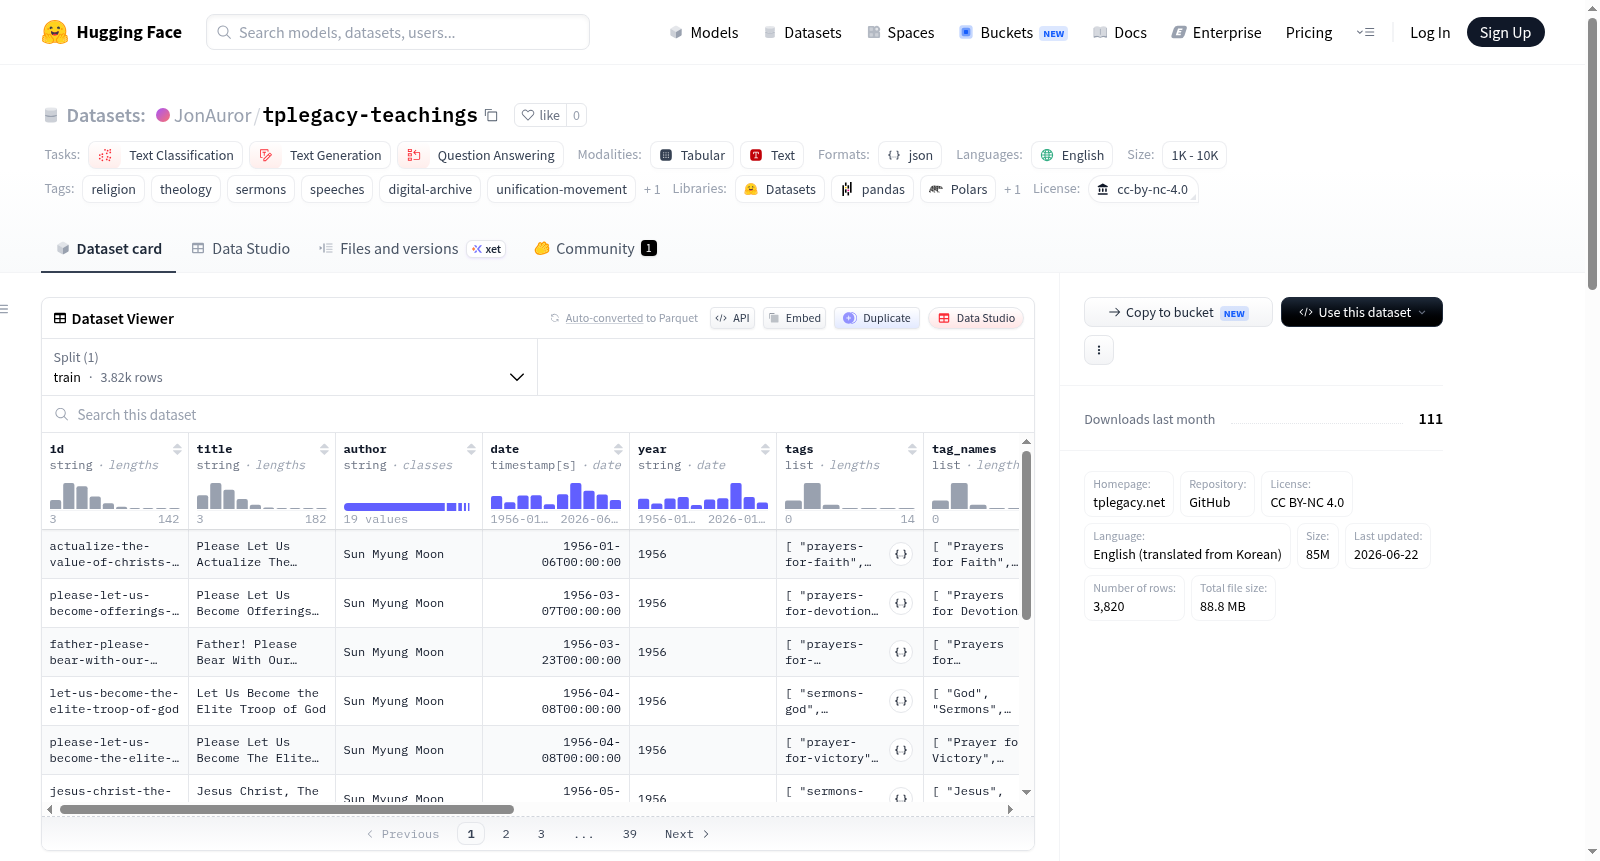
True Parents Legacy Teaching Archive(真父母遗产教学档案)是一个数字档案数据集,包含3750段文段,涵盖了文鲜明(1920-2012)和韩鹤子(1943-至今)的布道、演讲、祈祷和书籍摘录,时间跨度为1946年至2012年。数据集以英文呈现,是从韩语翻译而来的。每个记录包括ID、标题、作者、日期、年份、标签、摘录、全文、字数、阅读时间、URL和ARK标识符等字段。数据集大小为83M,许可证为CC BY-NC 4.0,最后更新于2026年5月29日。

True Parents Legacy Teaching Archive is a digital archival dataset containing 3,750 text segments, covering sermons, speeches, prayers and book excerpts by Sun Myung Moon (1920–2012) and Hak Ja Han (1943–present), spanning the period from 1946 to 2012. The dataset is presented in English and translated from Korean. Each record includes fields such as ID, title, author, date, year, tags, excerpt, full text, word count, reading time, URL and ARK identifier. The dataset has a size of 83M, is licensed under CC BY-NC 4.0, and was last updated on May 29, 2026.

提供机构:
JonAuror
搜集汇总
数据集介绍
JonAuror/tplegacy-teachings 数据集图片
构建方式
该数据集源自True Parents Legacy项目,旨在系统化保存文鲜明夫妇跨越1946年至2012年的宗教与哲思遗产。构建过程依托于tplegacy.net数字档案库,从原始韩语讲道、演讲、祷文及书籍节选中精心遴选并翻译为英语,最终形成包含3820段文本的语料库。每条记录均涵盖唯一标识符、标题、作者、精确日期、内容标签、完整正文、字数及阅读时长等结构化字段,并附有ARK持久标识符以确保长期可引用性。
特点
数据集以时间纵深广、内容类型多元著称,横跨近七十年历史,容纳了讲道、演讲、祈祷文与著作摘录等多种体裁。其独特之处在于采用Linked Open Data框架发布RDF版本,支持知识图谱层面的语义关联与查询。所有文本均经过人工翻译与元数据标注,标签系统采用双轨制(内部标识与显示名称),兼顾机器处理与人类阅读需求,为宗教研究与数字人文提供了高度结构化的语料基础。
使用方法
使用者可通过Hugging Face Datasets库便捷加载,单行代码即可获取训练集并访问标题等字段。数据既可直接用于文本分类、文本生成与问答等自然语言处理任务,也适合构建主题建模或情感分析模型。对于知识图谱研究,建议结合GitHub上配套的tplegacy-lod RDF数据集,利用SPARQL进行跨文档语义检索。引用时需标注CC BY-NC 4.0许可协议,并引用数据集官方文献。
背景与挑战
背景概述
在宗教文本数字化与自然语言处理交叉领域,结构化宗教语料库的构建对于理解教义演变、领袖话语模式及信仰传播机制具有重要学术价值。该数据集由True Parents Legacy项目团队于2025年创建,收录了文鲜明(1920-2012)与韩鹤子(1943-今)夫妇自1946年至2012年间共3820篇讲道、演讲、祈祷文及书籍摘录的英文译本。作为统一运动创始人的核心教义档案,该数据集首次以机器可读的链接开放数据(LOD)形式呈现,每个条目配备永久URL与ARK持久标识符,为宗教研究、话语分析及知识图谱构建提供了规模化的文本基础。数据集在HuggingFace平台发布后,因其对非主流宗教思想档案的系统化整理而受到宗教学与计算语言学领域的关注,成为研究20世纪新兴宗教运动话语演变的珍贵数字遗产。
当前挑战
该数据集面临的核心挑战在于宗教文本本身的语义复杂性与跨文化解释困境。从领域问题看,统一运动教义融合了基督教、东方哲学及末世论思想,其隐喻体系与辩证话语结构(如‘真父母’概念的神学定位)对传统文本分类与情感分析模型构成显著挑战,需设计特定于宗教话语的细粒度标注体系以捕捉教义内在逻辑。在构建过程中,最大的难题来自语料的源语言转化:原始韩文讲道经过翻译再编目,部分术语(如‘荡减’等独特神学词汇)的语义等价性难以通过常规双语对齐验证;同时,跨越66年的手稿存在大量日期缺失、版本异文及匿名转写稿,数据集的元数据一致性通过ARK标识符与LOD框架得以保障,但时空上下文关联的自动补全仍需依赖专家知识库的校对。
常用场景
经典使用场景
在宗教研究与神学分析领域,tplegacy-teachings 数据集最为经典的使用场景是作为文本分类与问答系统的训练语料。该数据集收录了文鲜明与韩鹤子跨越六十余载的3820篇讲道、演讲、祈祷文及著作摘录,内容涵盖统一运动的核心教义、历史事件与神学阐释。研究者可基于其丰富的标签体系与结构化字段,构建面向宗教文本的自动分类模型或知识检索系统,例如根据内容标签对讲道主题进行细粒度分类,或利用全文信息实现教义问答推理。这一场景为数字人文领域提供了兼具深度与广度的宗教文献资源。
实际应用
在实际应用层面,该数据集为宗教教育平台、数字档案馆及知识图谱构建提供了坚实的底层支撑。例如,教育机构可基于其内容开发面向信徒或研究者的智能问答系统,自动回答关于教义、历史人物或特定讲道的查询;数字人文项目可借助数据集的ARK持久标识符与链接数据版本,将其融入跨档案的知识互联网络中。此外,数据集中的阅读时长与字数统计字段,便于开发者构建个性化推荐引擎,根据用户偏好推荐相关讲道内容,从而提升宗教文献的传播效率与学习体验。
衍生相关工作
tplegacy-teachings 数据集催生了多项具有影响力的衍生工作。最直接的相关成果包括基于其链接数据版本(tplegacy-lod)构建的统一运动知识图谱,该图谱将讲道内容与人物、地点、事件等实体进行语义关联,支持SPARQL查询语言进行复杂信息检索。此外,已有研究者利用该数据集训练宗教领域专用的语言模型,以改善生成式人工智能对神学文本的连贯性与准确性。这些衍生工作不仅扩展了原始数据集的应用边界,也为其他宗教或文化档案的数字化转化提供了可复现的方法论框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

