SpeechFCEval
收藏资源简介:
SpeechFCEval是一个基于语音的功能调用基准数据集,包含来自现有开源文本数据集和构建的智能交互场景的数据。它涵盖英语和中文,支持单功能和并行功能调用。数据集包含多个子集,每个子集有不同的语言、音频类型(TTS或人声)、功能模式(单功能或并行功能)、大小、来源和类别。数据格式包括用户语音转录、对应的WAV音频文件名、功能调用候选列表(JSON格式)、时间信息(仅限ACEBench子集)、真实答案(JSON格式)、子集类别、唯一标识符和索引。数据集还提供了评估脚本和相关的引用文献。
SpeechFCEval is a speech-based function calling benchmark dataset. It comprises data sourced from existing open-source text datasets and constructed intelligent interaction scenarios, covering both English and Chinese, and supports both single-function and parallel function calling. The dataset contains multiple subsets, each characterized by distinct attributes including language, audio type (either TTS or human voice), function mode (single-function or parallel function), dataset scale, data source, and category. The data format includes user speech transcription, corresponding WAV audio filename, function calling candidate list (in JSON format), time information (only available for the ACEBench subset), ground truth answers (in JSON format), subset category, unique identifier, and index. Additionally, the dataset provides evaluation scripts and relevant cited references.
SpeechFCEval 数据集概述
数据集简介
SpeechFCEval 是一个基于语音的函数调用基准测试数据集集合。它构建自现有的开源文本数据集以及构建的智能交互场景,涵盖英语和中文,包含单函数和并行函数调用案例。
数据集子集详情
| 子集名称 | 语言 | 音频类型 | 函数调用模式 | 数据量 | 数据来源 | 类别 |
|---|---|---|---|---|---|---|
| SpeechFC-BFCL-Single | 英语 | TTS | 单函数 | 578 | BFCL | simple_python, multiple |
| SpeechFC-BFCL-Parallel | 英语 | TTS | 并行函数 | 372 | BFCL | parallel, parallel_multiple |
| SpeechFC_SmartInteract | 中文 | TTS | 单函数 | 668 | 智能交互场景 | smart_interact (54 tools) |
| SpeechFC_ACEBench_Single | 中文 | 人声 | 单函数 | 208 | ACEBench | normal_single_turn_single_function, normal_atom, normal_similar_api |
| SpeechFC_ACEBench_Parallel | 中文 | 人声 | 并行函数 | 88 | ACEBench | normal_single_turn_parallel_function |
数据格式
每个数据样本包含以下字段:
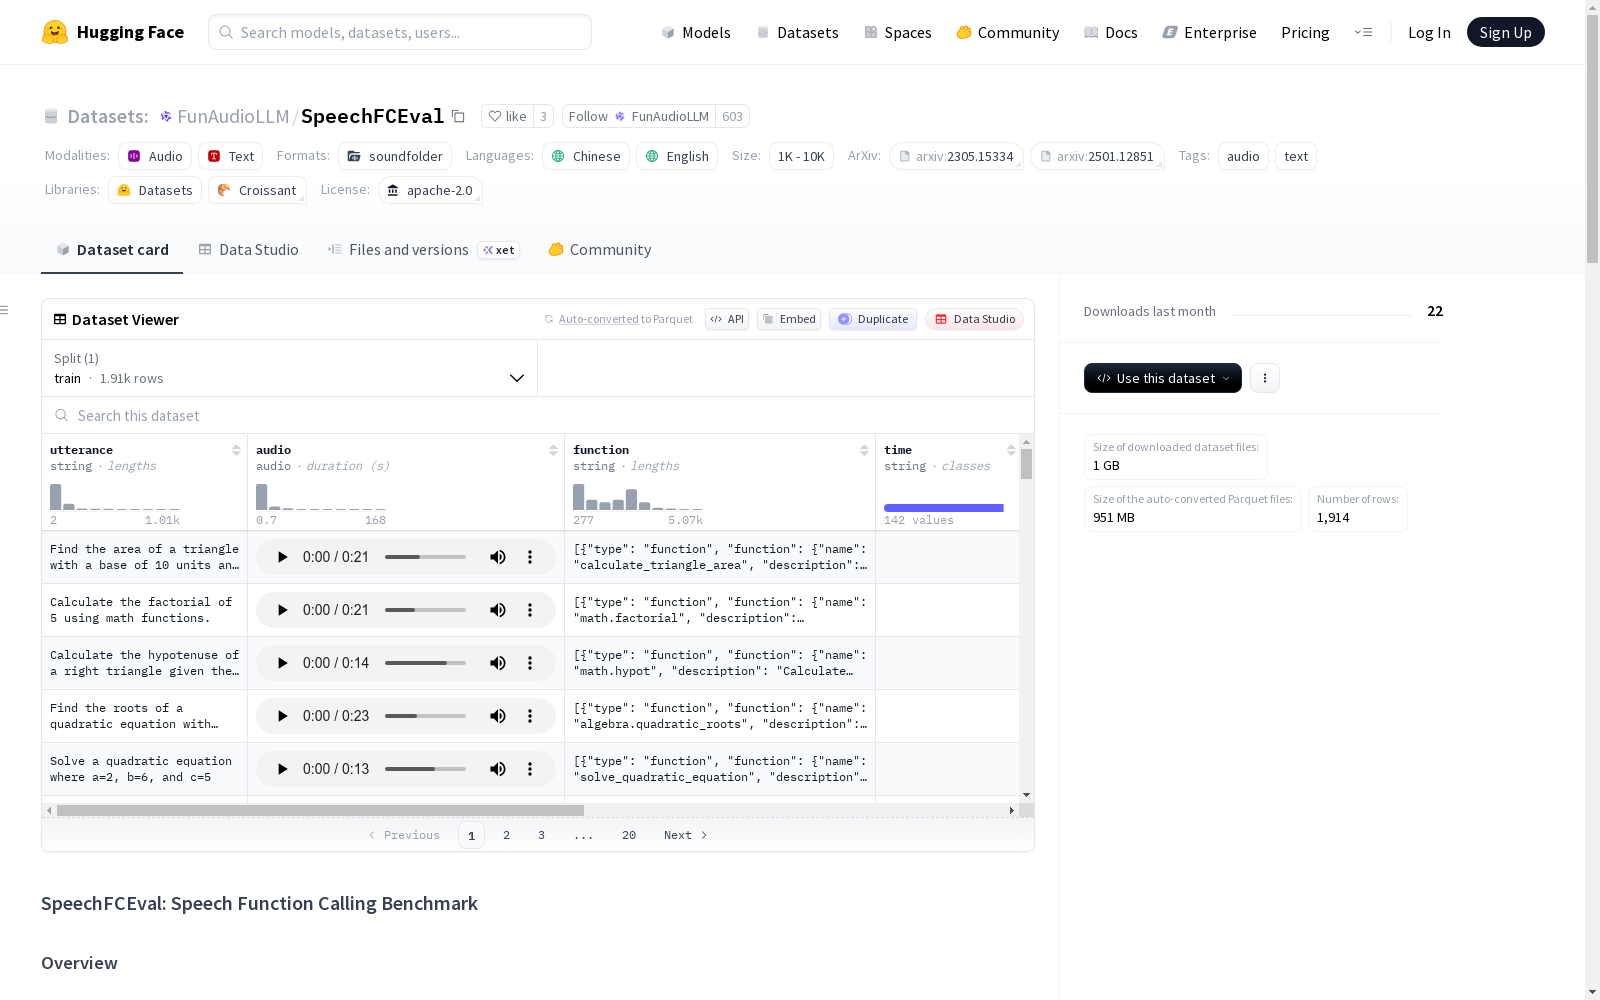
utterance: 用户的口语查询或指令(转录文本)。file_name: 对应 WAV 音频文件的文件名。function: JSON 格式。该示例的候选工具列表。根据子集不同,可能包含单个或多个候选(包括并行调用情况)。time: 时间信息(仅存在于源自 ACEBench 的子集中)。ground_truth: JSON 格式。用于评估的黄金答案(即期望调用的函数及其参数)。category: 子集名称,表明该示例的来源。dataset_key: 示例的唯一标识符,与关联的 WAV 音频文件名匹配(即{dataset_key}.wav)。index: 示例在子集中的索引,从 0 开始。
评估方法
评估细节请参考 SpeechFCEval 评估脚本(https://github.com/FunAudioLLM/SpeechFCEval)。
- BFCL 子集(SpeechFC-BFCL-Single, SpeechFC-BFCL-Parallel):基于 BFCL 评估脚本(https://github.com/ShishirPatil/gorilla/tree/main/berkeley-function-call-leaderboard/bfcl_eval)。
- SmartInteract 子集(SpeechFC_SmartInteract):复用 BFCL 评估脚本。
- ACEBench 子集(SpeechFC_ACEBench_Single, SpeechFC_ACEBench_Parallel):基于 ACEBench 评估脚本(https://github.com/chenchen0103/ACEBench/tree/main/model_eval)。
许可与引用
- 许可证:Apache-2.0
- 语言:中文、英语
- 规模类别:n<1K
- 标签:音频、文本
数据集构建基于并感谢 BFCL(Gorilla, Berkeley Function Calling Leaderboard)和 ACEBench 的作者及社区。请尊重原始数据源的许可证和使用条款。相关引用文献见 README 原文。