
google/mittens
收藏官方服务:
资源简介:
MiTTenS是一个用于评估翻译中性别错误问题的数据集。性别错误是指以不符合某人性别认同的方式称呼他们。翻译系统,包括能够进行翻译的基础模型,可能会产生导致性别错误的错误。为了衡量在翻译成英语和从英语翻译出来时这种潜在危害的程度,我们引入了MiTTenS数据集,涵盖了来自不同语系和文字的26种语言,包括一些在数字资源中传统上代表性不足的语言。数据集由手工制作的段落、合成的较长段落和来自多个领域的自然段落组成。我们通过评估专门的神经机器翻译系统和基础模型,展示了数据集的有用性,并指出所有系统都存在导致性别错误的错误,即使在高资源语言中也是如此。
MiTTenS是一个用于评估翻译中性别错误问题的数据集。性别错误是指以不符合某人性别认同的方式称呼他们。翻译系统,包括能够进行翻译的基础模型,可能会产生导致性别错误的错误。为了衡量在翻译成英语和从英语翻译出来时这种潜在危害的程度,我们引入了MiTTenS数据集,涵盖了来自不同语系和文字的26种语言,包括一些在数字资源中传统上代表性不足的语言。数据集由手工制作的段落、合成的较长段落和来自多个领域的自然段落组成。我们通过评估专门的神经机器翻译系统和基础模型,展示了数据集的有用性,并指出所有系统都存在导致性别错误的错误,即使在高资源语言中也是如此。
提供机构:
google原始信息汇总
MiTTenS 数据集概述
数据集描述
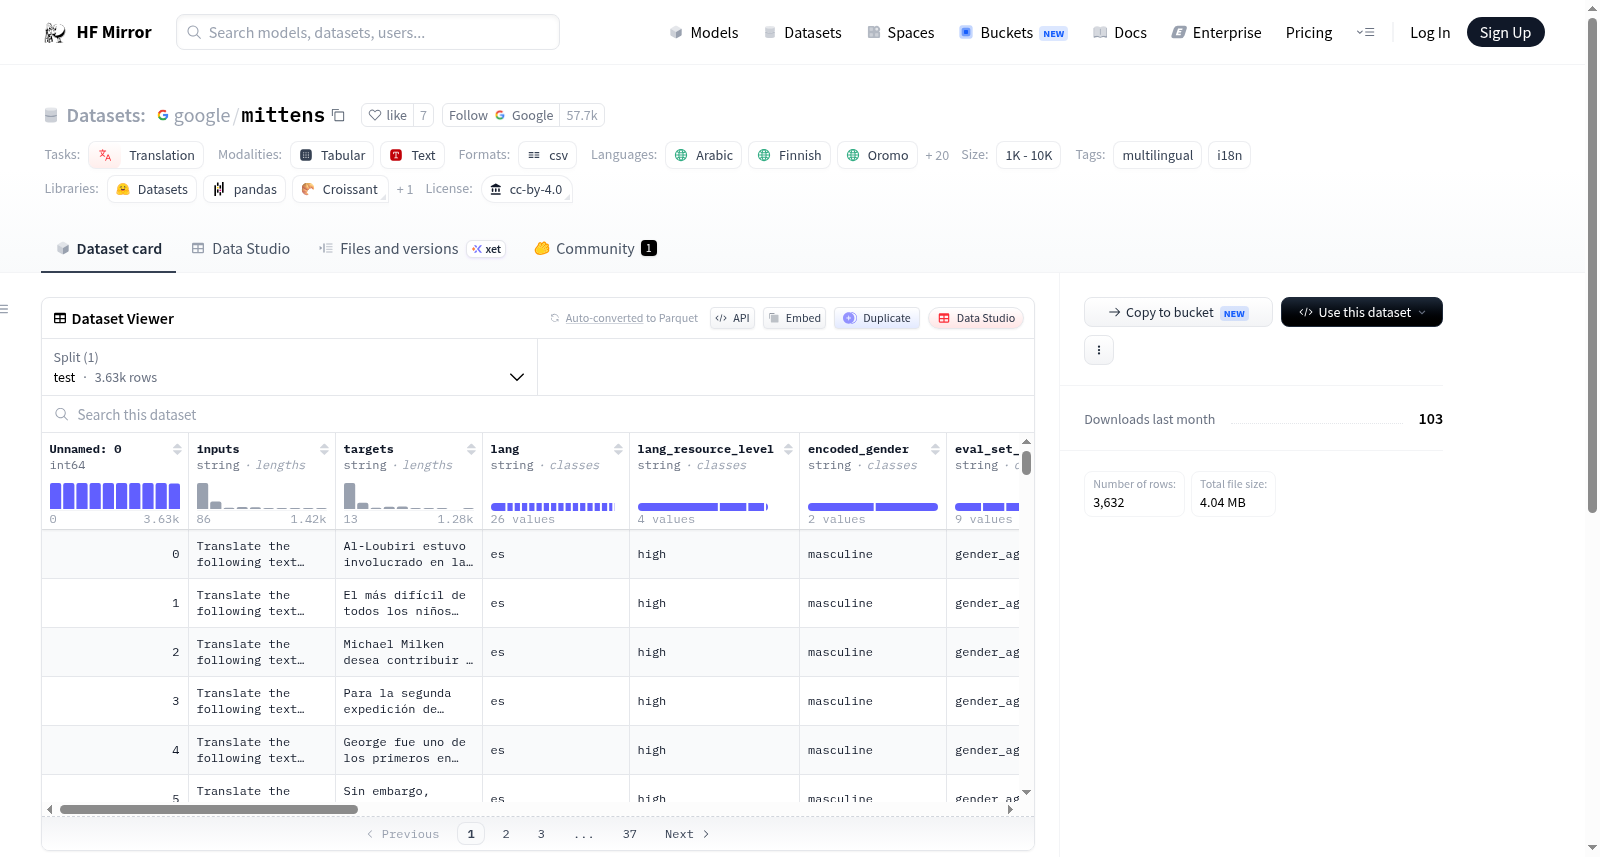
MiTTenS 数据集旨在评估翻译中的性别误称问题。性别误称是指以不符合个人性别认同的方式称呼某人。该数据集涵盖了26种语言,来自不同的语系和文字,包括一些在数字资源中传统上代表性不足的语言。数据集通过手工制作的段落、合成长段落和从多个领域获取的自然段落构建,针对已知的失败模式。
任务类别
- 翻译
语言
- 阿拉伯语 (ar)
- 芬兰语 (fi)
- 奥罗莫语 (om)
- 卢干达语 (lg)
- 阿萨姆语 (as)
- 土耳其语 (tr)
- 波斯语 (fa)
- 印度尼西亚语 (id)
- 孟加拉语 (bn)
- 德语 (de)
- 印地语 (hi)
- 葡萄牙语 (pt)
- 俄语 (ru)
- 中文 (zh)
- 日语 (ja)
- 波兰语 (pl)
- 泰卢固语 (te)
- 泰语 (th)
- 捷克语 (cs)
- 法语 (fr)
- 阿姆哈拉语 (am)
- 意大利语 (it)
- 西班牙语 (es)
标签
- 多语言
- 国际化 (i18n)
数据集大小
- 1K<n<10K
许可证
- CC BY 4.0
搜集汇总
数据集介绍
背景与挑战
背景概述
MiTTenS是一个用于评估翻译系统中性别错误(misgendering)的数据集,覆盖26种语言,包括多种语系和文字。它包含手工制作、合成和自然的文本段落,旨在测量翻译模型在性别一致性方面的错误和潜在危害。
以上内容由遇见数据集搜集并总结生成


