
stefanocarrera/autophagycode_D_mercury_Qwen3-8B_lr0.0001_c142_trust_t0.75_g9_run0
收藏数据链接:
官方服务:
资源简介:
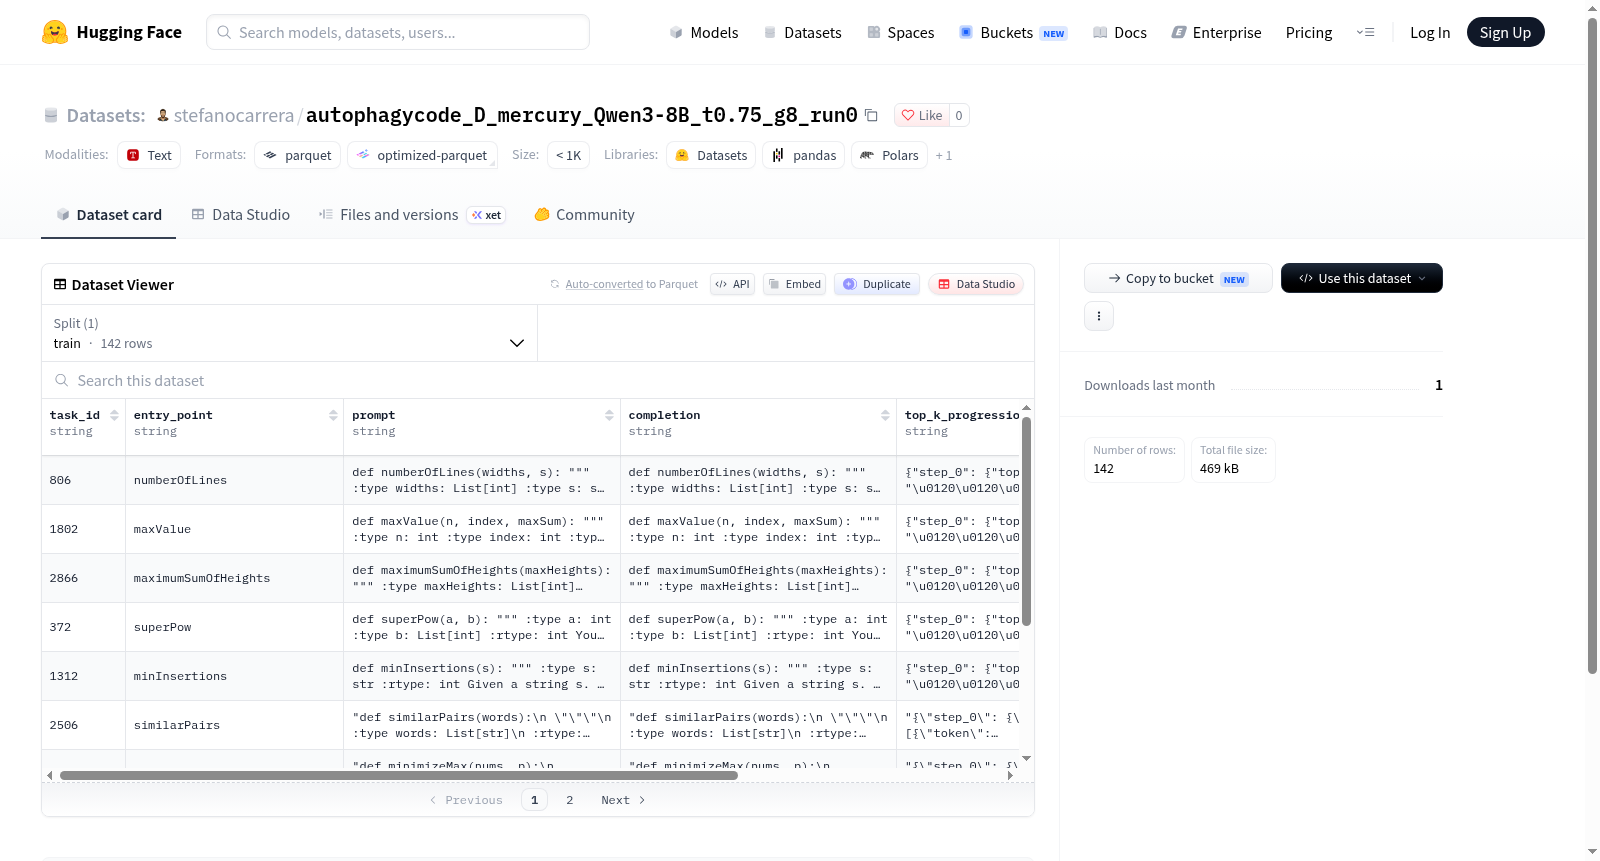
这是一个包含任务相关数据的数据集,主要用于训练或评估目的。数据集结构包括任务ID、入口点、提示文本、完成内容、top-k进展和测试字段,适用于自然语言处理或代码生成任务。数据仅包含训练分割,共142个示例,总大小约为4.1MB。
This is a dataset containing task-related data, primarily used for training or evaluation purposes. The dataset structure includes fields such as task ID, entry point, prompt text, completion content, top-k progression, and test, suitable for natural language processing or code generation tasks. The data consists only of a training split with 142 examples and a total size of approximately 4.1MB.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集以自动化代码生成与评估为背景,构建过程依托于Qwen3-8B模型在特定超参数配置(学习率0.0001、信任度0.75、组大小9)下的生成结果。原始数据通过采样任务标识、入口点、提示、补全、top-k进展及测试用例等字段组织,形成结构化记录。所有142个训练样本经过去重与格式统一,最终以parquet文件形式存储,确保数据可追溯且适配HuggingFace生态。
特点
数据集聚焦于代码生成任务的模型行为分析,涵盖多维度信息:任务标识与入口点便于定位代码单元,提示与补全对反映生成前后状态,top-k进展记录解码动态,测试用例则提供验证依据。整体数据规模适中,适合研究模型在特定配置下的生成模式与错误分布,具备较高的可解释性与复用潜力。
使用方法
使用该数据集时,可借助HuggingFace datasets库直接加载,按字段提取提示与补全对进行模型微调或评估。针对代码生成任务,可结合测试用例执行验证,利用top-k进展分析解码策略的影响。数据集适用于分析模型在特定超参数下的表现,也可作为基准用于对比不同生成方法的优劣,需注意样本量有限,结论应谨慎推广。
背景与挑战
背景概述
近年来,代码生成模型的评估与优化成为程序理解与软件工程交叉领域的研究热点。该数据集由匿名研究团队创建,基于Qwen3-8B模型在特定学习率下生成,包含142个训练样本,涵盖任务标识、入口点、提示、补全、top-k进展及测试等字段。其核心研究问题在于探究自回归代码生成模型在信任度调节下的输出质量与多样性,为代码补全及程序合成任务提供细粒度分析资源。该数据集对模型行为分析和可信代码生成研究具有实证参考价值,推动了生成式编程领域对模型内部动态的深入理解。
当前挑战
代码生成任务本身面临语义正确性、执行效率及上下文依赖的严峻挑战,模型常产生语法合规但逻辑错误的代码。构建过程中,需平衡生成样本的多样性与可执行性,并精确记录top-k进展以刻画模型搜索路径,这对数据标注与验证提出高要求。同时,信任度阈值与采样参数的引入增加了输出变异,导致测试用例设计需覆盖不同生成分布。此外,小样本规模可能限制统计显著性,如何确保数据代表性并推广至更广泛编程场景成为关键难题。
常用场景
经典使用场景
在程序合成与自动化代码生成的学术探索中,该数据集常被用于评估大语言模型在给定任务描述与入口点条件下,生成完整可执行代码的能力。其核心使用场景聚焦于代码补全与函数级生成,研究者借助包含142个训练样本的提示-补全对,系统考察模型在特定解码策略(如top-k采样进程)下的输出质量,从而为代码智能体的训练与推理提供细粒度验证平台。
解决学术问题
该数据集致力于缓解代码生成研究中评测基准稀缺与任务多样性不足的问题,通过提供任务标识、入口点、提示、补全及测试用例等多维字段,支撑对模型泛化性、鲁棒性与正确性的综合评估。其意义在于为自动化编程领域建立可复现的对比实验基础,推动对生成代码功能正确性的严格验证,并影响后续研究对解码策略与模型规模之间关系的深入理解。
衍生相关工作
围绕该数据集,后续研究可能衍生出针对代码生成模型的微调方法、解码策略优化以及基于执行结果的强化学习工作。其结构设计亦启发了一系列以任务标识和入口点为条件的少样本学习实验,并促进了代码大模型在单元测试生成、程序修复等方向的扩展研究,为构建更可靠的自动化编程系统提供了数据基础与方法论参考。
以上内容由遇见数据集搜集并总结生成


