keenbench-results
收藏资源简介:
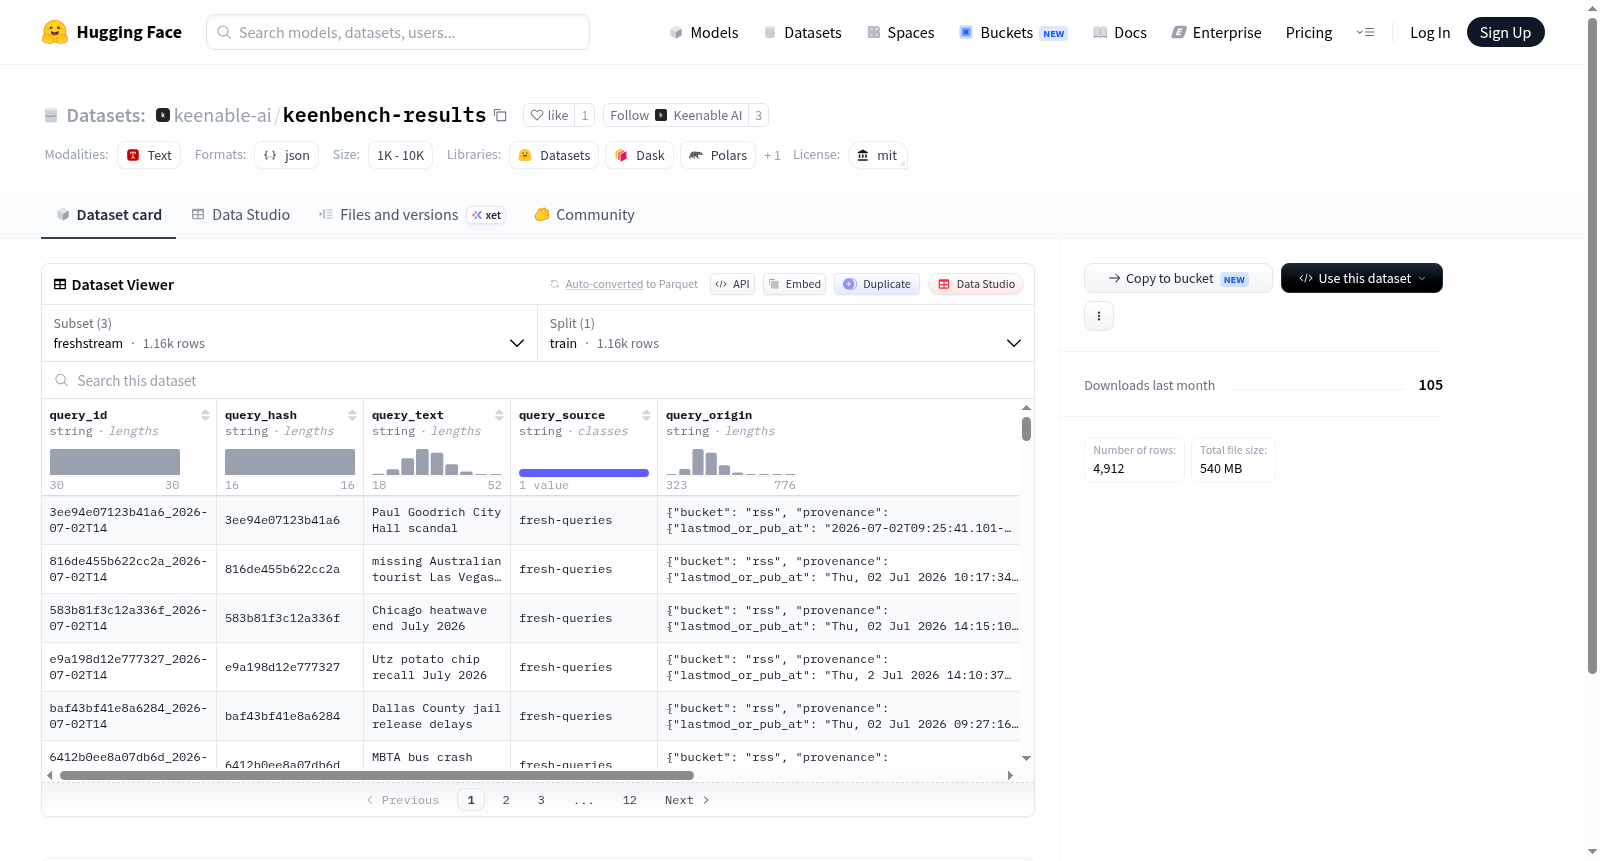
该数据集名为keenbench results,包含来自keenbench计划的搜索引擎基准测试(Keenable与Exa对比)的完整每轮运行产物,由持续集成(CI)发布。数据以时间戳目录结构组织(例如runs/2026-07-02T1505Z/),涵盖多个评估文件:rbp.json提供新鲜流排名评估,包括每查询、每结果的判断评分、LLM判断标签和推理(每小时更新);fresh.jsonl存储从RSS生成的新鲜查询;recall.json包含公司填充答案召回评估,记录每查询结果和命中排名(每日更新);gold.jsonl则包含当天使用的基于注册的黄金查询。所有运行的汇总数据保存在仓库gh-pages分支的data/history.jsonl文件中。该数据集适用于搜索引擎性能评估、查询新鲜度分析、答案召回率测试以及基于LLM的排名判断研究,支持对搜索算法进行持续监控和比较分析。
The dataset, named KeenBench Results, encompasses complete per-run artifacts from the KeenBench program's search engine benchmarking (a comparison between Keenable and Exa), released via Continuous Integration (CI). The data is structured in timestamped directory hierarchies (e.g., runs/2026-07-02T1505Z/), covering multiple evaluation files: rbp.json provides fresh stream ranking evaluation, including judgment scores, LLM judgment labels and reasoning for each query and each result, updated hourly; fresh.jsonl stores fresh queries generated from RSS feeds; recall.json contains company-filled answer recall evaluations, recording per-query results and hit rankings, updated daily; gold.jsonl contains the registration-based gold standard queries used on the current day. Aggregated data from all runs is stored in the data/history.jsonl file under the repository's gh-pages branch. This dataset is applicable to search engine performance evaluation, query freshness analysis, answer recall rate testing, and LLM-based ranking judgment research, supporting continuous monitoring and comparative analysis of search algorithms.
- 数据集名称: keenbench results
- 许可证: MIT
- 配置:
- freshstream(默认): 数据文件路径为
runs/*/fresh.jsonl - companyfill: 数据文件路径为
runs/*/gold.jsonl - scholar: 数据文件路径为
runs/*/scholar.jsonl
- freshstream(默认): 数据文件路径为
- 数据集页面地址: https://huggingface.co/datasets/keenable-ai/keenbench-results