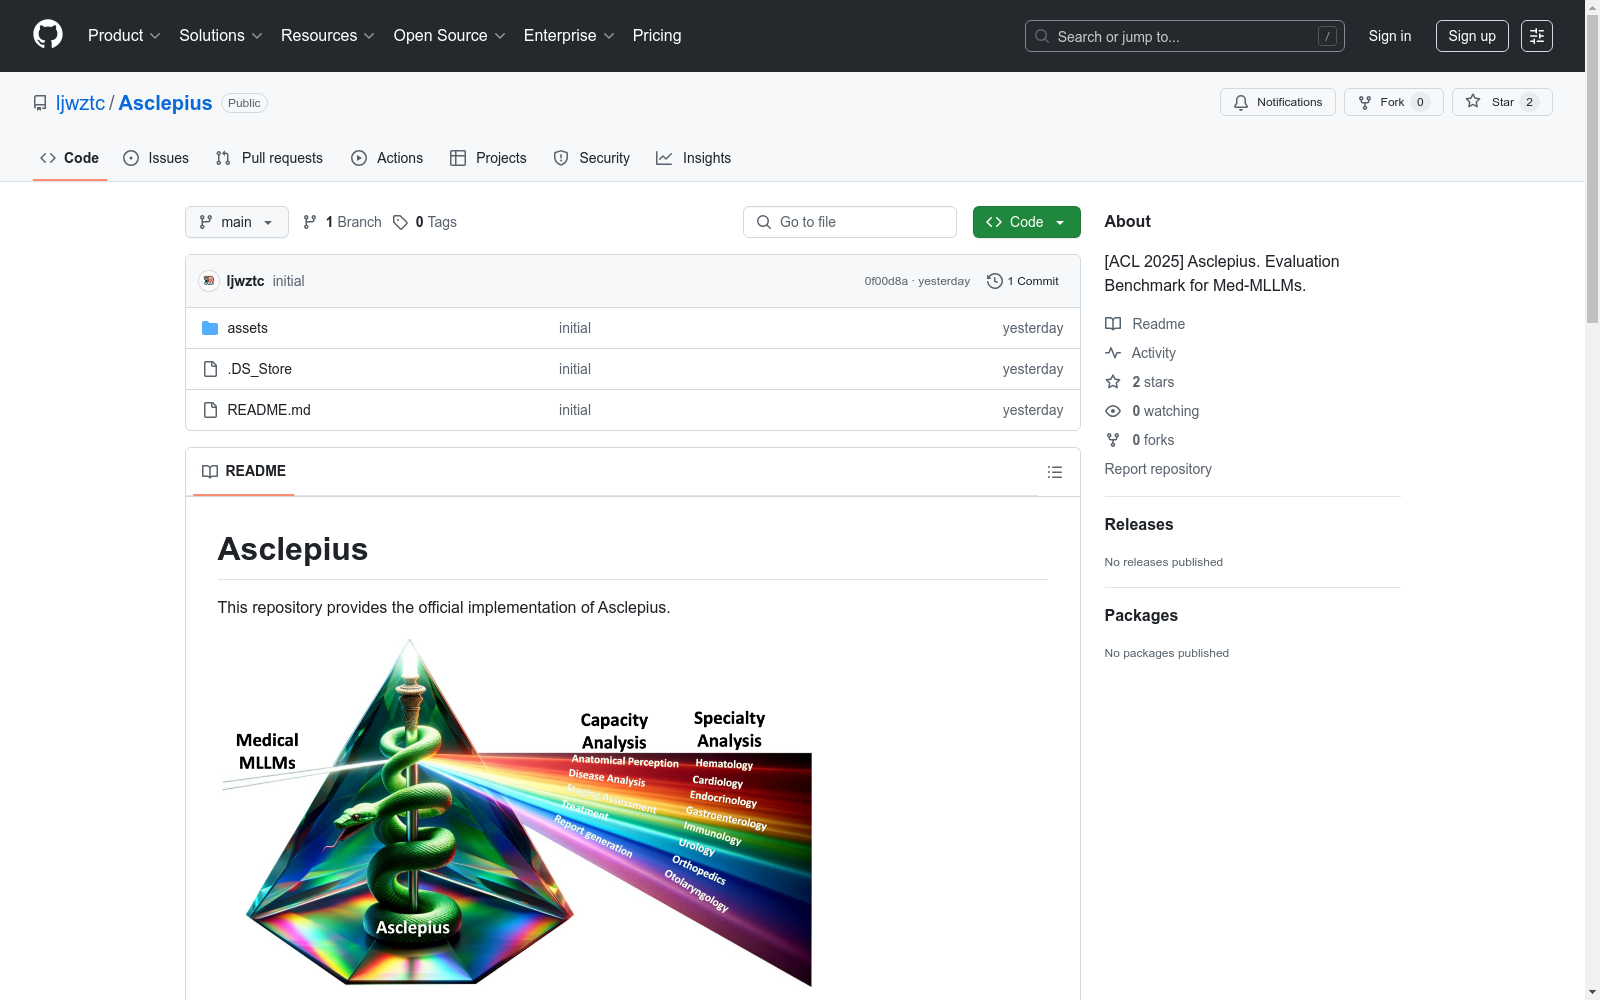
Asclepius
收藏资源简介:
Asclepius是一个全面的基准测试,旨在评估医学多模态大型语言模型(Med-MLLMs)在多个维度上的表现。它涵盖了15个医学专业、8种临床能力,并包含3,232个原始问题。
Asclepius is a comprehensive benchmark designed to evaluate the performance of medical multimodal large language models (Med-MLLMs) across multiple dimensions. It encompasses 15 medical specialties, covers 8 clinical competencies, and includes 3,232 original questions.
Asclepius 数据集概述
数据集简介
Asclepius 是一个用于评估医学多模态大语言模型(Med-MLLMs)的综合基准测试,涵盖多个维度的评估。
数据集特点
-
覆盖范围:
- 15个医学专业领域
- 79个不同的身体部位和器官
- 8种临床能力(包括感知、诊断和规划任务)
- 3,232个原始问题(来源包括医学教科书、USMLE考试和精选医学数据集)
-
评估维度:
- 医学专业领域多样性
- 临床任务多样性
- 多模态融合能力
数据集组成
-
开发集:
- 包含100个公开可用的题目及其标准答案
- 专业领域和能力分布均衡
- 下载地址:https://drive.google.com/file/d/1bzCZ35s3F8BEVspklML1L71xaoq4TDKA/view?usp=sharing
-
测试集:
- 题目公开但不提供标准答案
- 需提交预测结果至评估服务器进行评分
主要发现
- GPT-4V在Med-MLLMs中表现最佳,平均准确率达54.3%
- 不同专业领域间存在显著的性能差异
- 通用MLLMs表现优于专用Med-MLLMs
- 多数Med-MLLMs的多模态融合能力有限
引用信息
bibtex @article{liu2024spectrum, title={A Spectrum Evaluation Benchmark for Medical Multi-Modal Large Language Models}, author={Liu, Jie and Wang, Wenxuan and Su, Yihang and Huan, Jingyuan and Chen, Wenting and Zhang, Yudi and Li, Cheng-Yi and Chang, Kao-Jung and Xin, Xiaohan and Shen, Linlin and others}, journal={arXiv preprint arXiv:2402.11217}, year={2024} }