遇见数据集

asia-who-age-standardized-death-rates-0000001437

收藏
Hugging Face2026-05-23 更新2026-05-24 收录
官方服务:

资源简介:

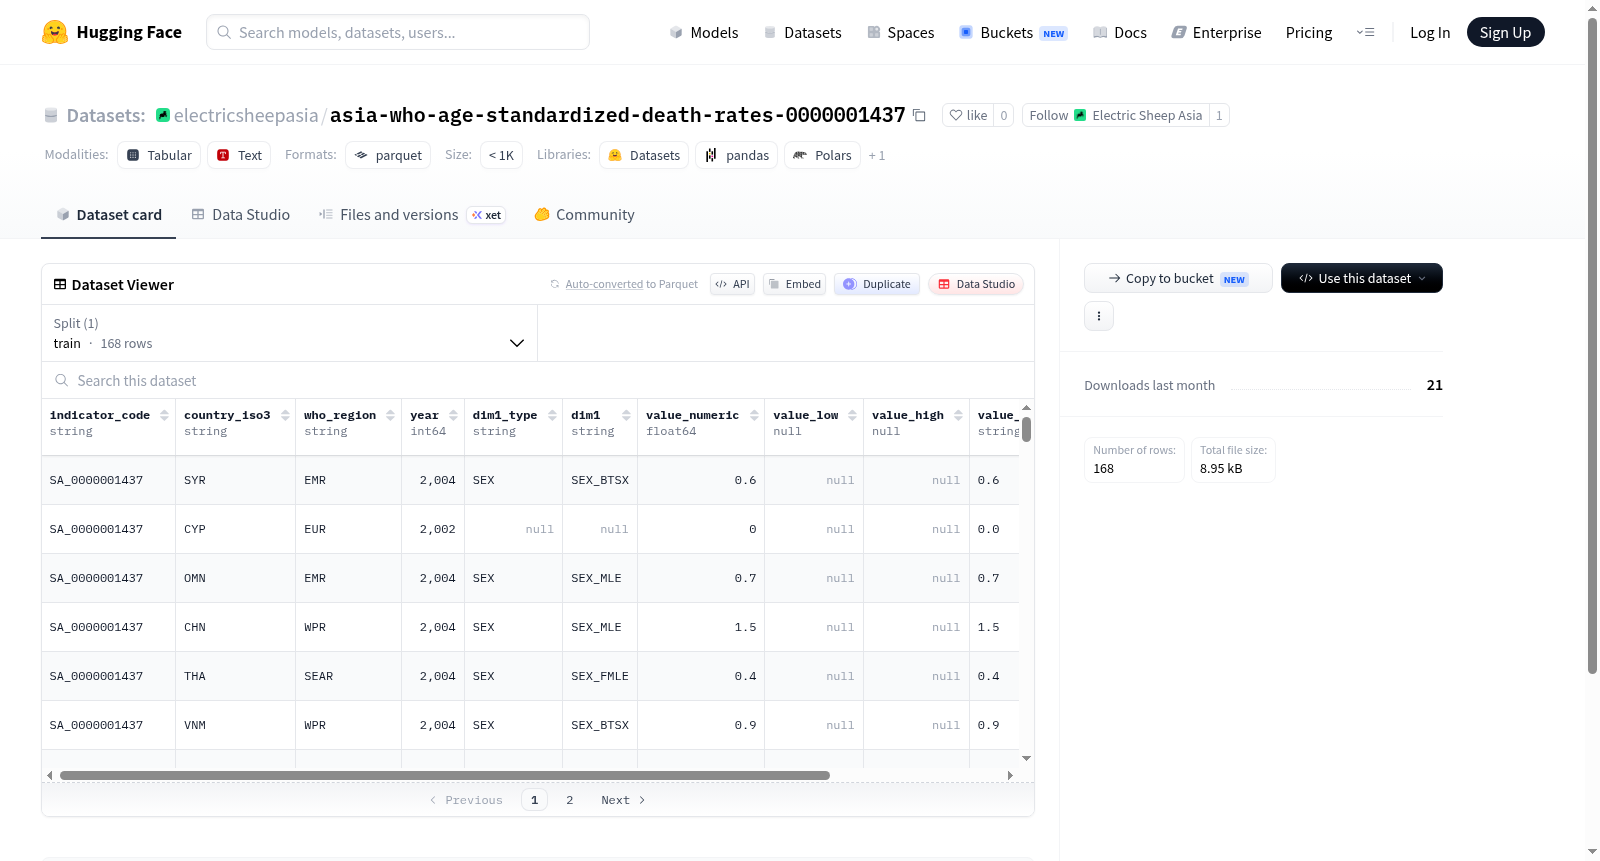
该数据集是一个结构化的健康指标数据集,涵盖全球或区域层面的健康相关测量数据。数据以表格形式组织,核心字段包括:指标代码(indicator_code)、国家 ISO3 代码(country_iso3)、世界卫生组织区域(who_region)、年份(year)、维度类型(dim1_type,如人口分组)、维度具体值(dim1)、数值(value_numeric)、数值下限(value_low)、数值上限(value_high)、用于显示的文本值(value_display)以及数据最后更新时间(last_updated)。数据集共包含168个样本,文件大小约为16.7 KB,适用于健康指标分析、跨国家或跨时间趋势比较、公共卫生研究以及数据可视化等任务。

This structured health indicator dataset encompasses health-related measurement data collected at the global or regional level. The data is organized in tabular format, with core fields including: indicator_code, country_iso3, who_region, year, dim1_type (e.g., population grouping), dim1, value_numeric, value_low, value_high, value_display (text value for display purposes), and last_updated. The dataset contains a total of 168 samples, with a file size of approximately 16.7 KB, and is applicable to tasks such as health indicator analysis, cross-national or cross-temporal trend comparison, public health research, and data visualization.

创建时间:
2026-05-18
原始信息汇总

数据集概述

数据集名称:asia-who-age-standardized-death-rates-0000001437

数据集描述:该数据集来自世界卫生组织(WHO),包含亚洲地区年龄标准化死亡率的相关数据。

数据集特征

  • indicator_code:指标代码,数据类型为字符串。
  • country_iso3:国家ISO3代码,数据类型为字符串。
  • who_region:WHO区域,数据类型为字符串。
  • year:年份,数据类型为64位整数。
  • dim1_type:维度1类型,数据类型为字符串。
  • dim1:维度1的具体值,数据类型为字符串。
  • value_numeric:数值型数据,数据类型为64位浮点数。
  • value_low:数值下限,数据类型为null(缺失)。
  • value_high:数值上限,数据类型为null(缺失)。
  • value_display:显示用数值,数据类型为字符串。
  • last_updated:最后更新日期,数据类型为字符串。

数据集大小

  • 总大小:16,703 字节。
  • 下载大小:5,780 字节。

数据划分

  • 训练集(train):包含168个样本,占16,703字节。

配置文件

  • 配置名称:default
  • 数据文件路径:data/train-*
搜集汇总
数据集介绍
asia-who-age-standardized-death-rates-0000001437 数据集图片
构建方式
该数据集名为asia-who-age-standardized-death-rates-0000001437,聚焦于亚洲区域年龄标准化死亡率这一关键公共卫生指标。构建过程基于世界卫生组织(WHO)的官方统计框架,系统收集并整合了各国上报的死亡登记数据。数据集包含168条训练样本,每条记录均包含indicator_code(指标代码)、country_iso3(国家ISO3代码)、who_region(WHO区域)、year(年份)、dim1_type(维度类型)及dim1(维度值)等字段,以标准化格式呈现。value_numeric字段存储核心死亡率数值,而value_low与value_high字段本应为置信区间范围,但在该版本中均为空值,表明数据发布方可能仅提供了点估计值。最终数据以Parquet格式存储,便于高效加载与分析。
特点
该数据集的核心特点在于高度结构化且具备跨时空可比性。通过country_iso3与who_region字段,研究者可轻松实现国别间及区域内的横向对比;year字段则支持纵向趋势分析,适用于追踪特定疾病或死因的死亡率随时间演变规律。dim1_type与dim1字段组合提供了维度细分能力,例如可按性别或年龄组分层,从而深入挖掘不同亚群间的死亡率差异。尽管缺少置信区间,但value_numeric字段直接提供了年龄标准化的精确数值,消除了人口年龄结构差异带来的偏倚。此外,last_updated字段记录了数据更新时间,确保了信息时效性,便于进行定期更新与版本管理。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载,默认配置为default,数据文件位于data/train-*路径下。借助Python环境,用户可调用load_dataset函数将其导入为DataFrame格式,利用pandas等工具进行后续清洗与可视化。建议首先检查value_low与value_high字段的空值情况,若需置信区间可自行通过外部WHO原始资料补全。对于跨年份或跨国家分析,可按year与country_iso3字段分组聚合,或利用who_region字段进行区域汇总。此外,dim1字段可结合dim1_type进行过滤,例如仅筛选性别为“Male”的数据,从而聚焦特定维度的死亡率研究。
背景与挑战
背景概述
该数据集由世界卫生组织(WHO)创建,专注于提供亚洲地区按年龄标准化的死亡率数据。研究背景根植于全球公共卫生领域对疾病负担量化与跨国比较的迫切需求。通过整合各国死亡登记与统计信息,数据集以标准化的死亡率指标为核心,旨在揭示不同国家、区域及人群间的健康差异,从而为政策制定与资源配置提供科学依据。该数据集的问世显著提升了亚洲地区死亡率数据的可比性与可用性,对流行病学、全球健康及人口学研究产生了深远影响。
当前挑战
数据集面临的挑战主要源于亚健康数据基础设施的薄弱性。一方面,部分亚洲国家死亡登记系统不完善,导致数据缺失或统计口径不一,影响年龄标准化死亡率的计算精度与可信度;另一方面,疾病诊断标准与分类编码的差异增加了跨国比较的复杂性。构建过程中,研究人员需克服数据采集后的清洗与校准难题,包括处理异常值、统一时间序列间隔以及协调不同来源数据的兼容性。这些挑战制约了数据集在区域健康评估与政策优化中的即时应用潜力。
常用场景
经典使用场景
在亚洲区域公共卫生研究中,该数据集作为年龄标准化死亡率的核心数据源,常被用于流行病学建模与疾病负担评估。研究人员通过解析各国不同性别、年龄维度的死亡指标,能够精准描绘特定疾病或全因死亡率的时空演变轨迹。其经典应用场景包括比较东南亚与南亚地区心血管疾病死亡率的差异趋势,或评估空气污染暴露对东亚老年人群死亡风险的长期影响。
衍生相关工作
基于该数据集,衍生出多项重构亚洲死亡数据序列的经典工作。有研究通过填补高龄组死亡数据缺失值,提升了寿命表编制的区域准确性;另有工作整合气象与社会经济协变量,构建了高温热浪对超额死亡率的预测模型。这些衍生成果共同推动了跨学科死亡地理学的理论发展,并为全球健康数据集的本土化校准提供了方法论范式。
数据集最近研究
最新研究方向
该数据集聚焦于亚洲地区按年龄标准化的死亡率分析,为全球公共卫生领域的前沿研究提供了关键数据支撑。近期研究方向包括利用该数据追踪慢性非传染性疾病(如心血管疾病、糖尿病)在亚洲各国的时空演变趋势,并结合新冠疫情等重大公共卫生事件,评估其对不同年龄段人群的长期健康影响。数据中的WHO区域划分与年份维度,使研究者能够量化医疗政策、环境暴露及社会经济因素对死亡率的干预效果,尤其在老龄化加速的东亚与南亚地区,该数据集推动了健康不平等问题的跨文化比较研究,为世界卫生组织制定区域性健康战略提供了实证基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务