
Gaming AI Corpus
收藏官方服务:
资源简介:
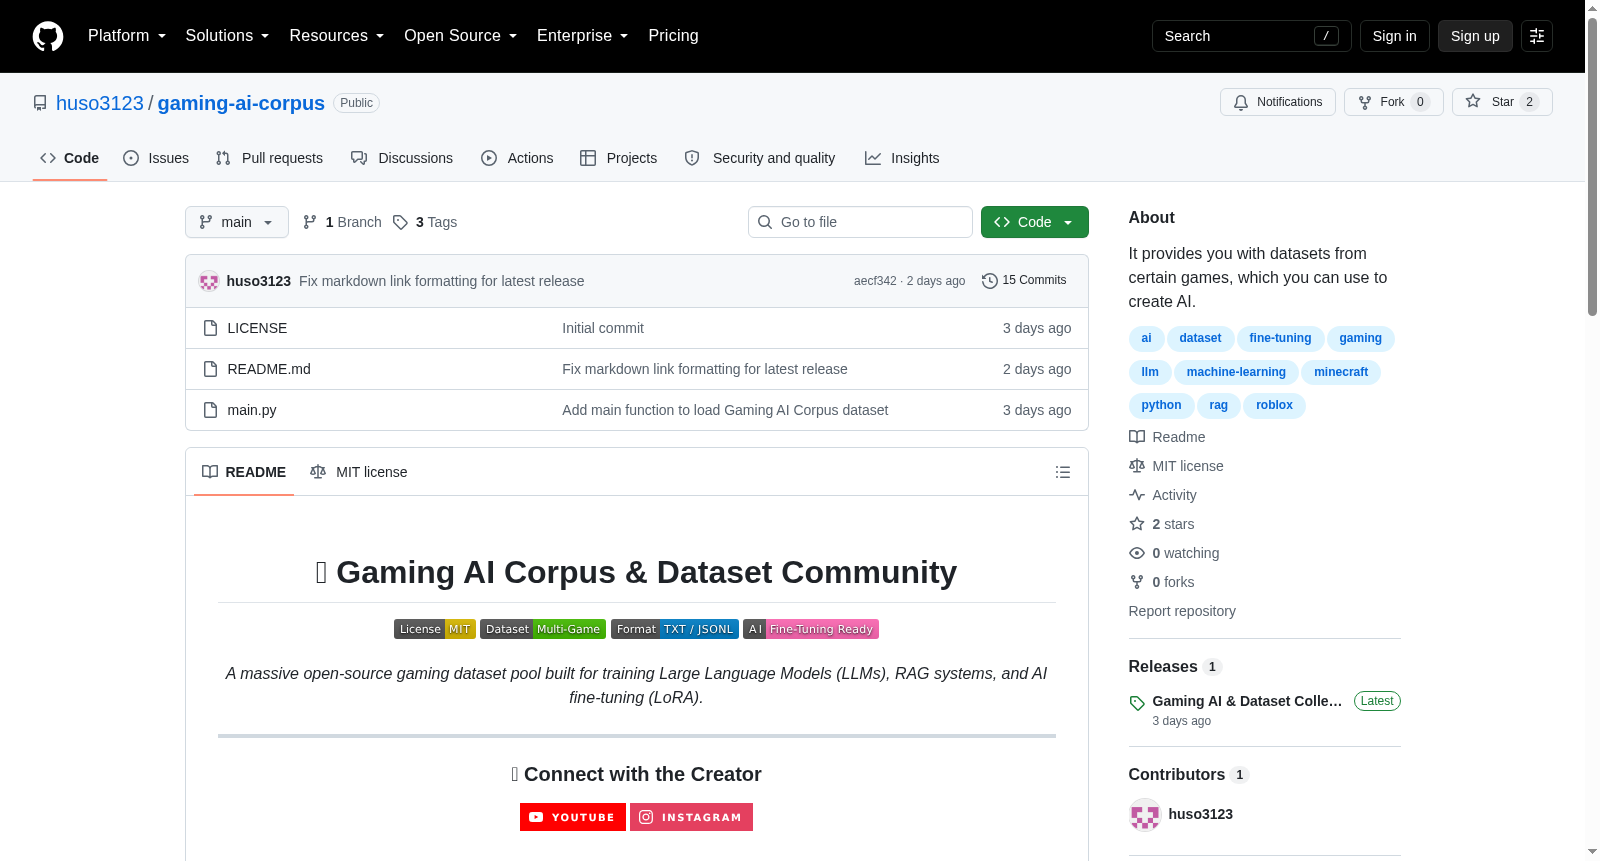
一个大规模的开源游戏数据集池,用于训练大型语言模型(LLM)、RAG系统和AI微调(LoRA)。提供高质量、预处理过的游戏数据集,涵盖GTA V、Minecraft和Roblox等游戏,包含游戏机制、脚本、知识等内容。
A large-scale open-source game dataset pool for training Large Language Models (LLMs), Retrieval-Augmented Generation (RAG) systems and AI fine-tuning (LoRA). It provides high-quality, preprocessed game datasets covering titles such as GTA V, Minecraft and Roblox, with content including game mechanics, scripts and relevant knowledge.
创建时间:
2026-08-28
原始信息汇总
🎮 Gaming AI 语料库数据集
项目概述
一个面向开源 AI 社区的高质量游戏领域数据集,致力于为大型语言模型(LLMs)、RAG 系统和 AI 微调(LoRA)提供训练数据支持。开发者可利用该数据集对 Llama、Mistral、Gemma 及 GPT 架构等基础模型进行微调,构建专业游戏助手、聊天机器人和知识库。
数据集特点
- 数据纯净:已去除无关 HTML 标签、模板和噪声
- 多游戏覆盖:深度涵盖 Minecraft、Roblox(Luau 与游戏机制)及 GTA V / FiveM 脚本与文档
- 内容丰富:包含游戏机制、Luau 与 LUA 脚本逻辑、世界观设定、生物数据、生物群系、物品、合成配方、原生函数及服务器管理等内容
- 应用场景:适用于 LoRA/QLoRA 微调、检索增强生成(RAG)及自定义智能体训练
数据集详情
| 特性 | 详情 |
|---|---|
| 当前规模 | 多游戏扩展池 |
| 包含游戏 | 🚗 GTA V / FiveM、⛏️ Minecraft、🧱 Roblox |
| 目标规模 | 多游戏总计 2,000,000+ 行 |
| 支持格式 | 纯文本(.txt)、结构化(.jsonl) |
| 最新版本 | v3.0.0 |
| 许可证 | MIT License |
收录数据集(v3.0.0)
- GTA V & FiveM 语料:涵盖 GTA V 机制、FiveM 脚本、LUA 结构、原生函数以及服务器框架文档(QBCore / ESX)
- Minecraft 语料(
mchakkindakihersey_turbo.txt):70,000+ 行经清洗的 Minecraft Wiki 指南、机制、合成配方和世界观内容 - Roblox 语料(
roblox_70k.txt):经清洗的 Roblox 数据集,涵盖 Luau 脚本、游戏引擎机制、API 结构和 Wiki 指南
获取方式
数据集可通过 Hugging Face(数据集池)或 GitHub Release v3.0.0 进行下载访问,项目采用 MIT 许可证,允许自由使用与分发。
搜集汇总
数据集介绍
构建方式
Gaming AI Corpus 是一个专为大型语言模型(LLM)、检索增强生成(RAG)系统及微调(如 LoRA)精心打造的多游戏开源数据集池。其构建过程强调数据质量与深度覆盖,从 Minecraft、Roblox 及 GTA V / FiveM 等热门游戏中,系统性地收集并清洗了海量文本资料,剔除了无关的 HTML 标签、模板及噪声,保留了游戏机制、脚本逻辑(如 Luau、LUA)、世界观背景、生物群系、物品配方、原生函数及服务器管理等高价值信息。数据集以纯文本(.txt)和结构化 JSONL 格式提供,便于直接集成至各类 AI 工作流中。
特点
该数据集的核心优势在于其多游戏覆盖与内容富集度。当前版本(v3.0.0)已包含超过 70,000 行清洗后的 Minecraft 指南与 Roblox 脚本教程,以及针对 GTA V / FiveM 的综合语料,涵盖游戏机制、QBCore/ESX 框架文档等。数据规模目标超过 200 万行,横跨三大热门游戏,为训练垂直领域 AI 助手或知识库提供了坚实的数据基座。此外,数据严格遵循 MIT 许可,开放自由,支持研究者与开发者进行再分发与商业使用,促进了开源社区在游戏 AI 领域的协作创新。
使用方法
使用此数据集极为便捷。开发者可通过 Git 克隆仓库或直接访问 Hugging Face 数据集页获取数据。数据兼容主流模型架构(如 Llama、Mistral、Gemma 等),支持多种下游任务:可结合 LoRA/QLoRA 技术微调基础模型,打造游戏专属助手或聊天机器人;也可作为 RAG 系统的知识源,构建精准的游戏问答服务。建议根据具体游戏或脚本语言筛选相应子集,并利用文本清洗工具做进一步格式调整,以适应不同训练框架的输入要求。
背景与挑战
背景概述
Gaming AI Corpus 是由开发者 huso3123 创建并维护的一个面向大型语言模型(LLM)训练的开源游戏数据集,于近年发布,旨在为游戏领域的AI研究提供高质量、多游戏的语料资源。该数据集涵盖了 Minecraft、Roblox 以及 GTA V / FiveM 等热门游戏的机制、脚本逻辑、游戏设定及服务器管理等内容,并特别针对 Luau 和 LUA 编程语言提供了丰富的代码与文档数据。其核心研究问题在于如何利用这些结构化数据微调如 Llama、Mistral 等基础模型,以构建专业的游戏助手、聊天机器人和知识库。通过提供清洁、去噪的文本与 JSONL 格式数据,该数据集在开源社区中推动了游戏AI的定制化发展,并为检索增强生成(RAG)和 LoRA 微调等技术提供了实践基础,对游戏AI领域的研究与应用产生了积极影响。
当前挑战
当前数据集面临的挑战首先在于领域问题的复杂性:游戏世界规则繁多且动态更新,要求模型能够理解并推理游戏机制、脚本逻辑及玩家行为,这比通用文本任务更具挑战性。其次,构建过程中需要处理多游戏、多语言的异构数据,清洗原始文档中的HTML标签、模板及噪声,同时保持知识的准确性和完整性,工作量庞大。此外,数据的规模与覆盖面尚待扩展,目标为200万行,但现有版本(v3.0.0)仅包含约7万行以上,需持续爬取、整理来自游戏Wiki、官方文档及社区的内容。最后,不同游戏间的知识差异显著,如何设计统一的格式以支持跨领域的微调和推理,也是当前亟需解决的难题。
常用场景
经典使用场景
Gaming AI Corpus作为大规模开源游戏领域数据集,其核心用途在于为大型语言模型的微调与增强提供高质量语料。研究者可依托此数据池对Llama、Mistral、Gemma等基础模型实施LoRA或QLoRA参数高效微调,培育出精通游戏机制、脚本逻辑与文档知识的专属游戏助手与聊天机器人。同时,该语料库亦适用于构建检索增强生成(RAG)系统,通过注入游戏知识库提升模型回答的准确性与上下文相关度,并服务于自定义智能体训练,赋予其游戏世界内的导航、解谜及交互能力。
解决学术问题
该数据集直面游戏领域人工智能研究的语料匮乏困境,系统性地解决了多款热门游戏(如Minecraft、Roblox、GTA V/FiveM)知识碎片化、格式杂乱、噪声繁多的难题。其精心清洗并结构化的文本与JSONL数据,为学术探索提供了可靠基础,使得研究者能够深入探究游戏机制理解、脚本代码生成、非玩家角色对话系统及玩家行为建模等核心课题。通过提供跨游戏、跨范式的丰富样本,它促进了人工智能在复杂虚拟环境中的泛化能力研究,并为验证大模型在垂直领域的知识注入与指令遵循能力提供了宝贵的试验场。
衍生相关工作
该数据集的发布催生了若干值得关注的衍生科研方向。一方面,基于其多游戏覆盖特性,研究者构建了跨域游戏知识迁移的基准测试,评估模型在Minecraft与Roblox不同逻辑体系间的零样本适应能力,推动了元学习与领域自适应算法的演进。另一方面,利用其结构化JSONL格式,衍生出针对游戏脚本代码生成与补全的专项评测集,激发了关于代码感知语言模型的研究。此外,社区围绕该语料开发的专用RAG检索流程与微调配置,已成为后续工作借鉴的典范,促进了游戏AI领域开源生态的繁荣与标准化进程。
以上内容由遇见数据集搜集并总结生成


