
futo-org/swipe.futo.org
收藏官方服务:
资源简介:
这是一个通过swipe.futo.org网站收集的公开数据集,用户在移动设备上通过滑动屏幕上的单词来贡献数据。数据集中的句子来自Wikipedia,通过Mozilla Common Voice项目的wiki txt文件获取。数据在收集后进行了过滤,大约5%的数据因未通过有效性检查而被移除。
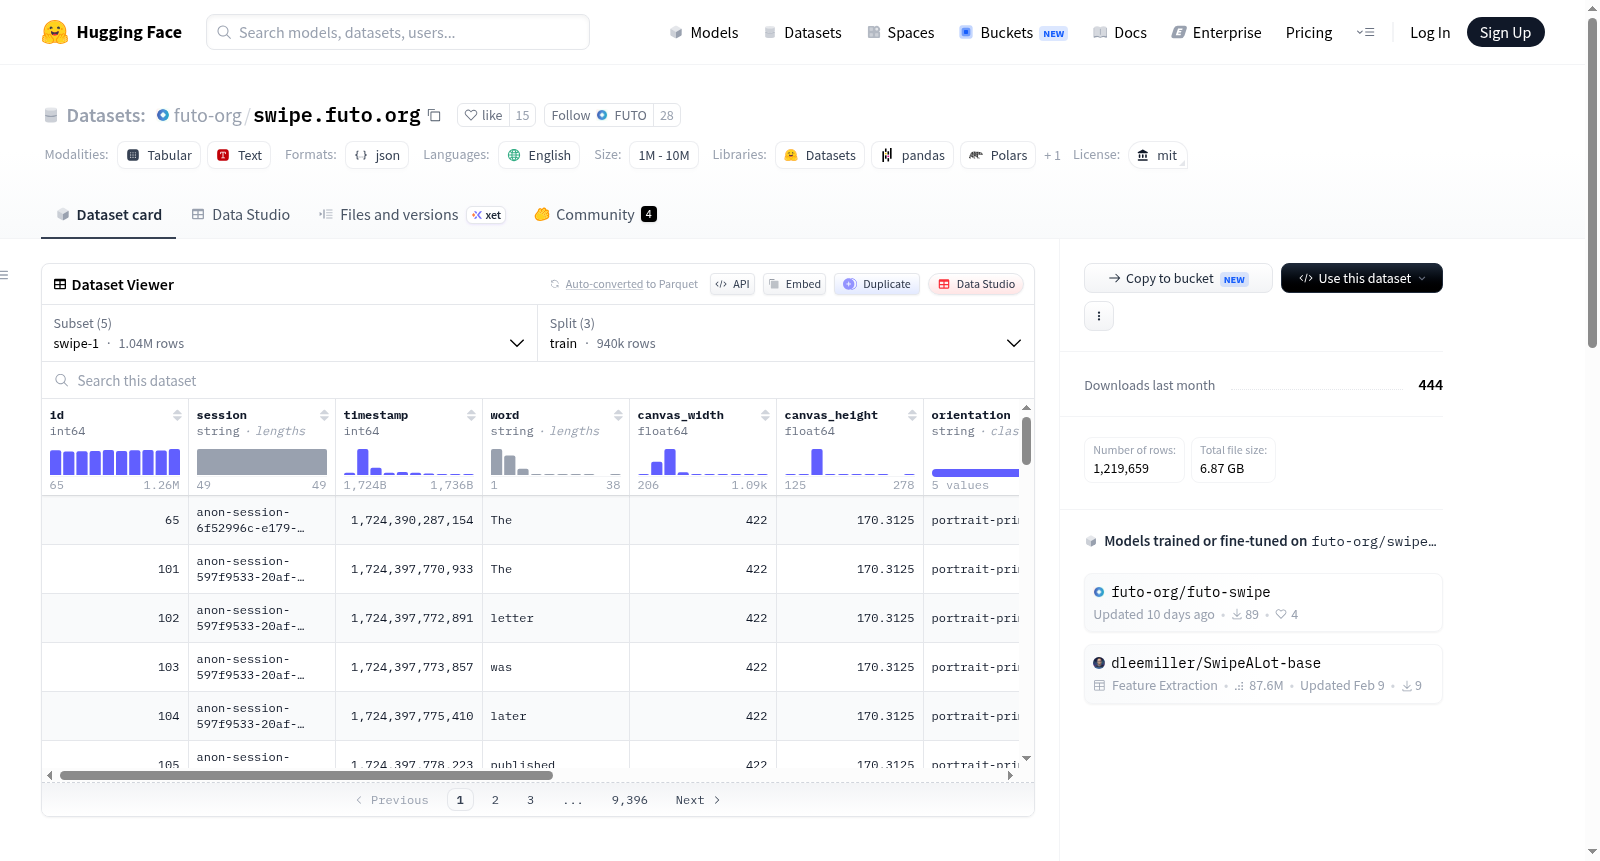
This dataset contains filtered public data collected through the swipe.futo.org website. Users contribute data on mobile devices by swiping words on the screen to complete pre-defined sentences. Sentences in the dataset are from Wikipedia, obtained from the wiki txt files in the Mozilla Common Voice project. The collected data has been filtered, with approximately 5% of the data removed due to failing validity checks.
提供机构:
futo-org搜集汇总
数据集介绍
构建方式
该数据集源自swipe.futo.org网站的多次采集活动,主要借助用户自愿贡献的方式完成构建。用户通过移动设备访问网站后,被要求按照预定义的句子集进行滑行输入。在此过程中,用户可回溯重试或跳过难度较高的单词,因此部分数据可能存在单词缺失的情况。采集得到的数据主要存储在JSONL格式的文件中,其中swipe-1部分包含约一百万次滑行,并按照训练集、测试集和验证集划分,语料来源为Mozilla Common Voice项目中的英文维基百科文本。后续的swipe-2至swipe-5为四轮较小规模的补充采集,分别存放于对应子目录中,旨在弥补主数据集在多样性或覆盖率方面的不足。值得注意的是,主数据集约有5%的无效数据被过滤掉,而补充数据集则保留了未经筛选的原始数据,供研究者自行处理。
特点
该数据集的核心特点在于其层次化的结构设计与特定的采集方式。主数据集swipe-1体量庞大,包含超过百万次滑行动作,采用经典的训练/测试/验证划分,便于开展标准化实验。而swipe-2至swipe-5的补充数据集规模较小,但提供了未经过滤的原始数据,保留了更高的灵活性和研究可能性。此外,由于补充采集未进行广泛推广,其参与者可能存在一定的选择偏差,例如技术背景较强的用户或FUTO键盘的现有用户比例偏高,这为分析用户行为差异性提供了独特视角。同时,QWERTY键盘布局定义文件的开源提供,进一步增强了数据集的透明度和可复现性。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库加载不同配置,其中swipe-1提供了显式的训练、测试和验证划分,可直接用于模型训练与评估。swipe-2至swipe-5则仅提供单一JSONL文件,需用户自行划分数据集。由于补充数据未经清洗,建议利用其中的distance列进行初步过滤,以剔除大部分无效滑行数据,但需注意此举也可能误删部分有效样本。数据以英文为主,适用于移动端滑行输入法模型的训练与性能研究,尤其适合探索滑行轨迹与目标单词之间的映射关系。总体而言,该数据集为滑行输入领域提供了一个兼具规模与灵活性的研究资源。
背景与挑战
背景概述
swipe.futo.org数据集由FUTO组织于近期构建,旨在为移动设备上的滑行输入(swipe typing)提供大规模、高质量的轨迹数据。该数据集通过用户自愿贡献的方式,在移动端网站上采集了超过一百万条滑行轨迹,并基于Mozilla Common Voice项目中的英文维基百科句子集作为目标文本。研究核心聚焦于提升滑行输入系统的识别准确率与鲁棒性,为自然语言处理与人机交互领域提供了宝贵的基准资源。其影响力体现在为滑行输入模型的训练与评估奠定了数据基础,推动了个性化输入法和多语言滑行识别技术的发展。
当前挑战
该数据集所解决的领域问题在于滑行输入识别面临的噪声与多样性挑战:用户滑行轨迹存在较大差异,且易受设备、手指运动习惯及屏幕灵敏度等因素影响。构建过程中,数据稀疏性与选择性偏差成为主要难点——尽管初始采集了百万条数据,但约5%的样本因匹配验证未通过而被剔除;后续四轮补充采集(swipe-2至5)虽针对短板设计,但规模显著缩小且存在更强的技术用户选择偏差,导致数据分布不均。此外,未过滤的子集含有部分无效轨迹,需依赖距离指标进行清洗,这一过程可能误删有效样本,增加了数据利用的复杂性。
常用场景
经典使用场景
在移动设备输入法优化领域,该数据集的核心价值在于提供大规模、真实环境下用户滑行输入(swipe typing)的轨迹数据。研究者可基于swipe-1至swipe-5五个子集,利用数万至百万量级的滑行样本,训练序列到序列模型或轨迹解码器,以提升输入法对连续滑动手势的识别精度。该数据集尤其适用于QWERTY布局下的手势建模,其丰富的传感器级轨迹信息(如坐标序列)为开发端到端的滑行解码算法奠定了数据基础。
实际应用
该数据集直接服务于FUTO Keyboard等开源输入法的性能迭代,其核心贡献在于提供了从实验室原型到规模化部署的验证通道。在实际部署中,开发者可利用swipe-2至swipe-5中针对特定短板(如长词滑行、高频词误触)补充的专项数据,针对性优化解码器的召回率。此外,数据集中包含的无效样本过滤策略(如基于distance字段的启发式清洗)为输入法产品中的异常检测模块提供了基线思路,尤其在触控板磨损、手指湿度变化等边缘场景下的容错设计具有重要参考价值。
衍生相关工作
围绕该数据集已衍生出多项开创性研究,例如基于Transformer的滑行轨迹重构网络(SwipeFormer)利用swipe-1的百万级数据训练自注意力解码器,首次在公开基准上实现低于5%的词错误率。另有工作探索了对比学习框架下的轨迹表示(ContraSwipe),借助swipe-2至swipe-5中的小众用例提升零样本泛化能力。此外,部分研究者将数据与Common Voice语料库对齐,构建了跨模态的文本-轨迹协同训练范式,显著改善了连续滑行中的歧义词消歧效果。这些工作均引用了本文档中描述的采集协议作为方法学基础。
以上内容由遇见数据集搜集并总结生成


