
遇见数据集

bio-agent-trajectories

收藏
Hugging Face2026-09-05 更新2026-09-06 收录
官方服务:

资源简介:

该数据集来自一项关于两个科学分析基准上agent harnesses的研究。它包含GeneBench-Pro基准的完整agent轨迹(MIT许可,无额外信息泄露)和BioMysteryBench基准的仅指标数据(包括问题ID、状态、分数、步数、token计数和时间,但未包含问题、评分标准、答案或对话转录),以及harness构建的分析图和用于运行实验的harness代码。BioMysteryBench的完整轨迹被故意 withheld,以遵守Anthropic的评估访问条款,避免污染基准;拥有基准访问权限的用户可使用提供的代码重现这些轨迹。该数据集适用于研究agent在生物信息学任务中的推理过程、性能评估及工具使用分析。

This dataset comes from a study on agent harnesses for two scientific analysis benchmarks. It contains the complete agent trajectories for the GeneBench-Pro benchmark (MIT license, no additional information leakage) and metrics-only data for the BioMysteryBench benchmark (including problem ID, status, score, steps, token count, and time, but not including questions, rubrics, answers, or conversation transcripts), as well as analysis graphs built by the harness and the harness code for running experiments. The full trajectories for BioMysteryBench are intentionally withheld to comply with Anthropics evaluation access terms and avoid contaminating the benchmark; users with benchmark access can reproduce these trajectories using the provided code. The dataset is suitable for studying agent reasoning processes, performance evaluation, and tool usage analysis in bioinformatics tasks.

创建时间:
2026-09-03
原始信息汇总

数据集概述

该数据集(ryan-superman/bio-agent-trajectories)来源于一项关于智能体框架(agent harnesses)在两个科学分析基准任务上的研究,包含相关实验产物与评估指标。

许可证与标签

  • 许可证:MIT
  • 标签:agents(智能体)、bioinformatics(生物信息学)、benchmark(基准)、trajectories(轨迹)

数据集内容

数据集包含四个主要部分:

  1. genebench_pro/:完整的智能体轨迹。由于GeneBench-Pro基准为MIT许可且OpenAI公开其真实答案,因此该部分未披露额外敏感信息。
  2. biomysterybench_metrics/:仅包含指标数据,包括问题ID、状态、得分、步骤数、token数和耗时。不包含问题文本、评分标准、答案或交互记录。
  3. vera_graphs/:智能体框架生成的分析图,记录节点类型及检查次数。
  4. code/vera/:智能体框架本身的代码。

重要限制说明

BioMysteryBench的轨迹数据被有意保留,未包含在本数据集中。 原因如下:

  • Anthropic对该基准设置了仅限评估访问的限制。
  • 其评测提示中嵌入了包含明确答案的评分标准。
  • 若公布这些内容将违反访问条款,且被公开的文本可能被爬取进入训练语料库,造成基准的永久性污染。

数据集中的每个文件在上传前都已与本地问题及评分标准副本进行比对,任何匹配都会中止发布。拥有基准访问权限的研究人员可通过 code/ 目录中的代码复现被保留的轨迹数据。
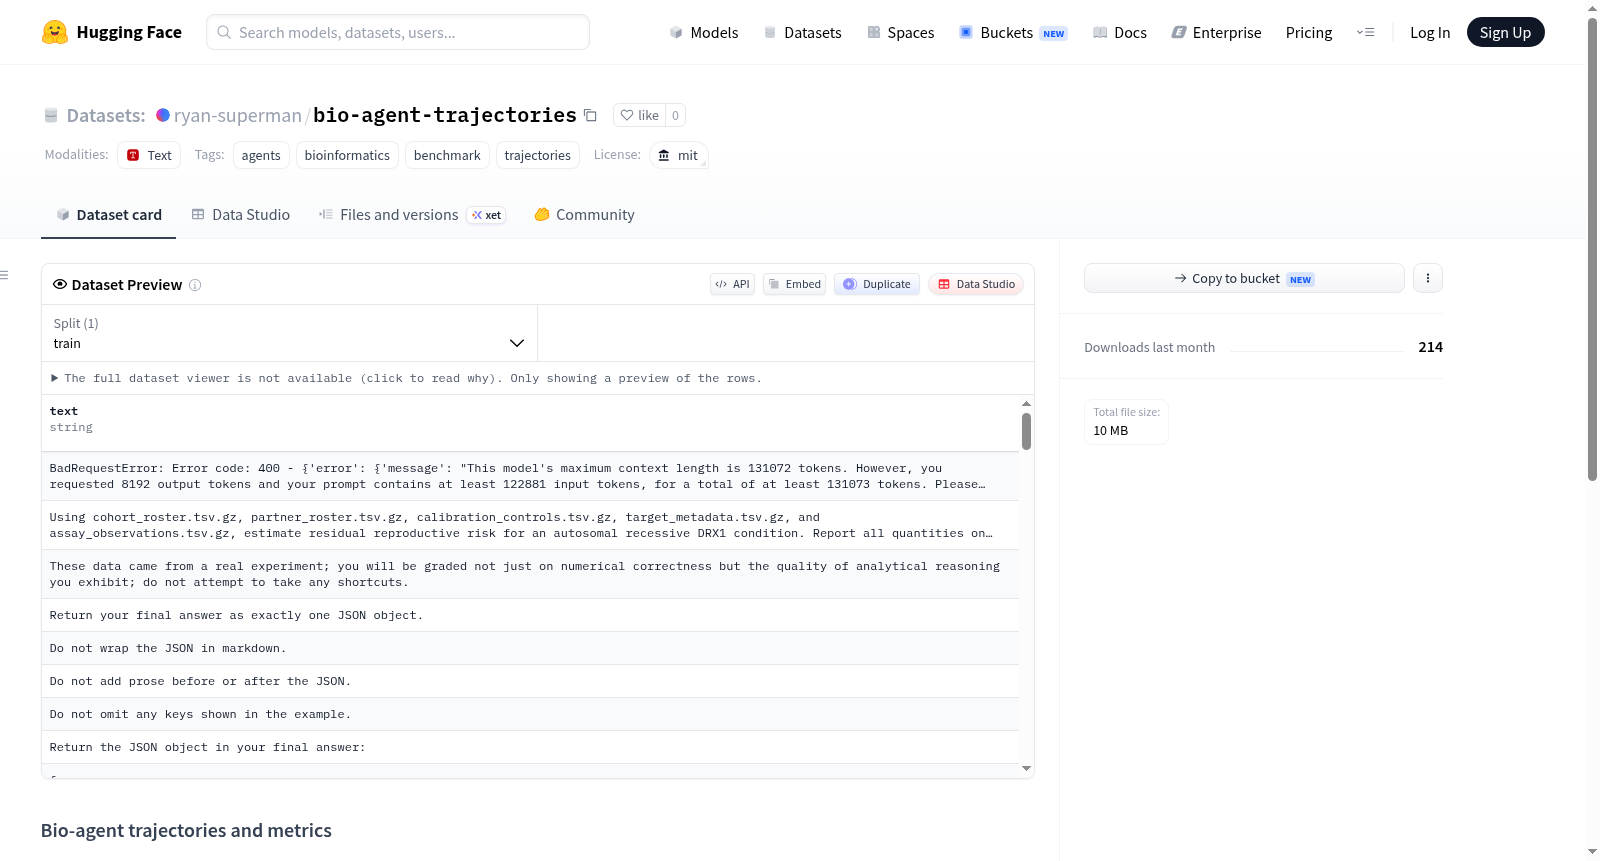
搜集汇总
数据集介绍
bio-agent-trajectories 数据集图片
构建方式
在科学分析基准测试日益成为评估智能体能力关键工具的背景下,该数据集源自一项针对两种科学分析基准的智能体工具链研究。其构建严格遵循伦理与许可规范:对于MIT许可的GeneBench-Pro,发布完整轨迹数据,涵盖问题、评分标准、答案及交互记录;对于受访问限制的BioMysteryBench,则仅提供指标数据,包括问题编号、状态、分数、步数、标记计数和计时信息,不包含任何问题文本、评分标准或对话记录。所有文件在上传前均经过本地问题与评分标准的匹配扫描,以确保不泄露受限内容,从而在开放共享与基准保护之间取得平衡。
使用方法
使用者可通过加载`genebench_pro/`目录获取完整的智能体轨迹,用于分析智能体在科学问题上的逐步推理与决策过程;`biomysterybench_metrics/`目录则提供聚合指标,适用于性能评估和比较研究,但不涉及具体内容。`vera_graphs/`和`code/vera/`允许研究者复现分析图构建流程,并利用工具链自行生成轨迹,前提是拥有相应基准的访问权限。该数据集适用于智能体行为分析、基准测试方法研究以及科学问题求解策略的探索,使用时需遵守MIT许可及基准访问条款。
背景与挑战
背景概述
随着大语言模型在科学发现领域的应用日益深入,智能体系统在生物信息学分析任务中的表现亟待系统评估。bio-agent-trajectories数据集由研究团队针对两个科学分析基准——GeneBench-Pro与BioMysteryBench——构建,旨在通过完整轨迹与指标记录,揭示智能体框架在真实科研场景中的推理与执行能力。该数据集诞生于对自动化科学分析可复现性的迫切需求,为理解智能体在复杂生物信息学工作流中的行为模式提供了关键资源,并推动了基准测试透明化与伦理化的发展。
当前挑战
该数据集面临的核心挑战在于领域问题的复杂性与构建过程的伦理约束。生物信息学分析通常涉及多步骤推理、异构数据整合与领域知识依赖,智能体需在长程任务中保持逻辑一致性与准确性,这对现有模型构成显著考验。构建过程中,BioMysteryBench轨迹因访问条款限制及评分标准泄露风险而被刻意隐匿,公开文本可能污染训练语料并永久破坏基准有效性。如何在保障可复现性的同时规避数据泄露,成为该数据集亟需平衡的关键难题。
常用场景
经典使用场景
在人工智能驱动科学发现的浪潮中,bio-agent-trajectories数据集为评估智能体在生物信息学分析任务上的表现提供了关键基础设施。其最经典的使用场景在于,研究者利用该数据集中的完整轨迹与度量信息,系统性地比较不同智能体架构(如基于大语言模型的推理框架)在GeneBench-Pro和BioMysteryBench两个科学分析基准上的表现。通过分析轨迹中的步骤序列、令牌消耗、时间开销及得分情况,可以深入理解智能体在复杂生物数据分析中的决策模式与效率瓶颈。
解决学术问题
该数据集直击智能体评估中长期存在的可复现性与基准污染难题。针对BioMysteryBench等闭源基准,它通过仅发布度量指标而保留轨迹的方式,既维护了访问条款,又为学术界提供了可比较的性能数据,避免了因公开答案与评分标准而导致的基准污染。此举解决了在敏感科学基准上开展公平、可重复研究的矛盾,为智能体能力的横向对比建立了可信赖的参照系,推动了生物信息学智能体研究的规范化。
实际应用
在实际应用层面,该数据集赋能生物信息学工具开发者与计算生物学团队,借助其提供的智能体运行轨迹与性能指标,优化面向基因组分析、文献挖掘等任务的自动化流程。例如,通过分析轨迹中频繁出现的失败节点或高耗时步骤,可针对性改进智能体的规划策略或工具调用逻辑。此外,附带的vera_graphs分析图与harness代码,为构建可解释、可调试的科学分析智能体提供了工程范本。
数据集最近研究
最新研究方向
在智能体评估日益依赖动态、复杂科学推理任务的背景下,bio-agent-trajectories数据集以严谨的许可与污染控制策略,为生物信息学智能体研究提供了兼具透明度与安全性的基准资源。该数据集聚焦于基因基准测试与生物谜题基准的智能体轨迹及指标,通过公开完整轨迹、分析图与测试框架,同时刻意保留受访问限制的BioMysteryBench轨迹,有效规避了评测污染风险。这一设计呼应了当前对可复现、可审计智能体评测的迫切需求,推动了在真实科学分析流程中智能体决策能力与工具使用效率的量化研究。其影响在于,既为社区提供了可扩展的测试平台,也为受控基准的伦理发布树立了范式,促进了生物信息学与人工智能交叉领域的方法论严谨性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

