
Monolist recommendation data
收藏官方服务:
资源简介:
用于Monolist推荐的40万首曲目的声音目录和72个区域艺术家图。
This dataset comprises an audio catalog of 400,000 tracks for Monolist recommendation, as well as 72 regional artist maps.
创建时间:
2026-09-27
原始信息汇总
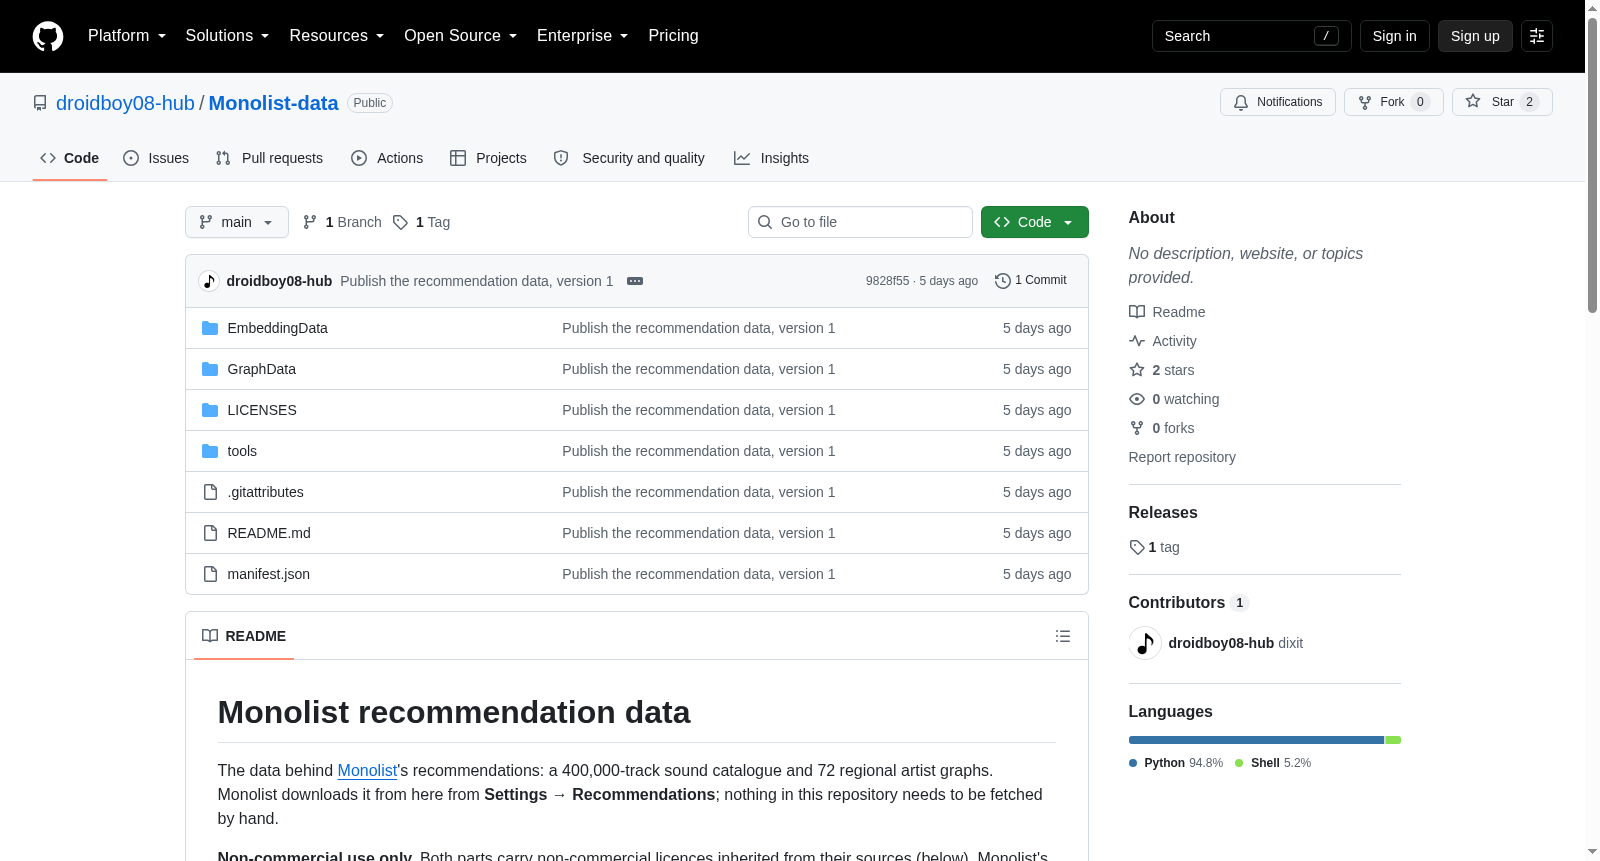
Monolist recommendation data 数据集概述
数据集简介
- 该数据集是 Monolist 推荐系统背后的数据,包含一个 40 万首曲目的声音目录和 72 个地区艺术家图谱。
- Monolist 应用通过 Settings → Recommendations 从该仓库下载数据,仓库中的内容无需手动获取。
- 仅限非商业用途:两部分数据均继承自其来源的非商业许可。Monolist 的代码为 MIT 许可,但本数据不是。
数据组成
| 文件夹 | 内容 | 大小 | 许可 |
|---|---|---|---|
EmbeddingData/ |
40 万首曲目:64 维声音向量(f16)、标题/艺术家匹配键、元数据和流派标签 | 70 MB | CC BY-NC 4.0 |
GraphData/ |
每个国家或地区一个 SQLite 分片:艺术家、其最知名录音以及艺术家之间的关联 | 31 MB | CC BY-NC-SA 3.0 |
tools/ |
构建上述两者的脚本,以及匹配键测试用例 | — | MIT,与 Monolist 相同 |
manifest.json |
每个文件的大小和 SHA-256,应用每次下载时据此校验 | — | — |
数据来源
目录数据 — EmbeddingData/
- 改编自 GD-Studio 的 Embeat 45M Spotify Tracks,该项目许可为 CC BY-NC 4.0。
- 其发布者将其描述为 Spotify 曲目元数据与 Annas Archive 和 Every Noise at Once 数据的结合,并要求仅供研究使用,不得用于商业用途。
所做更改(tools/build_embeddings.py):
- 从 4500 万首曲目中选取 40 万首:每位艺术家最多 8 首,每个流派保证有曲目下限,然后按全球流行度选取。
- 每首曲目的向量在此处计算,而非取自原数据集:56 维流派结构(对艺术家流派标签进行 SVD 分解)和 8 维声学特征,经 L2 归一化并以半精度浮点数存储。
- 标题和艺术家被缩减为匹配键(规范化文本的 FNV-1a 哈希)以供查找,元数据被裁剪为标题、艺术家、流行度和流派。
艺术家图谱 — GraphData/
- 构建自 MusicBrainz 和 ListenBrainz,两者均为 MetaBrainz Foundation 的项目(
tools/export_shards.py、tools/harvest_similar.py)。 - MusicBrainz 核心数据(艺术家、录音、地区、关系)为 CC0。
- MusicBrainz 评分和标签(支撑每位艺术家和录音的
popularity以及共享标签链接)为 CC BY-NC-SA 3.0。 - ListenBrainz 相似艺术家数据(
listenbrainz链接)为 CC0。 - 由于评分和标签采用 ShareAlike,
GraphData/整体以 CC BY-NC-SA 3.0 分发。
免责声明
- 本数据及 Monolist 均与 Spotify、GD-Studio、Annas Archive、Every Noise at Once 或 MetaBrainz Foundation 无关联,也未获其认可。
- 不提供任何形式的担保。
- 若任何人持有本数据中任何部分的权利并反对其在此出现,请提交 issue,将及时处理。
版本
- 每个发布版本为一个 git 标签(
v1……)。 - 应用在某个标签处读取
manifest.json,下载其中列出的每个文件,并拒绝任何大小或 SHA-256 不匹配的文件。
搜集汇总
数据集介绍
构建方式
该数据集的构建融合了多源异构数据的整合与再加工。音频目录部分取自Embeat 45M Spotify Tracks数据集,经筛选保留40万首曲目,确保每艺术家至多八首且各流派均有覆盖,并通过奇异值分解生成56维流派结构向量,结合8维声学特征,经L2归一化后以半精度浮点存储。艺术家图部分则以MusicBrainz核心数据与ListenBrainz相似艺术家数据为基础,按国家或地区分片导出为SQLite数据库,包含艺术家、代表作品及关联链接,所有构建脚本均公开可复现。
使用方法
使用该数据集时,用户无需手动获取任何文件。推荐系统Monolist通过设置中的推荐选项自动从本仓库下载数据,并依据manifest.json校验每个文件的尺寸与SHA-256哈希值。开发者亦可直接调用tools目录下的构建脚本进行复现或定制,同时利用匹配键测试用例验证标题与艺术家键的生成逻辑。需注意,所有数据仅限非商业用途,且需遵守相应的CC BY-NC 4.0与CC BY-NC-SA 3.0许可条款。
背景与挑战
背景概述
音乐推荐系统长期面临冷启动与数据稀疏的困境,跨地域的品味差异更使通用模型难以奏效。Monolist推荐数据集于2024年前后由独立开发者构建,旨在为开源音乐应用Monolist提供可离线分发的推荐底座。该数据集整合了Embeat 45M Spotify曲目元数据与MusicBrainz、ListenBrainz的艺术家关系网络,形成40万首曲目的64维声学向量及72个 regional artist graphs,核心研究问题在于如何在非商业约束下实现轻量级、地域感知的音频推荐。其发布为小众推荐场景提供了可复现的数据基础,并推动了开放音乐信息检索社区对许可合规与图嵌入融合的关注。
当前挑战
在领域问题上,该数据集需应对音乐推荐固有的极端稀疏性与长尾分布,同时兼顾跨文化区域艺术家图的异质性与推荐公平性。在构建层面,数据源自多个许可不兼容的语料,须在CC BY-NC-SA框架下完成清洗、去重与再许可,且需从4500万曲目中筛选40万代表样本并生成64维混合嵌入,涉及大规模向量计算与半精度存储优化。此外,艺术家匹配键的哈希碰撞、跨国区域图的碎片化整合,以及清单文件的完整性校验机制,均对工程可复现性构成挑战。
常用场景
经典使用场景
在音乐信息检索与推荐系统研究领域,Monolist推荐数据集凭借其包含40万首曲目音频嵌入向量(64维)与72个地区艺术家关系图谱的双重结构,成为评估跨模态推荐算法的经典基准。研究者通常利用EmbeddingData中的音质特征与流派标签进行内容感知推荐,同时结合GraphData中基于MusicBrainz和ListenBrainz构建的艺术家相似性网络,探索协同过滤与图神经网络的融合策略,从而在冷启动与长尾推荐场景下验证模型效能。
解决学术问题
该数据集有效缓解了音乐推荐研究中长期存在的数据稀疏性与多源异构难题,其精细的匹配键设计(FNV-1a哈希)与地区分片图结构为跨域推荐、地域文化偏好建模提供了可复现的实验基础。通过整合音频嵌入与社交元数据,研究者得以系统探究内容特征与协同信号的互补机制,推动了推荐系统公平性、可解释性及多模态融合等前沿议题的实证进展,对学术社区构建标准化评测框架具有里程碑意义。
实际应用
在工业级音乐流媒体服务中,Monolist数据集支撑着个性化歌单生成、相似艺术家发现及区域化趋势预测等核心功能。其轻量化的分片SQLite图数据与紧凑的嵌入向量使得移动端与边缘设备能够实现低延迟的本地化推荐,而严格的SHA-256校验与清单机制保障了数据分发的完整性与安全性。该数据集亦被用于构建非商业性音乐探索工具,助力独立音乐人与小众流派获得更精准的受众触达。
数据集最近研究
最新研究方向
Monolist推荐数据集以四十万首曲目的六十四维声学嵌入与七十二个区域艺术家图谱为基石,正推动音乐推荐向多模态图神经网络与跨文化偏好建模的前沿演进。依托MusicBrainz与ListenBrainz的开放关联数据,研究者得以在非商业许可框架下探索艺术家相似性传播与区域风格聚类,为冷启动与长尾推荐提供可复现的基准。该数据集亦呼应了推荐系统公平性与数据伦理的热点议题,其分片式图谱结构支持去中心化实验,对构建可解释、低资源依赖的推荐架构具有显著参考价值。
以上内容由遇见数据集搜集并总结生成


