
遇见数据集

EARS (Expressive Anechoic Recordings of Speech)

收藏
arXiv2024-06-12 更新2024-06-12 收录
官方服务:

资源简介:

EARS数据集是由汉堡大学信号处理团队创建的高质量语音数据集,包含107位来自不同背景的说话者,总计100小时的清晰无回声语音数据。数据集涵盖了广泛的说话风格,包括情感语音、不同阅读风格、非言语声音和自由形式的对话语音。创建过程中,语音在无回声室中以48kHz的采样率录制,确保了高录音质量。该数据集主要用于语音增强和去混响的研究,旨在解决语音处理中的清晰度和质量问题。

The EARS dataset is a high-quality speech dataset created by the Signal Processing Team at the University of Hamburg. It includes 100 hours of clear, anechoic speech data from 107 speakers with diverse backgrounds. The dataset covers a wide range of speaking styles, including emotional speech, various reading styles, non-verbal vocalizations, and free-form conversational speech. During the data collection process, the speech was recorded in an anechoic chamber at a sampling rate of 48 kHz to ensure high recording quality. This dataset is primarily used for research on speech enhancement and dereverberation, aiming to address issues of speech clarity and quality in speech processing.
创建时间:
2024-06-10
搜集汇总
数据集介绍
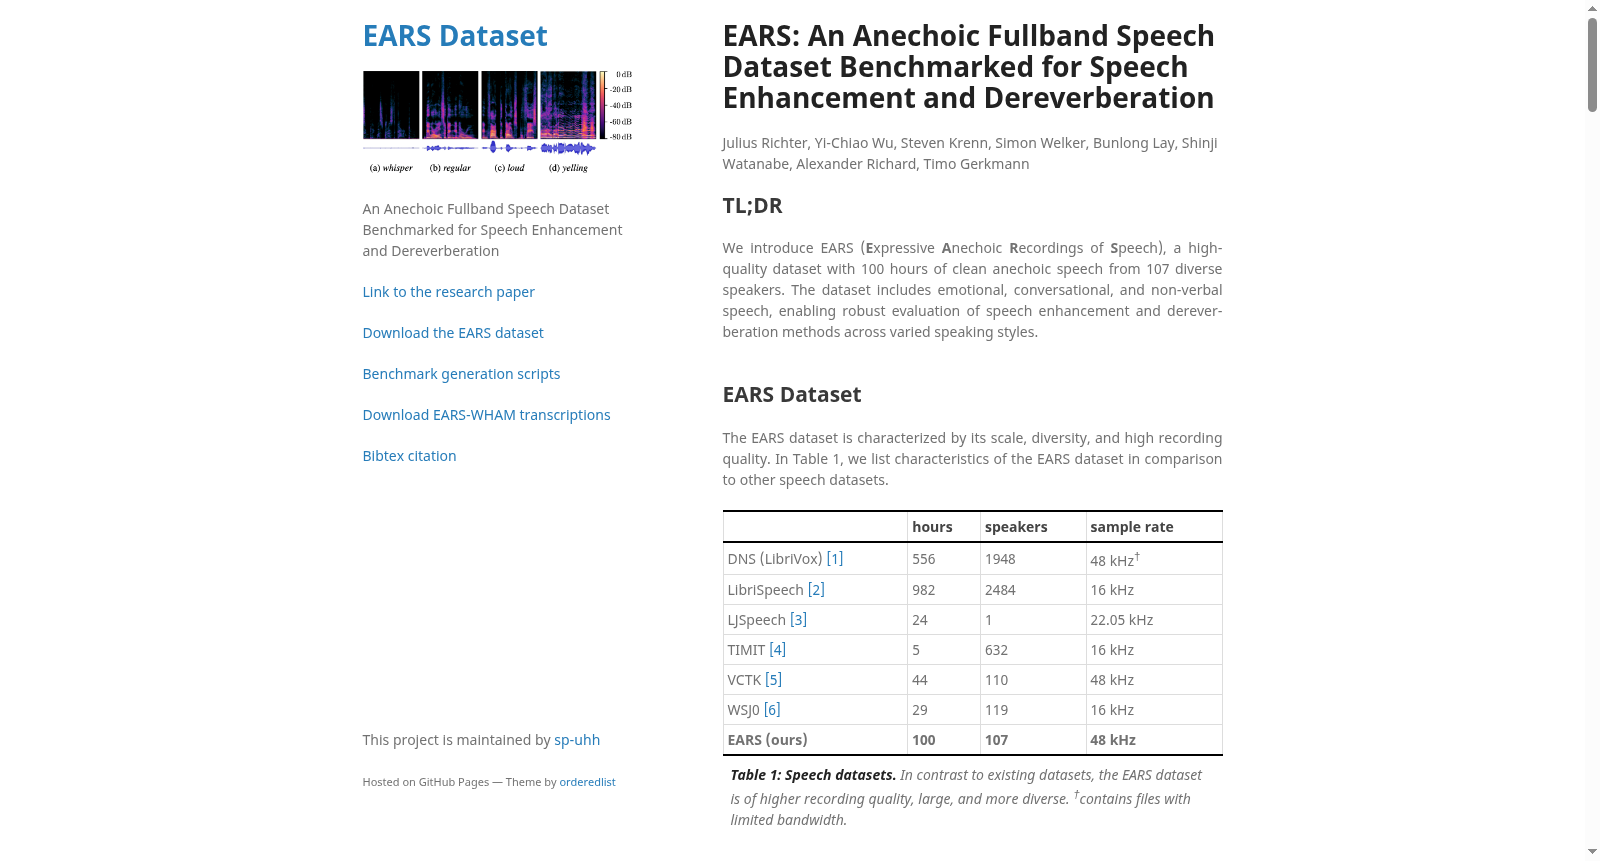
EARS (Expressive Anechoic Recordings of Speech) 数据集图片
构建方式
在语音处理领域,高质量、多样化的数据集是推动算法进步的关键基石。EARS数据集构建于严格的消声环境中,采用32位精度、48千赫兹采样的双麦克风录音方案:高灵敏度GRAS 40HH麦克风捕捉细微语音,低灵敏度GRAS 48BL麦克风则用于高能语音(如喊叫)以避免削波,二者通过传递函数均衡以保持一致性。数据集汇集了107位背景多元的英语使用者,每位录制近一小时,总计100小时纯净语音。录制内容涵盖七种朗读风格、22种情绪下的自由对话及非语言声音,所有文本均来自公共领域或免许可材料,并获取了参与者知情同意。
特点
该数据集的核心优势在于其无与伦比的全面性与高质量。它完整覆盖了人类语音的动态范围——从低语到尖叫,并支持从标准朗读到情感化即兴表达等多种风格。与现有数据集相比,EARS兼具大规模(100小时)、高保真(48千赫兹无混响)与极致的多样性:包含107位不同年龄、性别、种族和母语的说话人,以及22种细腻情绪标签。此外,数据集提供了说话人元数据(性别、年龄、种族、母语)和朗读部分的转录,为多维度研究提供了便利。
使用方法
EARS数据集可直接用于语音增强和去混响任务的基准测试。研究团队已将其划分为训练集(86.8小时)、验证集(1.7小时)和测试集(3.7小时),并构建了两个标准子集:EARS-WHAM(混合WHAM!真实噪声,信噪比随机分布于-2.5至17.5分贝之间)用于语音增强评估,EARS-Reverb(使用多个公开数据集中的真实房间冲激响应进行卷积)用于去混响评估。同时,提供了一个盲测集(含6位未出现在主数据集中的说话人)和在线自动评估服务器,支持上传结果进行标准化比较。用户可从项目网站下载数据集及数据处理脚本。
背景与挑战
背景概述
在语音处理领域,高质量、多样化的数据集是推动算法进步的关键基石。然而,现有公开数据集如LibriSpeech或VCTK常受限于规模不足、录音质量欠佳或说话风格单一等问题,难以全面覆盖人类语音的丰富表达。为弥补这一空白,由汉堡大学信号处理实验室、Meta的Codec Avatars实验室以及卡内基梅隆大学的研究团队于2024年联合创建了EARS(Expressive Anechoic Recordings of Speech)数据集。该数据集收录了107位来自多元背景的说话人,共计100小时的无回声纯净语音,采样率为48 kHz,涵盖了从低语到喊叫的完整动态范围,并包含了七种阅读风格、22种情绪表达、自由对话及非语言声音。EARS的发布为语音增强、去混响、语音合成等任务提供了前所未有的高保真基准资源,其附带的自动在线评估服务器亦促进了可复现研究的开展。
当前挑战
EARS数据集所面临的挑战主要体现在两个层面。在领域问题层面,现有语音增强与去混响方法在应对多样化说话风格和情绪表达时表现参差不齐,例如对耳语音的恢复效果显著弱于常规语音,而不同情绪下的噪声鲁棒性亦存在差异,这要求模型具备更强的泛化能力。在构建过程中,团队需解决高动态范围录音的技术难题,通过同时使用高低灵敏度麦克风并测量传递函数来避免削波,同时确保音质一致性;此外,还需精心设计脚本以覆盖22种情绪及多种非语言声音,并由训练有素的操作员实时监控录制质量,以保障数据的准确性与合法性。最终,数据集的开放共享还涉及严格的伦理审查与参与者知情同意,确保所有录音在CC BY-NC 4.0许可下合规发布。
常用场景
经典使用场景
在语音处理领域,EARS数据集因其高保真度、全频带消声录音及丰富的表达性语料而备受瞩目。其经典使用场景集中于语音增强与去混响任务的基准测试。研究者可借助EARS-WHAM和EARS-Reverb两个子集,在可控条件下对比预测型与生成型模型的性能,从而系统评估算法在真实噪声与混响环境中的鲁棒性。该数据集为方法比较提供了标准化平台,推动了语音处理技术的可重复性研究。
衍生相关工作
基于EARS数据集,衍生出一系列具有影响力的研究工作。其中,SGMSE+作为生成式扩散模型在语音增强与去混响任务上表现卓越,其性能在主观听感测试中超越传统预测型方法如Conv-TasNet和Demucs。此外,该数据集还催生了针对不同输入信噪比、说话风格及情绪状态下的算法鲁棒性分析,为后续开发高效、低延迟的实时语音处理系统奠定了坚实的实验基础与评估范式。
数据集最近研究
最新研究方向
EARS数据集的发布标志着语音处理领域在数据多样性与伦理合规性上迈出了关键一步。该数据集以100小时、48kHz无回声录音为核心,覆盖107位来自多元背景的说话者,囊括从低语到尖叫的完整动态范围、七种阅读风格、22种情绪状态及非言语声音,填补了现有数据集在风格丰富度与录音质量上的空白。当前前沿研究聚焦于利用EARS构建更具鲁棒性的语音增强与去混响基准,特别是生成式方法(如SGMSE+)在主观听觉测试与客观指标上均展现出对预测性方法的显著优势。此外,该数据集通过公开盲测集与自动化评估服务器,推动了可重复且公平的模型比较,其CC BY-NC 4.0许可与完全知情同意流程也为开放科学树立了道德典范,对语音合成、风格转换及下游ASR系统的泛化能力研究具有深远影响。
相关研究论文
  • 1
    EARS: An Anechoic Fullband Speech Dataset Benchmarked for Speech Enhancement and Dereverberation汉堡大学信号处理(SP) · 2024年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

