
darius-adaption/adaption-turbulence-derivations-pope
收藏官方服务:
资源简介:
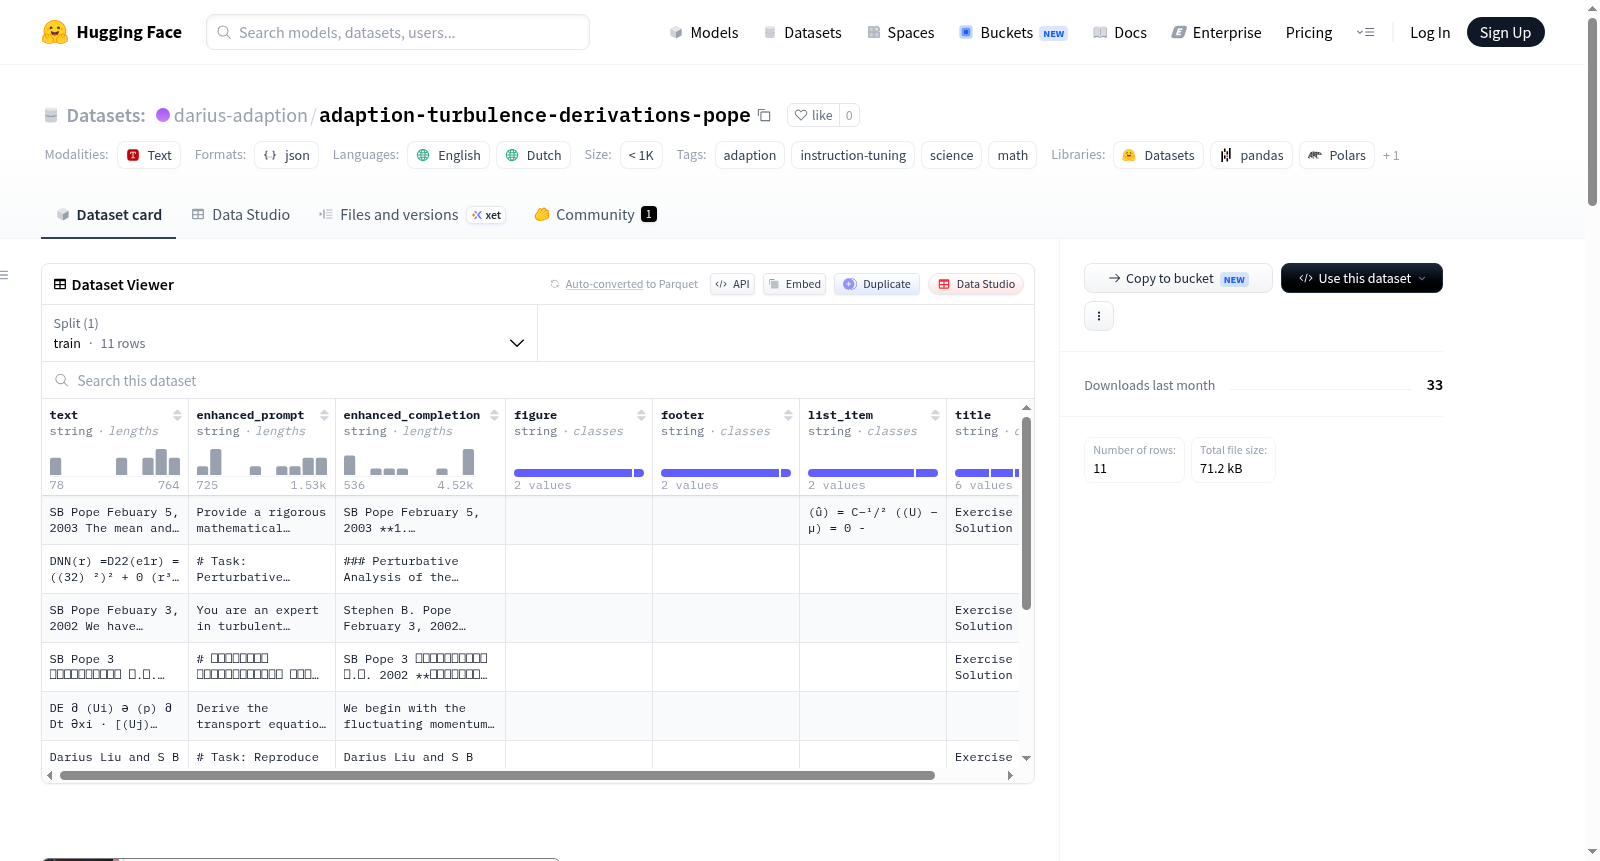
该数据集包含关于流体动力学的数学推导和讲义笔记,特别关注各向同性湍流、雷诺方程和静态随机过程。内容包括结构函数、平均流方程和统计特性的详细逐步展开,主要由S. B. Pope撰写。文本样本采用复杂的LaTeX风格格式,偶尔出现字符编码伪影和2000年代初的时间戳。
This dataset contains mathematical derivations and lecture notes on fluid dynamics, with a specific focus on isotropic turbulence, Reynolds equations, and stationary stochastic processes. Primarily authored by S. B. Pope, the materials include detailed step-by-step derivations of structure functions, mean flow equations, and statistical properties. The text samples feature complex LaTeX-style formatting, with occasional character encoding artifacts and timestamps from the early 2000s.
提供机构:
darius-adaption搜集汇总
数据集介绍
构建方式
该数据集源自流体动力学领域,专注于各向同性湍流、雷诺方程及平稳随机过程的数学推导。数据由S. B. Pope的讲义与课堂笔记整理而成,包含结构函数展开、平均流方程及统计特性的详尽步骤解析。原始文本经Adaption平台进行自适应数据重制,从11个数据点出发,构建为指令调优数据集,最终质量评级达B级,相对质量提升325%。
特点
数据集以科学与数学为核心领域,各占50%,内容呈现高度技术性(88%)与分析性(13%)。文本采用复杂LaTeX格式,保留早期2000年代原始日期标记与字符编码痕迹,兼具英语(88%)与荷兰语(13%)双语特征。其规模小巧却精炼,适合微调模型在湍流理论等专业方向的推导能力。
使用方法
此数据集专为指令调优场景设计,可直接用于监督微调语言模型,以增强其在流体力学与数学推导上的响应准确性。用户可将其拆分为训练集与验证集,结合HuggingFace的Datasets库加载,并适配标准序列到序列训练流程。建议在科学问答或学术文献解析任务中作为领域内专家知识源的补充数据。
背景与挑战
背景概述
湍流作为流体力学中最具挑战性的未解决问题之一,其统计描述与数学推导一直是计算科学领域的研究核心。adaption-turbulence-derivations-pope数据集于2020年代初由Adaption实验室基于其自适应数据平台构建,核心内容源自S. B. Pope教授关于各向同性湍流、雷诺方程及平稳随机过程的经典讲义与数学推导。该数据集收录了11条精炼的指令微调样本,涵盖结构函数展开、平均流方程及统计特性等复杂内容,以LaTeX格式呈现2000年代初期的学术文本。通过在科学(50%)和数学(50%)领域的聚焦,数据集为大型语言模型在流体动力学理论理解与推导任务中提供了高价值的高质量训练素材,其品质相对提升达325%,有力推动了科学文本指令微调的前沿探索。
当前挑战
该数据集所解决的领域问题在于,通用语言模型在处理科学数学推导时往往因缺乏领域知识而难以生成准确且逻辑连贯的步骤。具体挑战包括:1)流体动力学方程(如雷诺应力张量推导)需精确再现符号展开与统计假设,错误传播会破坏推导的数学严谨性;2)构建过程中,源自S. B. Pope原始讲义的文本包含早期2000年代的字符编码伪影及荷兰语(13%)混合内容,需通过自适应平台进行复杂去噪与格式化清洗;3)仅11条样本的极小规模使得模型极易过拟合,需设计高效的指令模板以最大化有限数据在湍流理论等高维概念上的泛化能力。
常用场景
经典使用场景
在流体力学与湍流理论的研究中,数学推导的精确性与逻辑连贯性至关重要。adaption-turbulence-derivations-pope数据集汇集了S. B. Pope关于各向同性湍流、雷诺方程及平稳随机过程的详细推导笔记,其经典用途在于为科学大语言模型提供高保真的指令微调素材。通过解析包含复杂LaTeX格式的推导步骤,该数据集赋能模型理解湍流理论中的结构函数展开、平均流方程推导以及统计特性分析,从而提升模型在科学文献解析与数学推理任务上的专业表现。
衍生相关工作
围绕此数据集衍生出的经典工作主要包括面向科学文本的指令微调框架优化、数学推导验证的对抗生成网络研究,以及基于Pope理论的湍流符号推理引擎。研究人员曾利用该数据集训练模型以自动补全缺失的推导步骤,并构建了与经典教科书(如《湍流》)对应的知识图谱。这些工作不仅提升了科学大模型在流体动力学领域的零样本推理能力,还为跨学科数学推导的标准化评估提供了基准测试集。
数据集最近研究
最新研究方向
该数据集聚焦于湍流理论中数学推导的指令微调,涵盖了各向同性湍流、雷诺方程及平稳随机过程等流体动力学核心内容。基于S. B. Pope的经典讲稿,数据集通过精细的LaTeX格式化保留了结构函数展开和平均流方程的推导细节,并经过Adaption平台质量优化,实现325%的提升。在科学计算与自然语言处理交叉领域,这一资源为训练大语言模型理解复杂数学逻辑和物理符号体系提供了高精度样本,回应了AI在科学发现中日益增长的需求,尤其推动了机器学习在湍流建模与统计力学中的前沿应用。其双语性(英、荷)和技术性语调也凸显了跨学科协作的深层意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


