
遇见数据集

SINAI/ALIA-es-legal-administrative-triplets

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

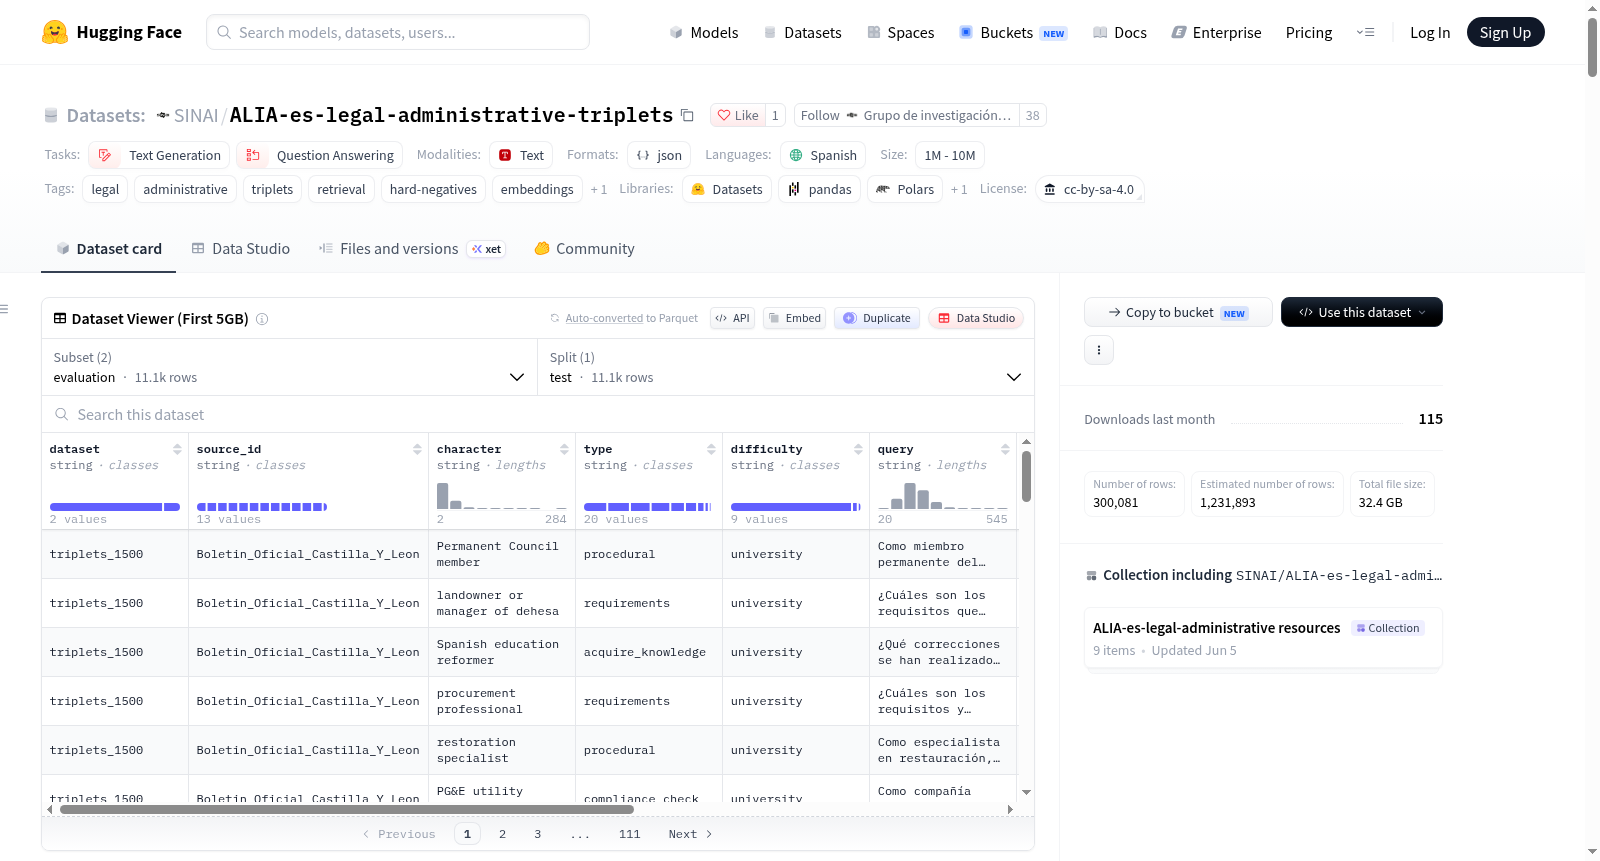
ALIA西班牙法律和行政三元组语料库是一个用于密集检索训练的数据集,专门针对西班牙法律和行政语言领域。它包含从原始查询-段落对中自动生成的困难负样本,这些负样本在语义上与查询相似但不包含正确答案,有助于提升检索模型的鲁棒性和排名性能。数据集分为两个配置:训练配置提供多负样本训练数据,包括查询、一个正段落和多个困难负段落,并带有训练阶段和难度标签;评估配置提供用于检索模型评估的三元组数据,包括查询、段落候选和参考答案。数据集支持多种难度级别(高中、大学、博士),以促进课程学习和模型泛化。生成过程基于SentenceTransformers和FAISS相似性搜索,使用Qwen3-Embedding-0.6B嵌入模型自动挖掘困难负样本。该数据集旨在改进西班牙法律编码器的开发,并促进公民对法律信息的访问。

ALIA Spanish Law and Administrative Triples Corpus is a dataset for dense retrieval training, specifically tailored for the Spanish legal and administrative language domain. It contains hard negative samples automatically generated from original query-passage pairs, which are semantically similar to the query but do not contain the correct answer, helping to improve the robustness and ranking performance of retrieval models. The dataset is divided into two configurations: the training configuration provides multi-negative sample training data, including queries, one positive passage, multiple hard negative passages, along with training stages and difficulty labels; the evaluation configuration provides triple data for retrieval model evaluation, including queries, passage candidates and reference answers. The dataset supports multiple difficulty levels (high school, university, doctoral) to facilitate curriculum learning and model generalization. The generation process is based on SentenceTransformers and FAISS similarity search, using the Qwen3-Embedding-0.6B embedding model to automatically mine hard negative samples. This dataset aims to improve the development of Spanish legal encoders and promote public access to legal information.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-legal-administrative-triplets 数据集图片
构建方式
在西班牙语法律与行政领域,稠密检索模型的训练亟需蕴含精细语义区分的难负例样本。该数据集依托ALIA项目,从已有的法律行政问答对出发,采用基于SentenceTransformers的难负例挖掘流水线,借助Qwen3-Embedding-0.6B模型编码查询与段落,并以FAISS构建相似性索引,检索语义邻近却非正确答案的段落。挖掘过程施加相似度过滤约束,通过两阶段采样策略分别随机选取和精选最相似负例,每个查询配以多个难负例,最终生成训练与评估两种配置的数据。
特点
数据集以西班牙语法律行政文本为对象,聚焦于稠密检索任务中的难负例训练与评估。训练配置提供查询、正例及多个自动挖掘的难负例,并标注训练阶段与难度等级;评估配置则以查询-段落-答案三元组形式呈现,附带来源、角色和难度等元数据。难度分级涵盖中学、大学和博士层次,分别对应语言复杂度、术语专门性与推理深度的递增,为难负例的区分提供了可控的挑战梯度。全部数据源自公开法律文档,经敏感信息过滤,规模达十万至百万量级,呈现实用性与领域适应性。
使用方法
该数据集可通过HuggingFace datasets库便捷加载,分别获取hard-negatives和evaluation两种配置。训练配置适用于对比学习或排序损失训练,用户可提取查询、正例与多个负例,构建适用于SentenceTransformers稠密检索器、双编码器或RAG检索器的训练样本。评估配置则用于检索模型排序质量评测,以查询、段落和参考答案三元组评估段落与查询的相关性,并支持按难度、来源等元数据分层分析。使用中可利用多难度级别实施课程学习策略,逐步提升模型鲁棒性,同时应注意数据源于自动生成且风格较为同质,需结合实际场景审慎应用。
背景与挑战
背景概述
在西班牙语法律与行政领域,信息检索长期面临语义鸿沟与专业术语密集的困境,传统稀疏检索难以捕捉查询与判例、法规条款之间的深层语义关联。为应对这一挑战,SINAI研究团队于2026年在ALIA项目框架下构建了ALIA-es-legal-administrative-triplets数据集,旨在为稠密检索模型提供高质量的硬负例训练资源。该数据集衍生自ALIA项目中的法律行政查询-段落对,借助嵌入相似度挖掘技术自动生成语义相近但非正确答案的困难负例,助力模型习得细粒度语义区分能力,从而提升西班牙语法律行政领域的检索鲁棒性与排序精度。
当前挑战
该数据集所应对的核心领域问题在于法律行政检索中高度专业化查询与冗余、近似段落之间的精确匹配,这要求模型具备识别微妙语义差异的能力。构建过程中的主要挑战包括:硬负例挖掘需在语义相似性与答案错误性之间取得精妙平衡,参数设置不当易引入假阴性或过度简单的负例;原始文档结构复杂,自动处理可能导致层级信息丢失;生成模型固有的偏见与行政语言的同质化倾向可能削弱数据多样性;此外,多难度层级(高中、大学、博士)的划分虽提升了泛化潜力,却也增加了标注与验证的复杂度。
常用场景
经典使用场景
在西班牙语法律与行政领域的稠密检索模型训练中,该数据集凭借其精心构建的困难负例三元组结构,成为对比学习与排序损失优化的核心资源。每一查询均配有一个正例段落以及多个由嵌入相似度挖掘自动生成的困难负例段落,使得模型能够在训练过程中学习区分语义高度相近但答案正确性迥异的文本片段。这种多负例配置尤其适用于句子转换器稠密检索器、双编码器检索模型以及检索增强生成系统中的检索模块训练,从而显著提升模型对法律行政文本细粒度语义差异的敏感度。
衍生相关工作
该数据集衍生了一系列围绕西班牙语法律稠密检索的经典工作,包括基于课程学习的嵌入模型微调策略、多负例对比损失函数的改进以及法律领域检索基准的构建与评估。其困难负例挖掘流程所采用的句子转换器结合FAISS相似度搜索与Qwen3-Embedding-0.6B模型的范式,为后续领域自适应检索研究提供了可复用的技术路径。相关衍生工作还涉及法律文本的结构化信息抽取、跨文档指代消解以及检索增强生成系统在法律咨询中的落地探索,持续推动着西班牙语法律自然语言处理生态的繁荣与发展。
数据集最近研究
最新研究方向
在西班牙语法律与行政领域的密集检索研究中,ALIA-es-legal-administrative-triplets数据集的最新研究方向聚焦于利用难负例挖掘提升嵌入模型的细粒度语义区分能力。该数据集通过基于SentenceTransformers与FAISS的自动挖掘流程,结合Qwen3-Embedding-0.6B模型,为每个查询生成多个语义相近但非正确的负例,从而支持对比学习与排序损失训练。这一方向与当前检索增强生成(RAG)系统对鲁棒检索器的需求紧密相连,亦回应了法律行政领域对高质量西班牙语语义检索的迫切需求。其影响在于推动法律信息获取的公平性与准确性,助力公民更高效地理解行政程序,同时为多难度层级下的课程学习策略提供数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

