
遇见数据集

Shaer-AI/shaer-eval-raw-ashaar-model-300-split

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是一个用于评估AI模型在诗歌生成任务中表现的数据集,重点关注阿拉伯语诗歌(ashaar)的生成和评估。数据集包含多个特征字段,如生成ID、模型信息(模型名称、显示名称、ID、组别和角色)、文本内容(参考前缀、参考完成、生成文本等)、评估指标(如流畅度得分、连贯性得分、诗歌性得分、描述依从性得分)和韵律相关数据(如基本韵律、形式、韵律标签、韵律评估状态)。此外,数据集还包含健康状态、解码配置和时间戳等元数据。数据以测试分割形式提供,包含300个示例,用于分析和比较不同模型在诗歌生成任务中的性能,特别是韵律遵守和文本质量方面。

This dataset is designed to evaluate the performance of AI models in poetry generation tasks, with a primary focus on the generation and evaluation of Arabic poetry (ashaar). It includes multiple feature fields, such as generation ID, model information (including model name, display name, ID, group and role), text content (including reference prefix, reference completion, generated text, etc.), evaluation metrics (e.g., fluency score, coherence score, poeticity score, and description adherence score), as well as prosody-related data (such as basic prosody, form, prosody label, and prosody evaluation status). Additionally, the dataset also contains metadata including health status, decoding configuration and timestamps. The data is provided as a test split containing 300 examples, which are used to analyze and compare the performance of different models in poetry generation tasks, especially in terms of prosody compliance and text quality.
提供机构:
Shaer-AI
搜集汇总
数据集介绍
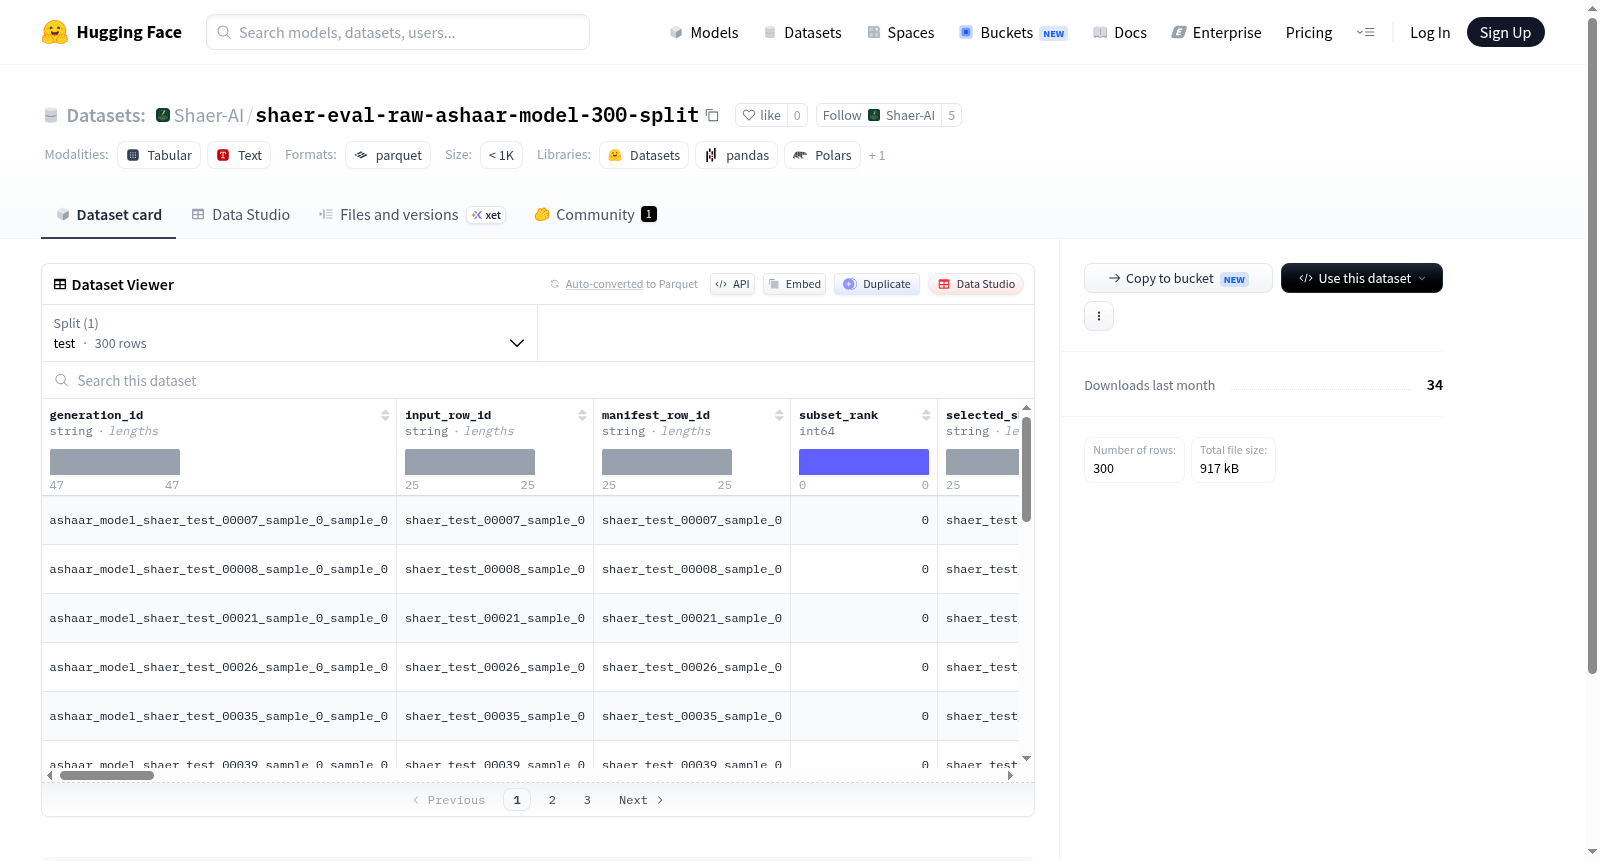
Shaer-AI/shaer-eval-raw-ashaar-model-300-split 数据集图片
构建方式
该数据集名为shaer-eval-raw-ashaar-model-300-split,以阿拉伯诗歌生成与评估研究为背景,基于SHAER模型在300个测试样本上的生成结果进行构建。每个样本均包含诗歌生成任务中的多种关键元数据,如模型标识(model_name, model_id, model_group)、生成状态(generation_status)、健康状态(health_status)以及解码配置(decode_config)。此外,数据还记录了参考诗歌的完整信息(reference_prefix_text, reference_remaining_completion, reference_completion),并提供了模型生成的原始文本(raw_generated_text)与清洗后文本(generated_text)。所有样本均经过阿斯哈(Ashaar)标准化处理(ashaar_generated_text_normalized),并保留标准化方法与状态。数据集的划分仅包含测试集(test),共300个示例,总大小约2.6MB。
特点
该数据集的核心特点在于其多维度的诗歌质量评估指标体系。除了基础的计数遵循度(count_adherence)和韵律评估(meter)外,还纳入了流利度(fluency_score)、连贯性(coherence_score)、诗意度(poeticness_score)以及描述遵循度(description_adherence_score)等细粒度分数。韵律评估尤为详尽,包括预测韵律类型(meter_predicted)、目标韵律(meter_target_used)、置信度(meter_confidence)、有效贝特数(meter_num_valid_bayts)以及韵律详情JSON(meter_details_json)。此外,数据集提供了增强描述(enhanced_description)与完整诗歌(full_poem)字段,便于研究者进行内容层面的深入分析。这些特性使得该数据集不仅适用于模型生成质量的自动评估,还可用于诗歌风格、韵律规律与语义贴合度的多维度研究。
使用方法
该数据集可通过HuggingFace Datasets库直接加载,使用默认配置(config_name: default)读取测试集数据。用户可依据generation_id、input_row_id等标识字段进行样本定位与筛选。研究者在进行诗歌生成模型评估时,可借助count_eval_status与meter_eval_status字段判断基础指标的评估状态,并结合流利度、连贯性等分数进行综合打分。此外,通过分析model_name与model_group字段,可对不同模型或模型变体在诗歌生成任务上的表现进行对比。数据集还支持针对特定韵律类型(meter_label)或诗歌形式(form)的子集研究,为阿拉伯诗歌生成与评估领域提供标准化的评测基准。
背景与挑战
背景概述
在阿拉伯诗歌的数字化浪潮中,韵律与格律的自动评估成为自然语言处理领域的前沿课题。该数据集由阿拉伯诗歌智能生成与评估研究团队创建,旨在系统性地评测大语言模型在古典阿拉伯诗歌(Shaer)生成任务中的表现。核心研究问题聚焦于模型生成诗歌在格律(Meter)、韵律(Bayts)、行数一致性及文学性上的准确性。数据集收录了300个测试样本,每条样本均包含模型生成的诗歌文本、归一化后的版本、格律预测结果、流畅性及诗歌性评分等丰富标注。作为阿拉伯诗歌生成评估的重要基准,该数据集为跨模型比较提供了标准化框架,推动了计算诗学与文化计算领域的发展。
当前挑战
该数据集面临的核心挑战之一是古典阿拉伯诗歌格律系统的复杂性。古典阿拉伯诗歌具有16种基础格律,每种格律对音节长短(Bayts)及行数有严格约束,语言模型的输出经常出现格律偏离或行数不匹配的现象。构建过程中,研究者需处理模型输出不规范的问题,包括不完整诗句、冗余文本及格式混乱,这催生了复杂的健康状态检查与归一化流程。此外,如何通过自动化评估指标(如格律预测置信度、语义连贯性分数)忠实反映诗歌的文学品质而非仅停留于形式合规,仍是极具挑战的开放问题。
常用场景
经典使用场景
在阿拉伯诗歌生成与评估的前沿领域中,shaer-eval-raw-ashaar-model-300-split数据集扮演着关键角色。该数据集汇聚了300条由语言模型生成的诗歌样本,涵盖了从格律标记、音步计数到流畅度、连贯性与诗意性评分的多维评估指标。研究者常利用它来训练和测试诗歌生成模型,通过对比模型输出与人类参考文本的格律准确性和诗意一致性,全面衡量模型在古典阿拉伯诗歌创作上的效能。这一数据集为自动诗歌质量评估提供了标准化的测试基准,推动了生成式模型在严格格律约束下的创作能力探索。
解决学术问题
该数据集直面阿拉伯诗歌自动生成中评估体系缺失的学术困境。传统上,诗歌质量评判依赖人工专家,耗时且主观性强。通过提供包含格律遵守度、诗意评分及文本连贯性在内的结构化评估数据,数据集使研究者能够量化分析模型在保持古典格律(如al-Khalil式韵律)与诗歌语义表达间的平衡能力。它解决了如何客观衡量生成诗歌在形式规则与艺术美感上的双重达标问题,为跨语言诗歌生成研究贡献了稀缺的标注资源,并推动了对低资源语种生成质量的系统性评估方法发展。
衍生相关工作
该数据集衍生了多项经典工作,包括基于其格律标注信息开发的新型韵律检测模型,提升了稀有格律类型的识别精度。研究者还利用其多维度评分,训练了能够预测诗歌整体质量的评估回归器,实现了对生成文本的艺术性自动打分。此外,围绕该数据集出现了针对低资源语言生成模型的微调策略研究,探索如何在不破坏格律规则的前提下提升诗歌的创意性。这些工作共同促进了计算诗学领域的方法论革新,并为阿拉伯自然语言处理社区建立了可复用的评估基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

