
遇见数据集

cjvt/Wikipedia-translated

收藏
Hugging Face2026-07-20 更新2026-07-22 收录
官方服务:

资源简介:

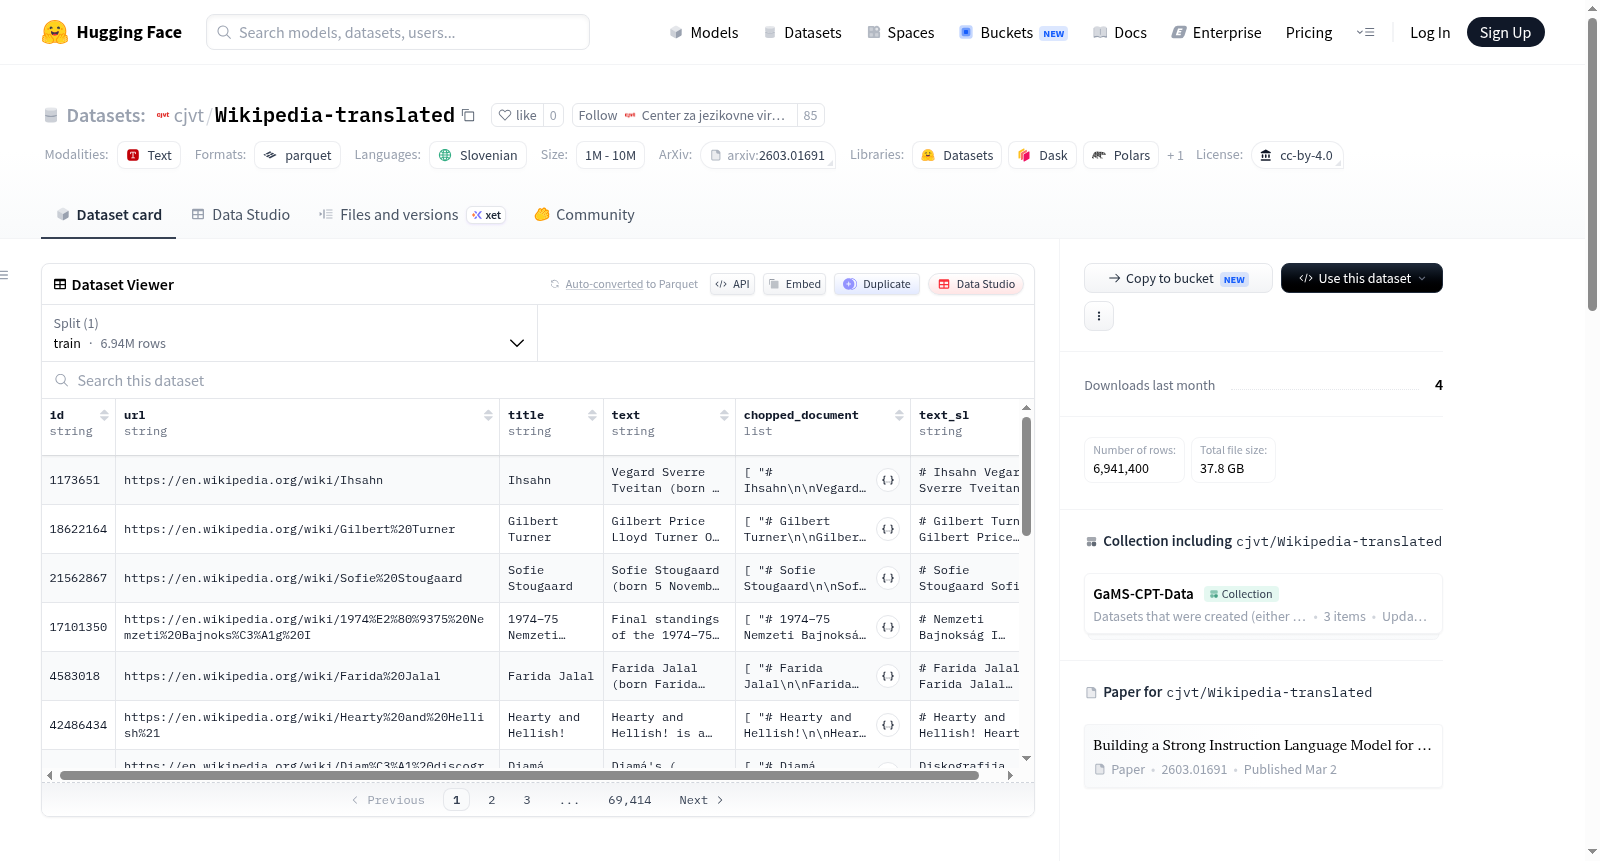
该数据集是斯洛文尼亚语翻译的英文维基百科,采用Markdown格式。英文原文数据来源于zidsi/wikipedia_markdown,使用的是2025年1月23日的版本。翻译使用了cjvt/GaMS-DPO-Translator模型。数据集包含约690万份文档,约36亿斯洛文尼亚语词汇。数据结构包括:id、url、title(英文原文标题)、text(英文原文内容)、chopped_document(适应翻译模型上下文窗口的小文本单元列表)和text_sl(斯洛文尼亚语译文)。数据集是PoVeJMo研究计划的一部分,由斯洛文尼亚研究与创新机构和NextGenerationEU资助,并遵循CC BY 4.0许可证。

This dataset is a Slovenian-translated corpus of English Wikipedia articles, formatted in Markdown. The original English source data is sourced from zidsi/wikipedia_markdown, using the version dated January 23, 2025. The translation was performed using the cjvt/GaMS-DPO-Translator model. The corpus contains approximately 6.9 million documents and around 3.6 billion Slovenian tokens. Its data structure includes: id, url, title (original English title), text (original English content), chopped_document (a list of small text chunks adapted to fit the context window of translation models), and text_sl (Slovenian translation of the content). This dataset is part of the PoVeJMo research program, funded by the Slovenian Research and Innovation Agency and NextGenerationEU, and is licensed under CC BY 4.0.
提供机构:
cjvt
搜集汇总
数据集介绍
cjvt/Wikipedia-translated 数据集图片
构建方式
Wikipedia-translated数据集源自2025年1月23日的英语维基百科快照,原始语料取自zidsi/wikipedia_markdown并以Markdown格式存储。针对英语文本,采用基于斯洛文尼亚语的cjvt/GaMS-DPO-Translator模型进行机器翻译,为确保翻译质量,较长的文档被切分为适应模型上下文窗口的小文本单元(chopped_document),逐块翻译后整合为完整的斯洛文尼亚语版本。该过程保留了原始文章的id、url、标题及英文章节结构,最终生成包含约690万篇文档的大规模平行语料。
特点
该数据集的核心特性在于其双语平行结构与大规模覆盖:每条记录同时包含英文原文(text)与斯洛文尼亚语译文(text_sl),并附有切分的翻译单元(chopped_document)以供细粒度分析。总文档数达694万,斯洛文尼亚语词汇量约为36亿词,显著丰富了低资源语言的可用数据。数据集采用CC BY 4.0许可开源,且基于权威维基百科内容,确保了文本的领域多样性和百科全书的广度,为跨语言自然语言处理任务奠定坚实基础。
使用方法
使用者可通过Hugging Face Datasets库加载默认配置,直接访问包含id、url、title、text、chopped_document及text_sl六个字段的完整数据。训练集已预划分为单一split,数据文件以parquet格式存储于data/train-*路径下。适合用于斯洛文尼亚语机器翻译模型的训练与评估、跨语言文本生成、双语词嵌入学习及零样本迁移学习等场景。推荐使用datasets.load_dataset('zidsi/wikipedia-translated')命令便捷调用,并依据需求选择原文或译文字段进行下游实验。
背景与挑战
背景概述
在大规模语言模型(LLM)训练的语料需求中,多语言资源的匮乏长期制约着低资源语言的自然语言处理(NLP)发展。斯洛文尼亚作为使用人数较少的语言,其高质量语料库尤为稀缺。为此,由卢布尔雅那大学等机构的研究团队于2025年创建了Wikipedia-translated数据集,该数据集基于2025年1月23日的英语维基百科快照,利用专为斯洛文尼亚语设计的翻译模型GaMS-DPO-Translator,将约694万篇英文文档自动翻译为斯洛文尼亚语,总词量达36亿。该数据集旨在为斯洛文尼亚语的大语言模型训练提供大规模、结构化的平行语料,支撑PoVeJMo研究计划及SloLLaMai项目。其发布填补了斯洛文尼亚语NLP领域在语料规模上的空白,为后续构建指令语言模型奠定了数据基础,对低资源语言的机器翻译和语言模型研究具有重要推动作用。
当前挑战
该数据集所应对的核心领域挑战在于低资源语言(如斯洛文尼亚语)在大型语言模型训练中面临的语料严重不足问题,传统上这些语言缺乏充足的数字化文本资源,难以支撑高性能NLP模型的开发。在构建过程中,团队需克服自动翻译的质量保障难题:由于使用了教师模型GaMS-DPO-Translator,翻译的准确性和自然度直接受限于该模型的能力,尤其对于技术性、文化特定或长文本内容,可能产生语义偏差或碎片化错误。此外,原始英语维基百科文档格式多样、长度不一,需将其切分为适配模型上下文窗口的小单元(chopped_document),这一分割策略需平衡内容完整性与模型输入限制,避免因断句不当导致上下文信息丢失。最后,数据集的规模(6.9百万文档、36亿词)对存储、处理及质量监控提出了工程性挑战,确保翻译一致性及数据清洗的自动化流程亦需精细设计。
常用场景
经典使用场景
在自然语言处理领域,跨语言语义对齐与知识迁移是核心挑战之一。Wikipedia-translated数据集作为斯洛文尼亚语与英语平行语料的典范,为低资源语言研究提供了宝贵资源。其最经典的使用场景在于构建机器翻译系统,通过英语原文与斯洛文尼亚语译文的对应关系,训练端到端的神经翻译模型。此外,该数据集也广泛用于跨语言信息检索,利用双语对齐文本提升查询与文档的语义匹配精度。同时,在跨语言文本分类和情感分析任务中,研究者可借助该数据集将英语预训练模型的知识迁移至斯洛文尼亚语,从而弥补目标语言标注语料的匮乏。这种基于大规模高质量平行语料的迁移学习范式,显著降低了低资源语言自然语言处理任务的开发门槛。
实际应用
在工业界与公共服务的数字化转型中,Wikipedia-translated数据集的实际应用价值尤为突出。斯洛文尼亚政府机构可利用该数据集训练本地化的语义搜索引擎,使公民能够以母语精准检索多语言知识库。媒体和出版公司能基于此构建自动内容本地化系统,快速将英语新闻或技术文档翻译为斯洛文尼亚语,从而降低人工翻译成本并缩短发布周期。教育科技领域亦受益于此,开发者能够打造跨语言的学习辅助工具,例如为斯洛文尼亚语学生提供英文文献的智能摘要与自动翻译服务。此外,该数据集还支撑着面向斯洛文尼亚语的语音助手和聊天机器人开发,通过双语对齐数据增强模型对口语化表达的理解能力,最终提升用户体验。
衍生相关工作
Wikipedia-translated数据集的问世催生了多个方向的前沿工作。基于其双语平行特性,研究者衍生出针对斯洛文尼亚语的指令微调数据集,例如通过自动翻译英文指令库来构建斯洛文尼亚语大语言模型的训练数据,相关成果已发表于预印本(如Vreš等人2026年的工作)。该数据集还被用于跨语言知识蒸馏研究,将英语大模型的知识通过教师-学生架构迁移至斯洛文尼亚语小模型,显著压缩模型规模同时保持性能。在少样本学习领域,有工作利用该数据集的篇章级对齐特性,设计出跨语言提示学习方法,仅需少量目标语言样本即可完成新任务适配。此外,该数据集也成为评估斯洛文尼亚语文本生成质量的基准,驱动了针对小语种的翻译评估指标研发。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

