
github_fetch_huggingface_terminal_9070_177pn9_source_customer_support
收藏数据链接:
官方服务:
资源简介:
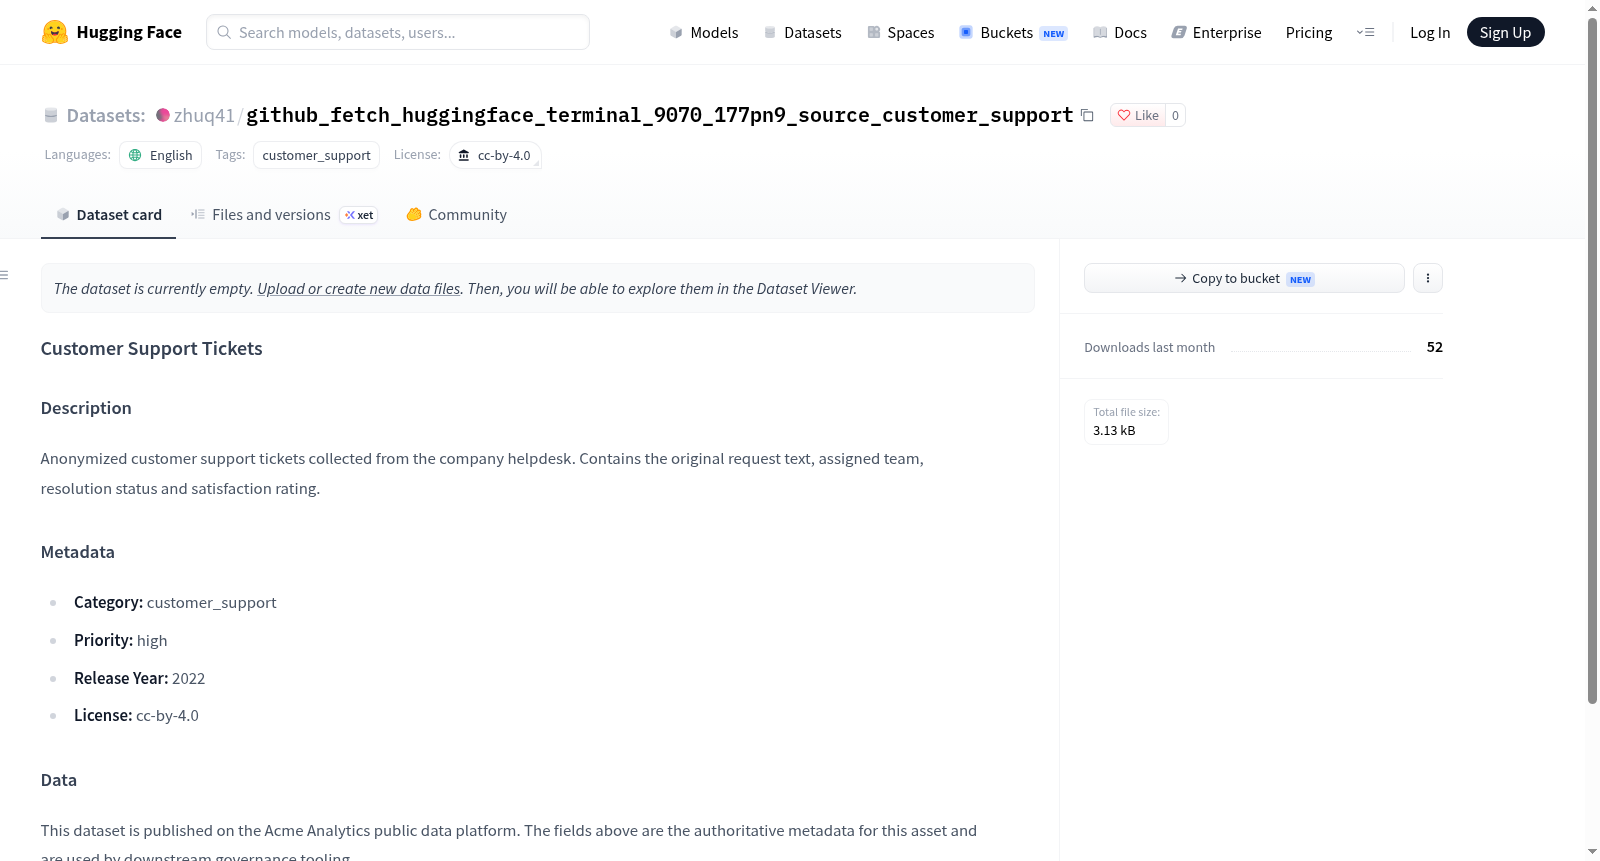
该数据集名为“客户支持工单”(Customer Support Tickets),收集自公司帮助台的匿名客户支持工单。每条工单包含原始请求文本、分配团队、解决状态和满意度评分。数据集发布于2022年,采用CC-BY-4.0许可证,语言为英文,标签为“customer_support”,优先级为高。该数据集适用于客户支持分析、文本分类、情感分析、工单自动分配、满意度预测等任务。
Customer Support Tickets dataset, collected from anonymous customer support tickets from a companys help desk. Each ticket includes the original request text, assigned team, resolution status, and satisfaction rating. Published in 2022, under CC-BY-4.0 license, language English, tag customer_support, priority high. Suitable for tasks like customer support analysis, text classification, sentiment analysis, ticket routing, satisfaction prediction.
创建时间:
2026-08-22
原始信息汇总
数据集概述
该数据集为客户支持工单数据集,内容来源于公司帮助台的匿名化客户支持工单记录。
基本信息
| 属性 | 内容 |
|---|---|
| 语言 | 英语 |
| 类别 | 客户支持(customer_support) |
| 优先级 | 高 |
| 发布年份 | 2022年 |
| 许可证 | CC-BY-4.0 |
数据内容
数据包含以下字段:
- 原始请求文本:客户提交的原始支持请求内容
- 分配团队:负责处理工单的团队
- 解决状态:工单的最终处理状态
- 满意度评分:客户对处理的满意度评价
数据说明
- 数据已进行匿名化处理,确保客户隐私安全
- 数据集发布在Acme Analytics公共数据平台上
- 上述字段为该数据资产的权威元数据,供下游治理工具使用
搜集汇总
数据集介绍
构建方式
在客户支持服务领域,工单数据的系统化采集对于提升响应效率与服务质量具有关键意义。该数据集源自企业帮助台的匿名化客户支持工单,经过去标识化处理以保护用户隐私,保留了原始请求文本、所分配团队、解决状态与满意度评分等核心字段。数据经由内部治理工具链标准化后,发布于Acme Analytics公共数据平台,确保字段元数据的权威性与一致性,从而为后续的分析建模提供可靠基础。
特点
该数据集聚焦于客户支持场景,涵盖工单请求的原始语义信息及其处理流程中的多维度标签,包括团队分配、解决状态和满意度评分,能够反映服务链条中的真实交互形态。数据经过匿名化处理,兼顾隐私安全与信息价值;同时,其元数据经平台治理工具确认,具有高优先级与明确的发布年份标识,适用于服务质量评估、工单分类及满意度预测等研究任务。
使用方法
使用该数据集时,研究者可基于原始请求文本进行自然语言处理任务,如意图识别、主题分类或情感分析;结合团队分配与解决状态字段,可构建工单路由优化或处理时长预测模型;满意度评分则可用于评估服务效果或训练用户反馈预测器。数据以cc-by-4.0许可发布,使用时应遵循许可条款,并注意其来源于特定企业帮助台,在跨领域应用时需评估泛化性。
背景与挑战
背景概述
客户支持工单数据集github_fetch_huggingface_terminal_9070_177pn9_source_customer_support于2022年发布,源自Acme Analytics公共数据平台,汇集企业帮助台匿名化客户支持工单,涵盖原始请求文本、指派团队、解决状态及满意度评分等字段。该数据集面向智能客服、工单分类、服务质量管理与客户满意度预测等研究方向,为自然语言处理技术在企业服务场景中的落地提供了真实语料基础。通过cc-by-4.0许可开放共享,该资源在学术研究与产业应用之间架设桥梁,推动了客户支持领域数据驱动方法的可复现研究,对服务运营优化与人机协同客服系统的构建具有参考价值。
当前挑战
该数据集所服务的客户支持领域长期面临工单类别不均衡、多团队协作语义模糊、解决状态标注主观性强等固有难题,原始请求文本的口语化、拼写错误与多语言混杂进一步加剧了自动分类与信息抽取的困难。在构建层面,匿名化处理需在去除个人身份信息与保留语义完整性之间取得平衡,满意度评分可能存在用户主观偏差与缺失值,跨团队标签体系的一致性亦有待保障。这些因素共同制约了模型在真实工单环境中的泛化能力与公平性评估,对数据治理、隐私保护技术与鲁棒建模方法提出了持续性挑战。
常用场景
经典使用场景
在客户支持服务领域,工单文本的自动分类与优先级排序是提升响应效率的核心环节。该数据集汇集了经匿名化处理的原始客户请求文本、所属团队、解决状态及满意度评分,为训练工单路由模型与情感分析模型提供了基准语料。研究者可基于请求文本预测其应归属的支持团队,或依据历史满意度评分构建用户情绪识别与服务质量评估模型,从而在模拟环境中复现真实客服工作流的分流与反馈机制。
解决学术问题
该数据集有效缓解了客户支持领域公开标注语料稀缺的困境,为文本分类、意图识别与满意度预测等任务提供了带有真实业务标签的实证数据。其学术意义在于支撑监督学习模型在非平衡类别与短文本场景下的鲁棒性检验,并使得跨团队协作效率的量化分析成为可能。通过关联解决状态与满意度评分,研究者得以探究响应策略与用户感知之间的统计关系,为服务计算与人机交互研究提供可复现的实验基础。
衍生相关工作
围绕该数据集,后续研究衍生出多项经典工作,包括基于预训练语言模型的工单意图分类器、融合元数据的多任务满意度预测框架,以及面向客服对话的迁移学习基准。部分工作进一步将其与公开的客服对话语料进行联合训练,探索跨域知识迁移。这些衍生研究在文本分类、情感计算与服务运筹等方向形成可复用的评测协议,推动了客户支持领域数据驱动方法的标准化进程。
以上内容由遇见数据集搜集并总结生成


