electricsheepeurope/europe-ilo-ees-tees-sex-age-edu-nb-employees-by-sex-age-and-education-thousands
收藏资源简介:
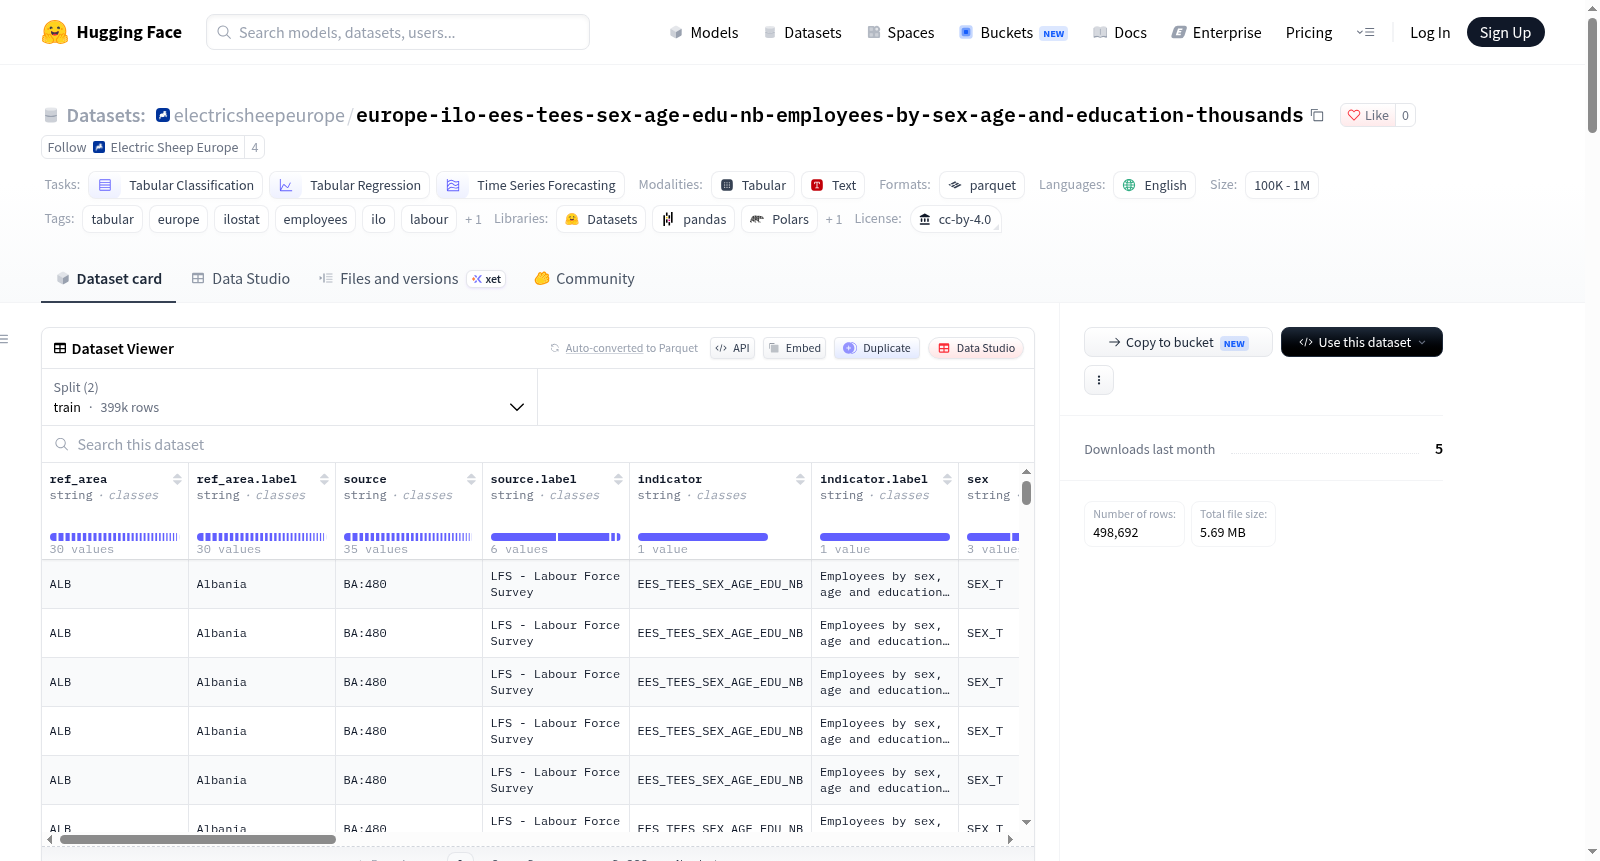
该数据集名为“按性别、年龄和教育程度划分的雇员(千人)| 欧洲(ILOSTAT)”,是一个表格型数据集,专注于欧洲地区的劳动力统计。它包含498,692条观察数据,覆盖39个欧洲国家,时间跨度为1987年至2025年。数据集的核心指标是“EES_TEES_SEX_AGE_EDU_NB”,即按性别、年龄和教育程度划分的雇员数量(以千人为单位)。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,该数据库是全球劳动力统计的主要来源,通过国家劳动力调查、家庭收入调查、机构调查和行政记录等收集数据。数据集经过Electric Sheep Europe重新打包,以Parquet格式发布,便于机器学习使用。数据结构包括国家代码、国家名称、数据来源、指标代码、性别分类(总计、男性、女性)、年龄和教育程度分类、观察年份、观察值(雇员数量)、观察状态标志以及相关注释列。数据按年度频率提供,并经过ILO的标准化处理,以确保一致性和可比性。数据集可用于表格分类、回归和时间序列预测等任务,适用于劳动力市场分析、经济研究和社会政策评估。
This dataset, titled "Employees by Sex, Age and Educational Attainment (Thousand Persons) | Europe (ILOSTAT)", is a tabular dataset focused on European regional labor statistics. It contains 498,692 observations spanning 39 European countries over the period from 1987 to 2025. The core indicator of this dataset is "EES_TEES_SEX_AGE_EDU_NB", which refers to the number of employees classified by sex, age and educational attainment, measured in thousand persons. The data is sourced from the ILOSTAT database of the International Labour Organization (ILO), a premier global source of labor statistics that collects data through national labor force surveys, household income surveys, establishment surveys and administrative records. This dataset was repackaged by Electric Sheep Europe and released in Parquet format to facilitate machine learning applications. The dataset's structure includes country code, country name, data source, indicator code, sex classifications (total, male, female), age and educational attainment categories, observation year, observed value (employee count), observation status flag, and relevant annotation columns. The data is provided at an annual frequency and has undergone standardization processing by the ILO to ensure consistency and cross-country comparability. It can be utilized for tasks including tabular classification, regression and time series forecasting, and is applicable to labor market analysis, economic research and social policy assessment.